主汇报指标
直接看 agent 的可行解离 O 奖参照解有多近。100% 就是平均达到 O 奖复现答案的 raw 水平,超过的部分现在会封顶。
Agentic and Verifiable Benchmark for Mathematical Modeling
一个面向数学建模长程任务的 Terminal-Bench 风格评测:统一终端环境、完整 agent workflow、可执行结果文件和可复核评价指标。
它把“会不会写一篇看起来合理的建模报告”推进到“能不能在标准环境里完成建模、编程、求解、验证和提交结构化结果”。这种形式适合评测真实问题求解能力,也可以进一步作为强化学习环境使用。
关注知乎专栏,继续看最新进展、详细解读和后续拆题。

18 道 2023-2025 年 CUMCM 与 MCM 题目,每道题都要求 agent 在终端环境中产出结构化结果,并接受自动化 verifier 复核。
/root/results/*_result.json,让评测可复核。
主榜。三个条目都是 文本+图像 多模态配置,可以打开题目随附的官方插图(7 道题带图,共 21 张裁切图)。它们用同一套 verifier、同一批 18 道题,所以与后面的纯文本榜可直接对照。成本统一按 OpenRouter 目录价(美元) 计算。第 3 个条目是思考档位对照:同一模型(DeepSeek V4.1 Flash)配同一 opencode CLI,只把 thinking 档位从默认 high 提到 max,用来直接观察提高思考预算是否换来更好成绩。
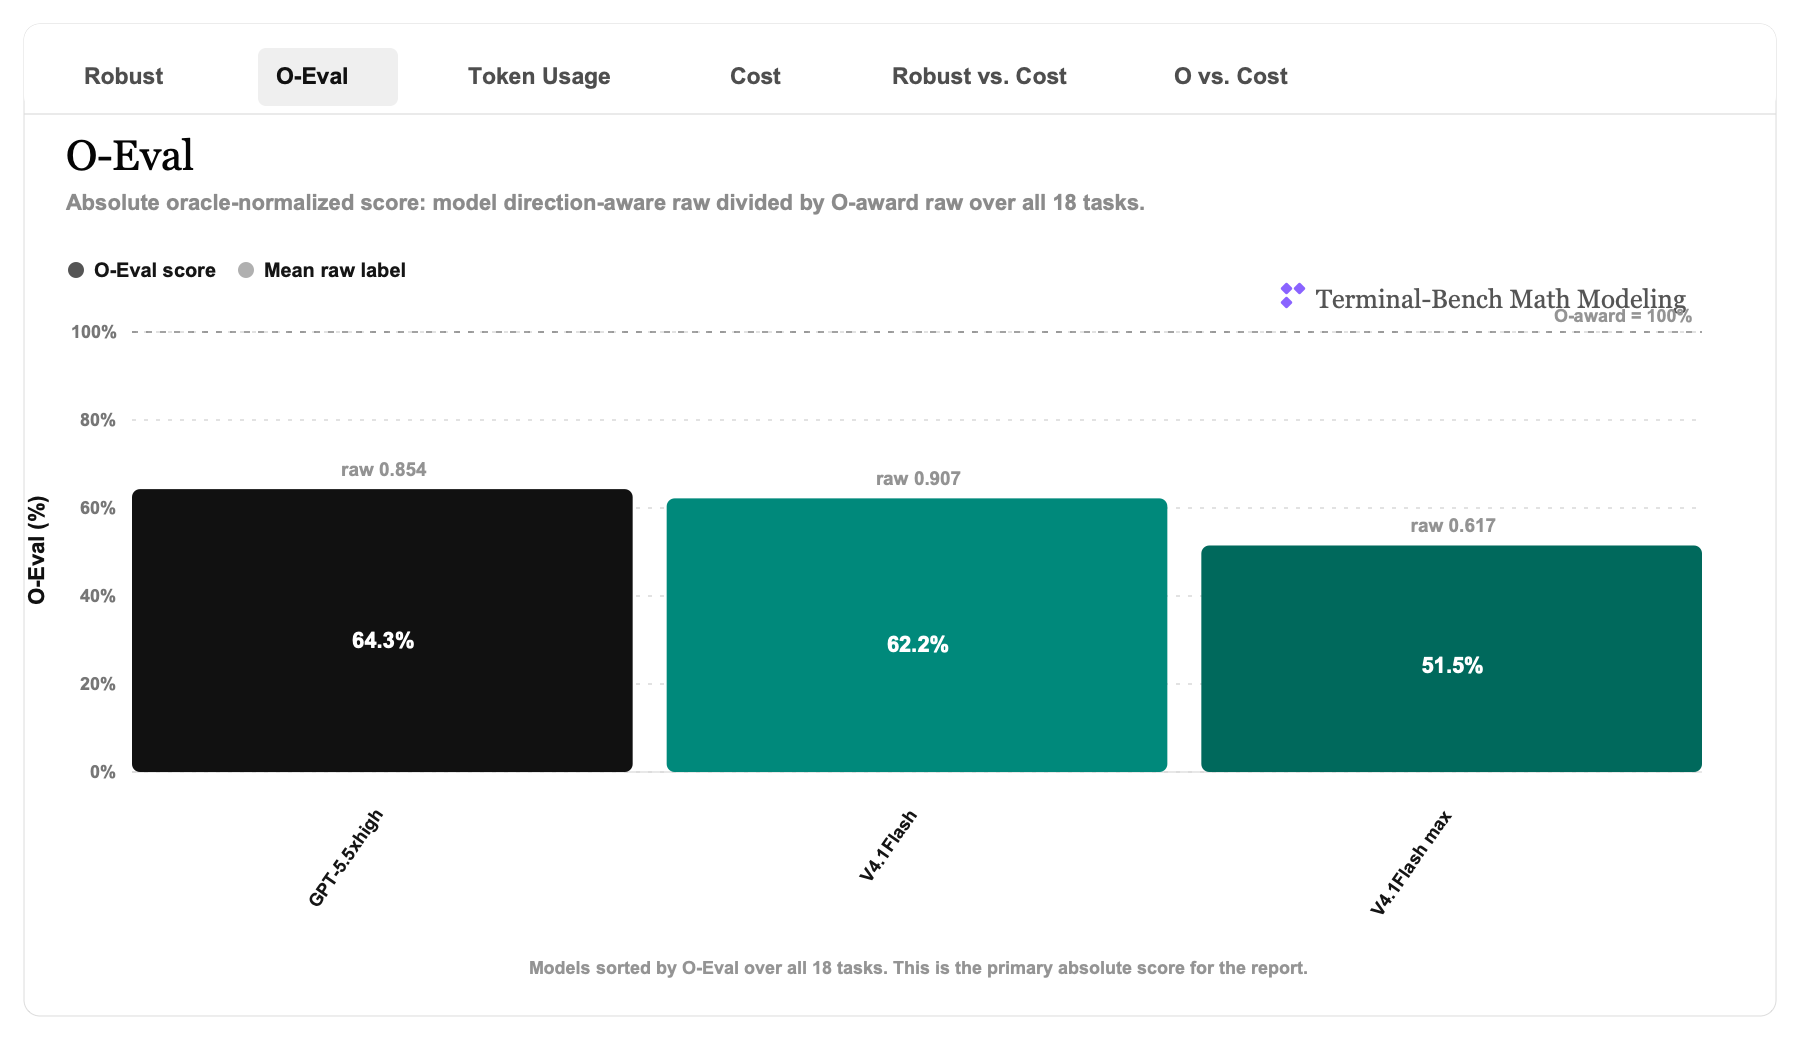
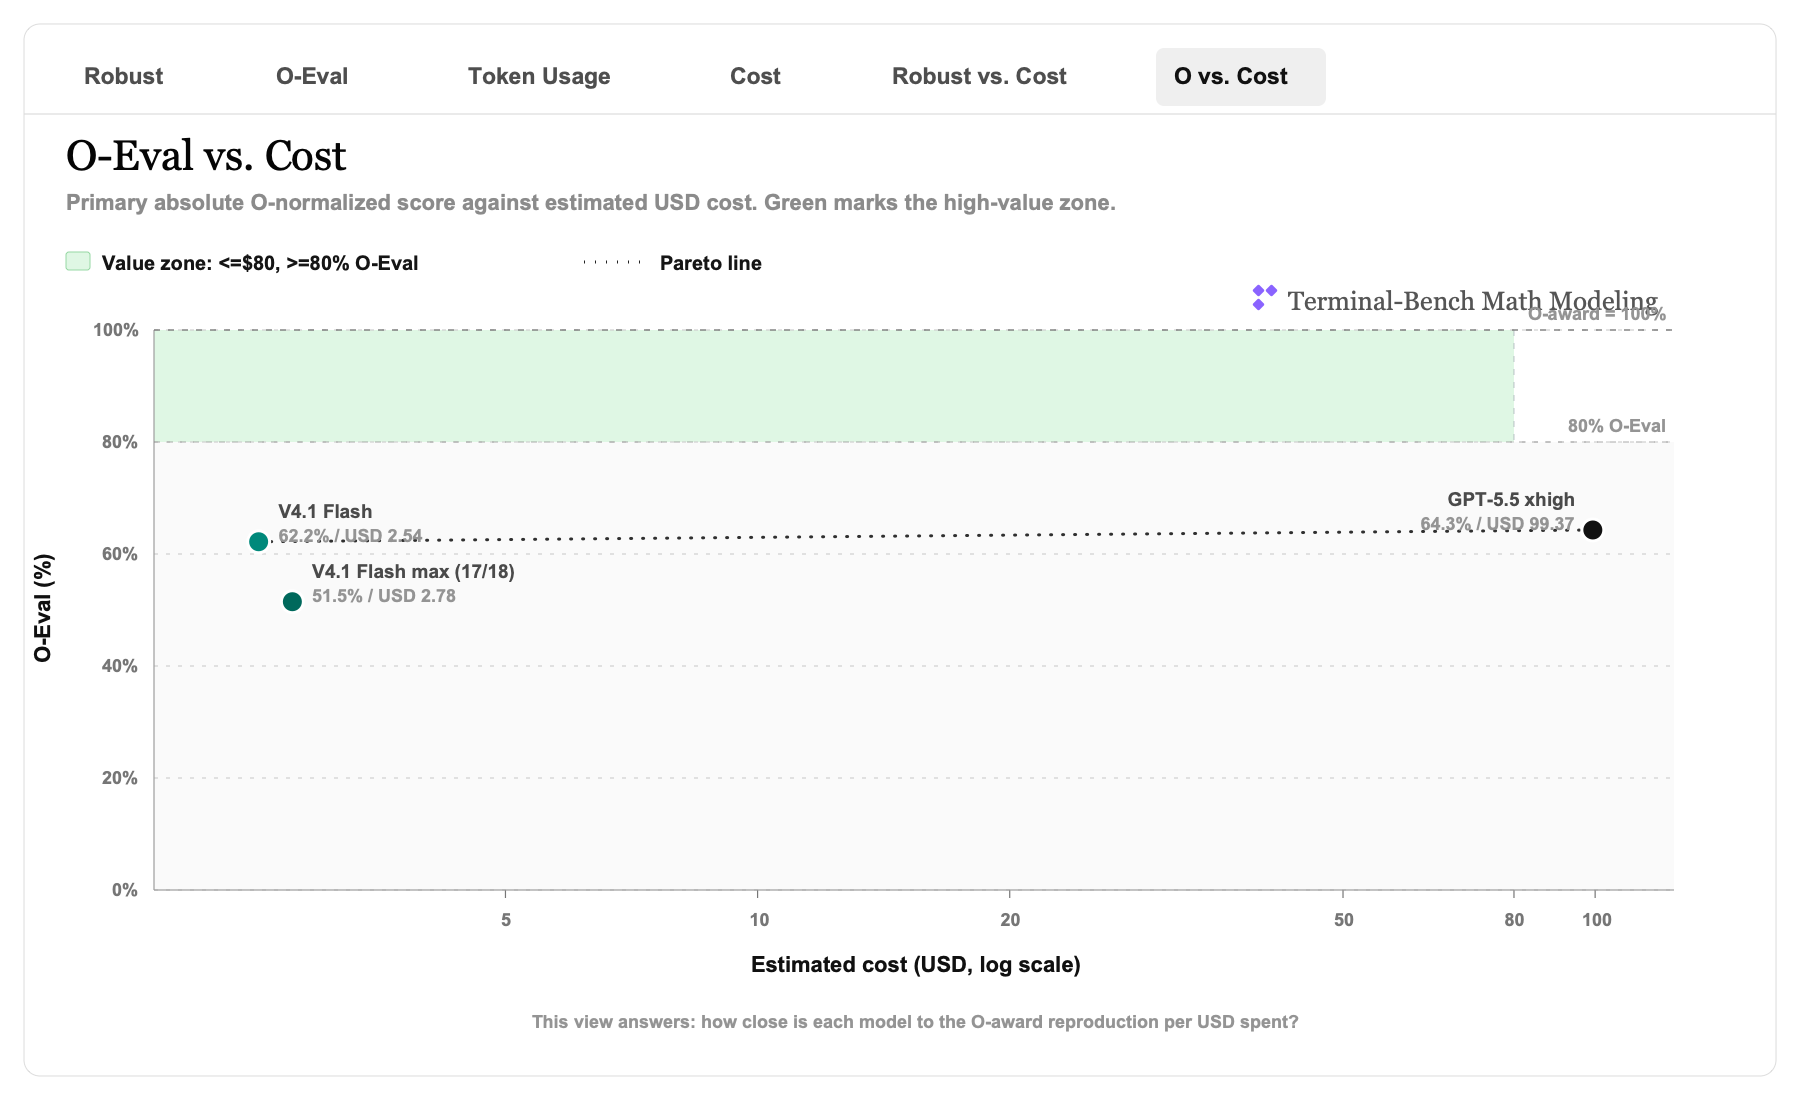
O-Eval 是相对 O 奖参照解的绝对完成度(100% = 平均达到 O 奖复现答案的 raw 水平,超出部分封顶)。codex 与 opencode(high) 分数几乎持平,但成本相差约 39 倍;而 opencode(max) 分数反而低于它的 high 档(51.48% vs 62.19%),成本却更高(按下述计费口径)。
| Model | Artifacts | O-Eval | Robust BO-Eval | Cost USD | Cost RMB | Status |
|---|---|---|---|---|---|---|
1codex + GPT-5.5 xhighOpenAI GPT-5.5(text+image->text),reasoning_effort=xhigh,codex CLI。全 18 题均产出可评分结果,0 hard gate。 |
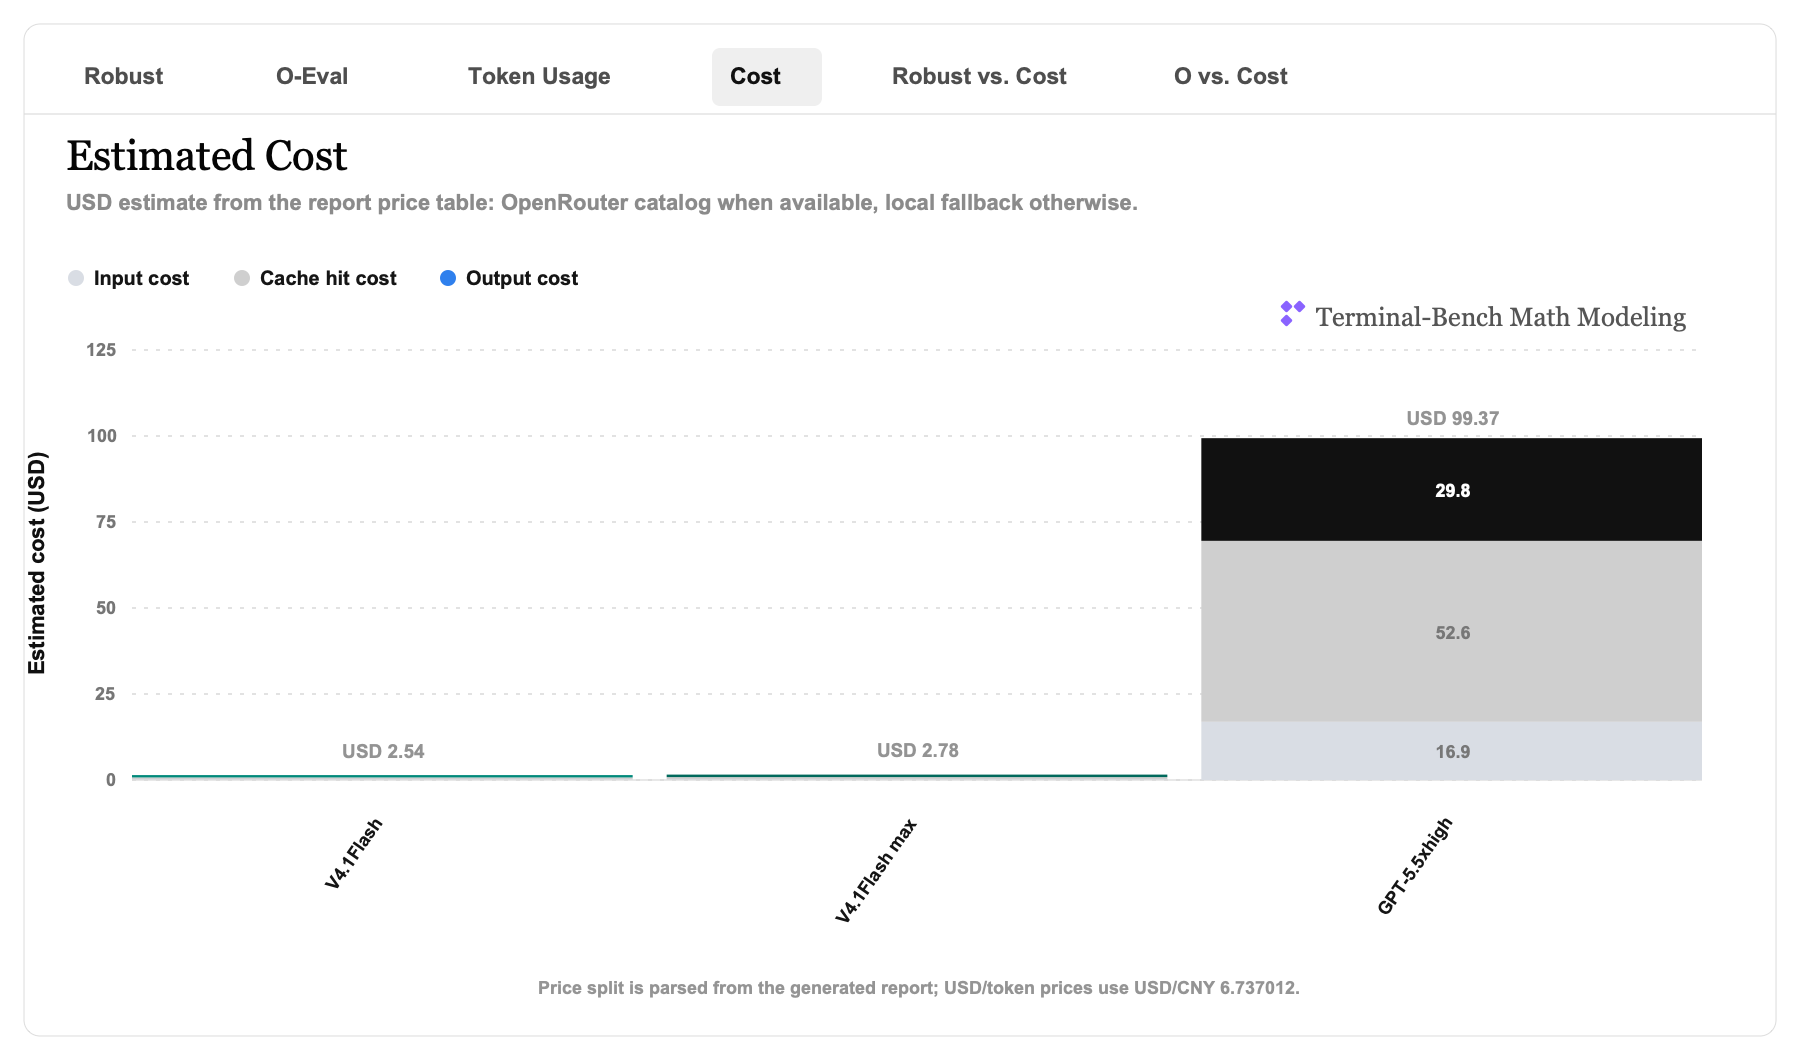
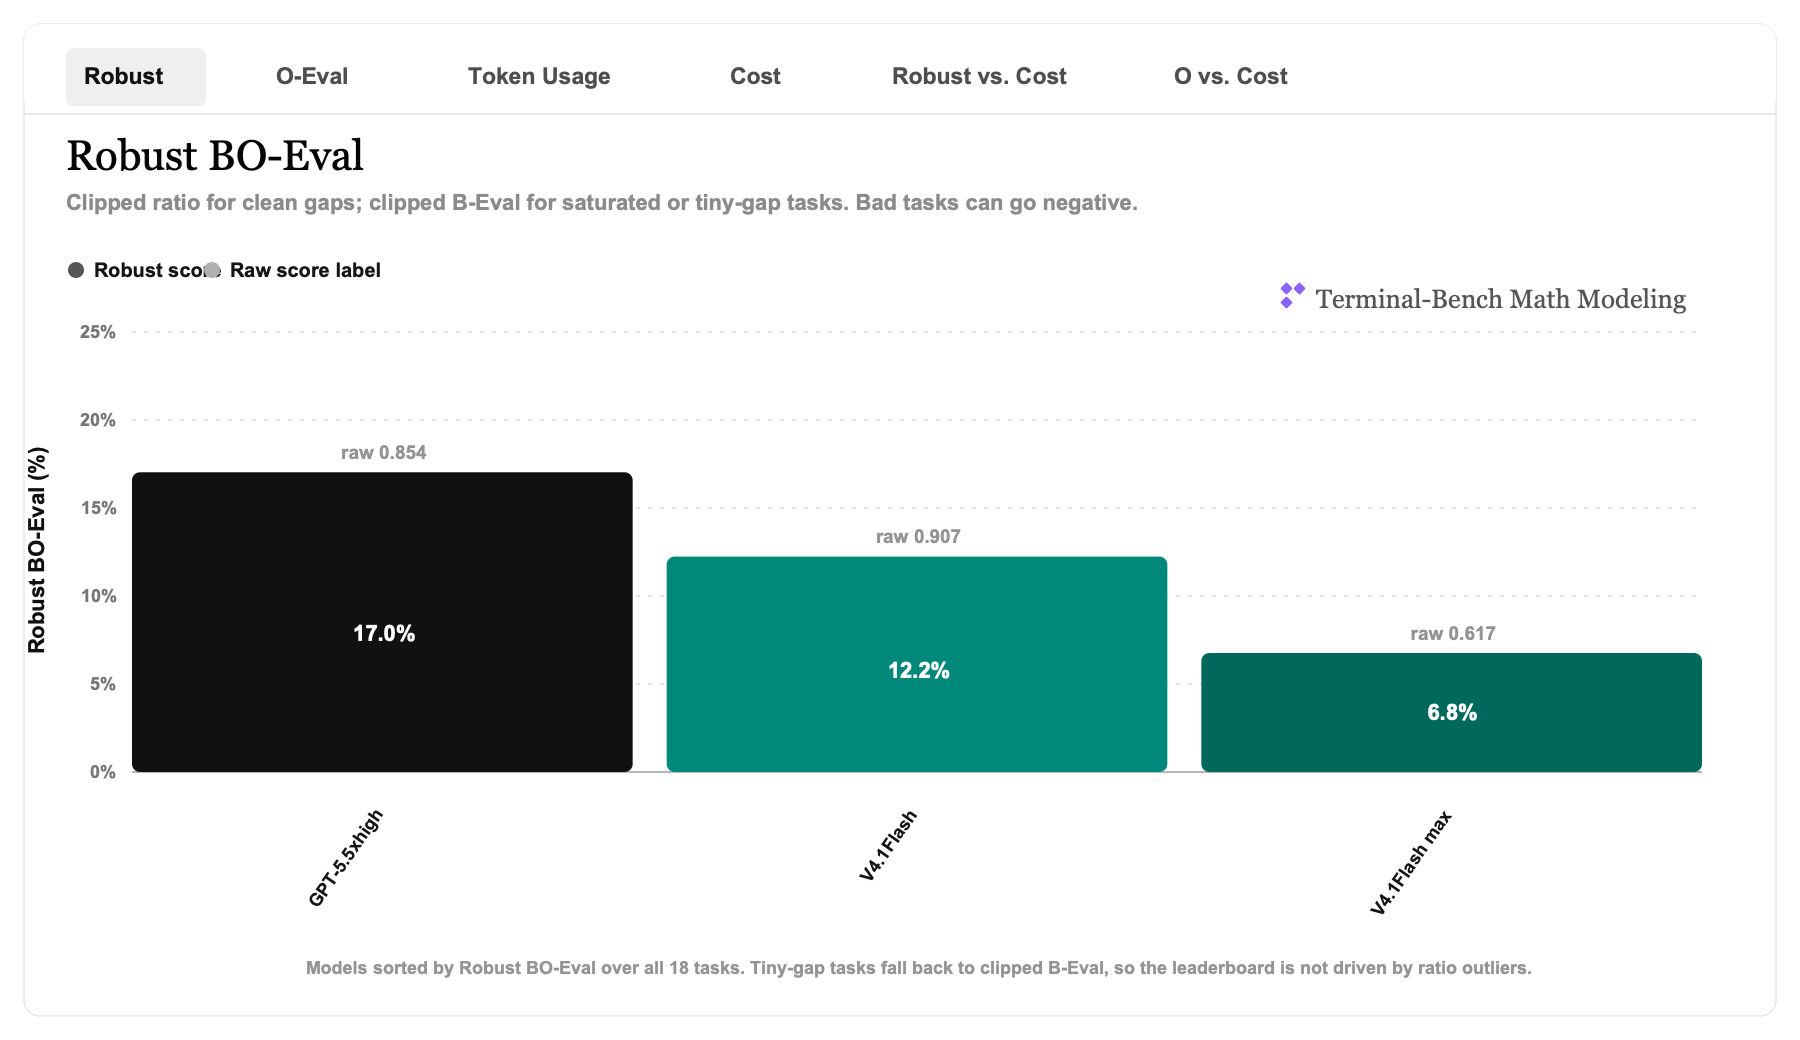
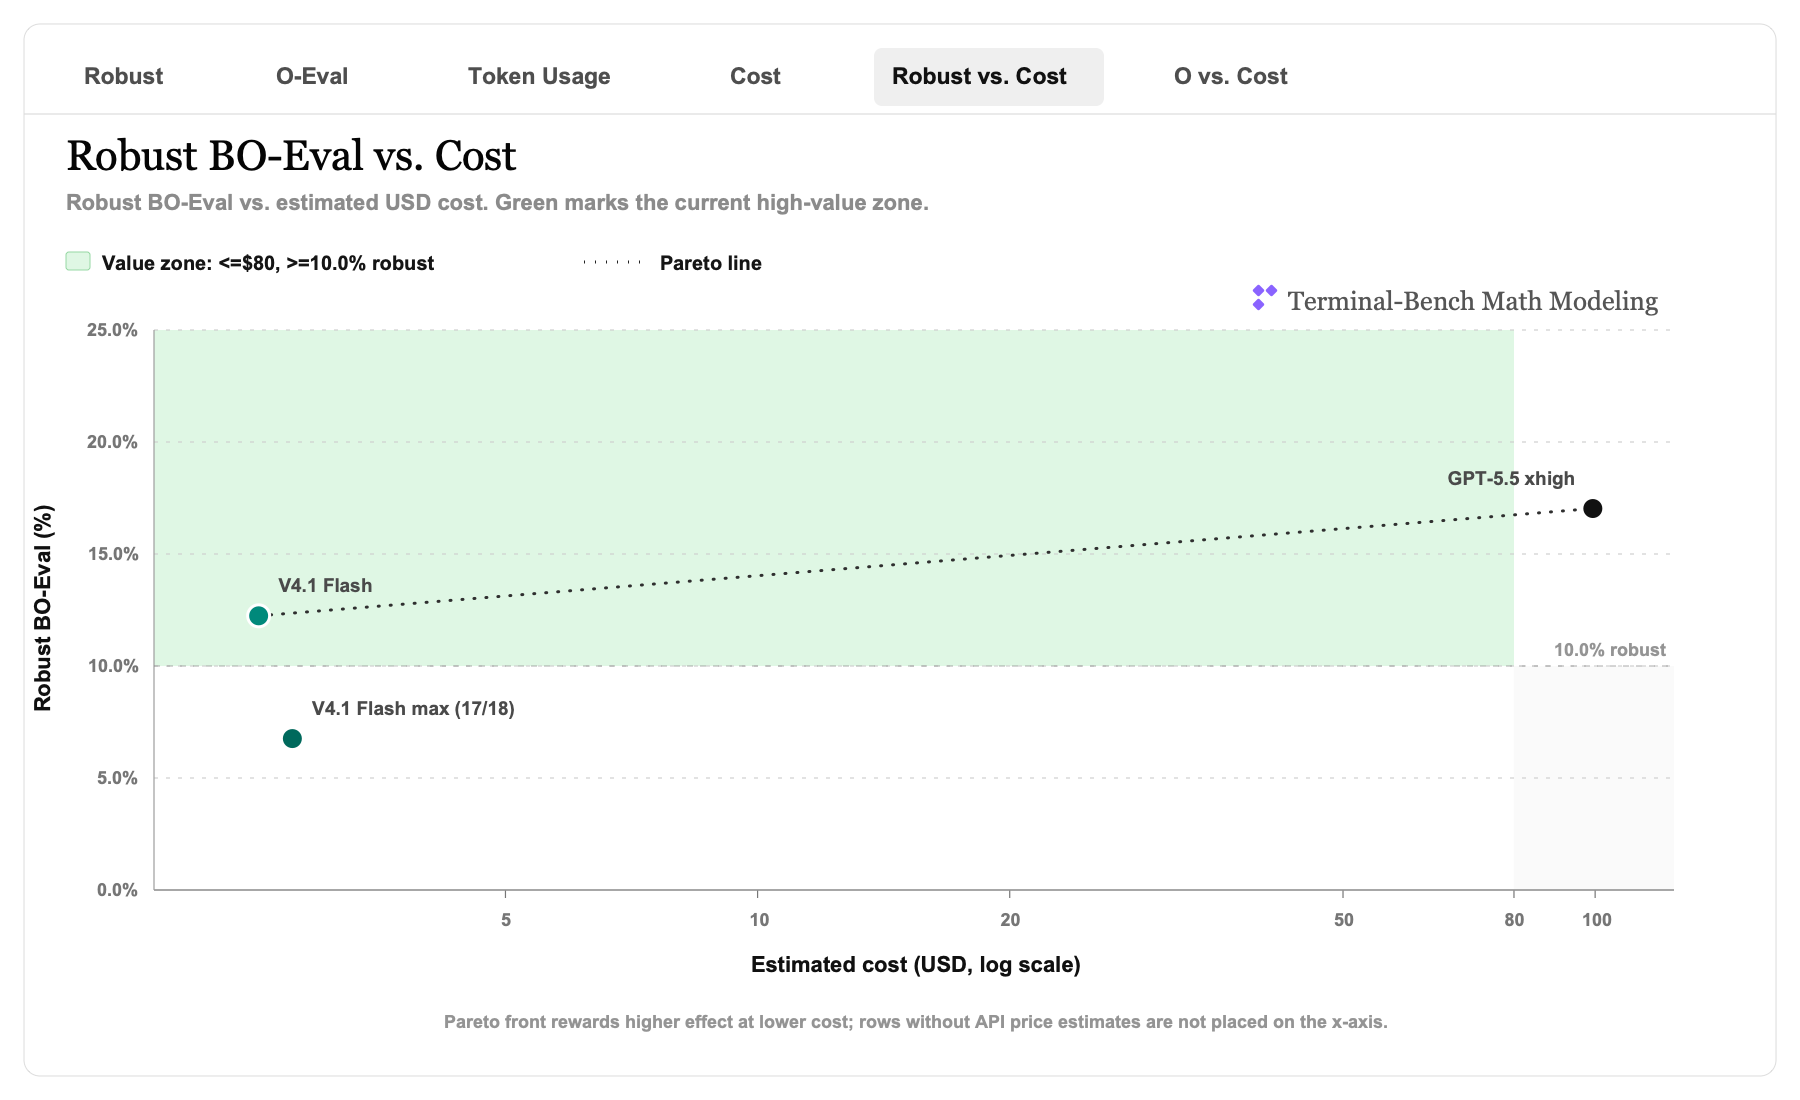
18 / 18 | 64.29% | 17.03% | $99.37 | ¥669.45 | 18 valid + 0 error |
2opencode + DeepSeek V4.1 FlashDeepSeek V4.1 Flash(text+image->text),opencode CLI;thinking 默认开启、effort=high(DeepSeek 默认档,档位为 low/high/max)。18/18 均产出可评分结果。mcm-2024-a-lamprey 曾因把产物写成 -result.json(题目要求 _result.json)而未被收集,已按该次运行重放脚本复原产物并重新评分(O-Eval 7.02%)。 |
18 / 18 | 62.19% | 12.24% | $2.54 | ¥17.09 | 18 valid + 0 error |
3opencode + DeepSeek V4.1 Flash (max)同一模型、同一 opencode CLI,仅把 thinking 档位从默认 high 提到 max(--agent-kwarg variant=max)。这是 high vs max 的对照条目。mcm-2024-a-lamprey 与 high 档同样写错文件名(-result.json),已从轨迹复原并重评(O-Eval 9.15%);cumcm-2025-a-smoke-screen 四次尝试后触及 4 小时上限超时,且 cumcm-2023-a-heliostat-field 的额定功率为 59.997 MW(差 0.003 MW 未达 60 MW)被 hard gate。因此 17/18 有效。 |
17 / 18 | 51.48% | 6.76% | $2.78 | ¥18.75 | 17 valid + 1 timeout |
O-Eval / Robust BO-Eval 与下面纯文本榜同口径(write_all_models_boeval_2023_2025.py 生成)。
产物复原说明:mcm-2024-a-lamprey 那次运行其实完成了完整建模(三物种 ODE、20 组情景、敏感性分析、图表),但把结果写成了 mcm-2024-a-lamprey-result.json,而题目要求 mcm-2024-a-lamprey_result.json,因此未被收集。我们按同一次运行重放它的脚本复现了产物并用官方 verifier 重新评分,得 O-Eval 7.02%。复核发现它报的是归一化值(0.09 / 0.42)而非题目要求的原始种群指数(8.56 / 1080.36),属于量纲/字段理解错误——所以这是个低分但仍有效的作答,不是"没交卷"。
O 奖参照值修正说明:核对 O 奖原论文后发现三道题的参照值此前取自复现产物、与论文不一致,已按论文重设锚点:cumcm-2024-a-dragon-dance 最大龙头速度 2.00002 → 1.406276 m/s(速度比 0.99999 → 1.422195);cumcm-2025-b-sic-thickness 厚度 SiC 8.9815 → 7.604 µm、Si 10.5145 → 3.814 µm;cumcm-2024-c-crop-planting 改用论文式(19)口径下的可复现精确最优解(见下)。修正后全榜(含纯文本榜)分数均按同一份报告重算。
农作物种植(special case):该题 O 奖论文的完整约束集——含其自创的"实际产量≥0.9×预期销量"——在官方附件上与题目硬约束联立后无可行解(HiGHS 判定 INFEASIBLE,多次复现),且论文使用未公开的 DEGA 启发式,其汇报值无法忠实复现。因此该题锚点改为按论文式(19)(min(x·y, d) 在逐地块求和之内)建模、用 HiGHS 求得的可复现精确最优解:滞销 40,418,877 元 / 半价 58,718,967 元(MIP gap < 0.15%)。该题已在计分配置中标为 special case。
计费口径(成本列的算法):按 OpenRouter 目录价对实测 token 用量计算,并做两项保守处理——
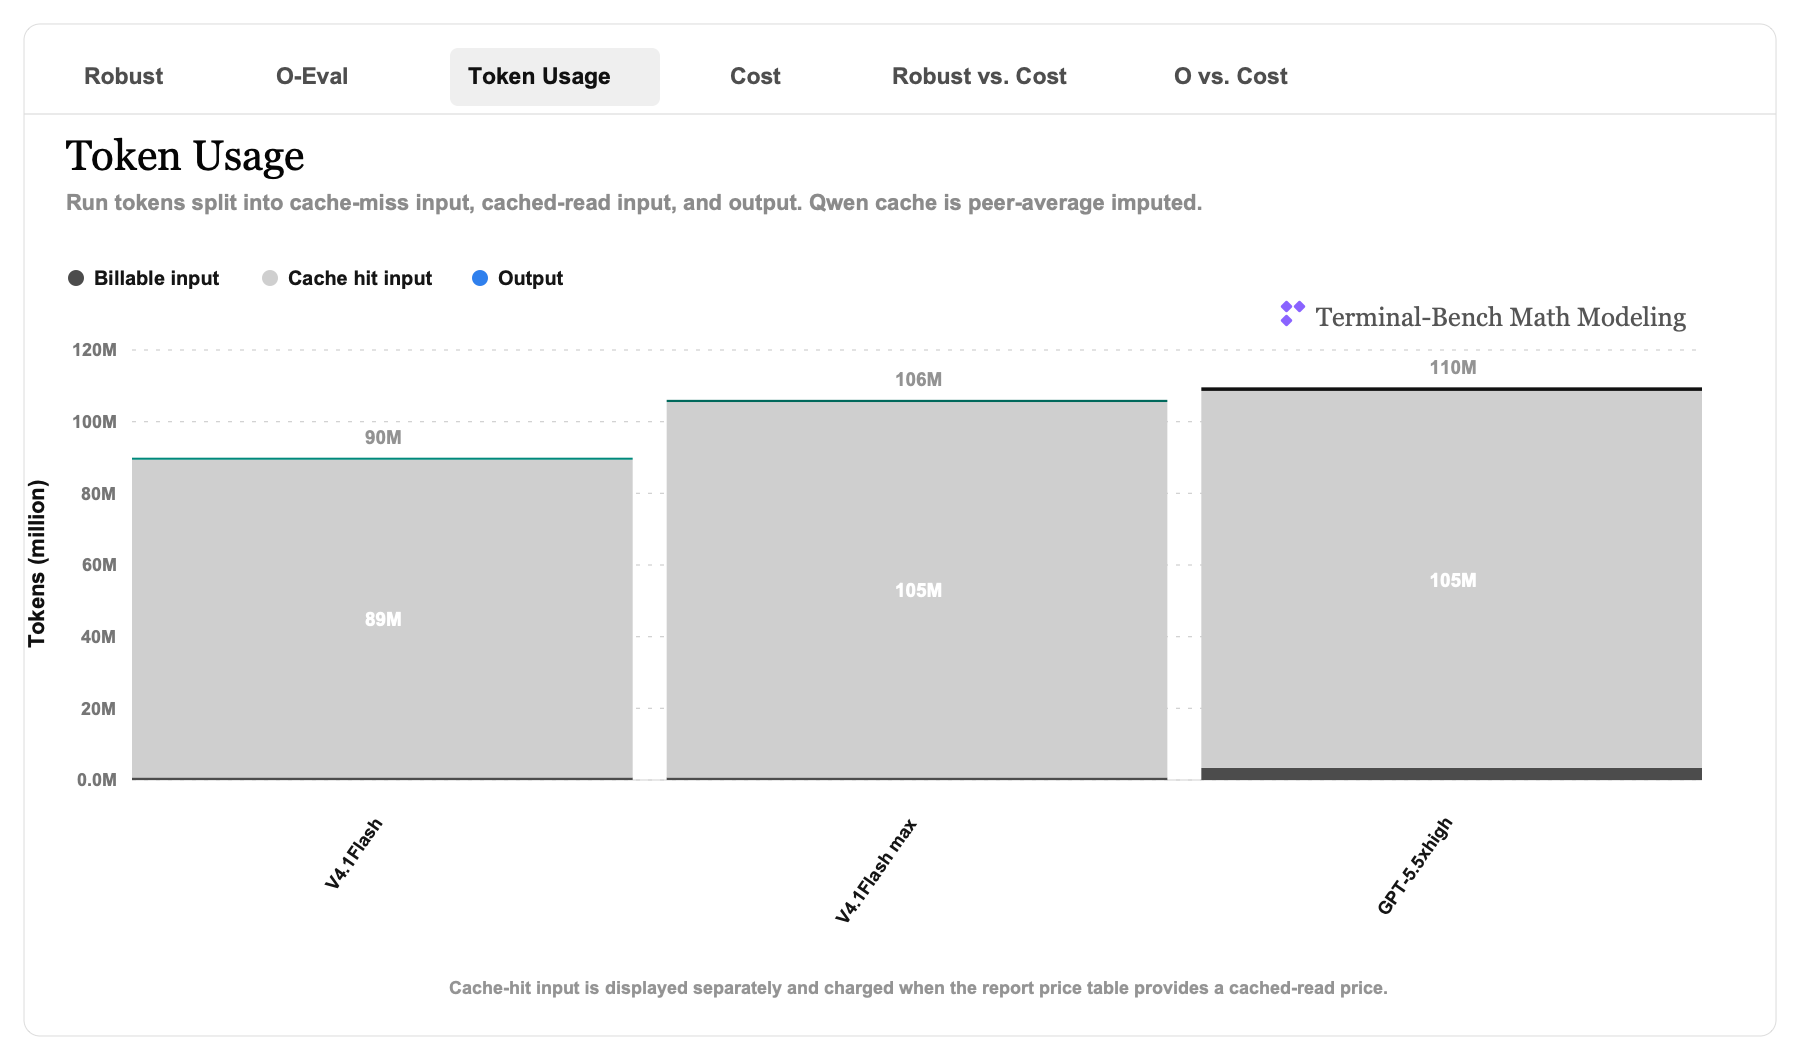
(1) 推理 token 计入费用。OpenAI 的 output_tokens 已包含推理,不再另加;DeepSeek(opencode 侧)的推理是独立计数器(每步满足 total = input + output + reasoning + cache_read),因此在其输出上补加 923,275 个推理 token。
(2) 按高峰时段计价。DeepSeek V4.1 Flash 在工作日 UTC 100–400 与 600–1000 三个项目均为 2 倍价,成本列按高峰价计,避免低估;GPT-5.5 的 >272k 长上下文档位本次未触发(最大单请求 219,735)。
温和版 hard-gated 对照。两个多模态条目均为 0 gates,说明它们的高分不是靠不可行解刷出来的。
| Model | Hard-gated O-Eval | Hard-gated Robust BO-Eval | Original O-Eval | Cost USD | Hard Gates |
|---|---|---|---|---|---|
| 1codex + GPT-5.5 xhigh没有被判为明显不可行的题,gate 前后分数一致。 | 64.29% | 17.03% | 64.29% | $99.37 | 0 gates |
| 2opencode + DeepSeek V4.1 Flash同样 0 gate;Robust BO-Eval 为正但明显低于旗舰,说明它在若干题上未超过 baseline。 | 62.19% | 12.24% | 62.19% | $2.54 | 0 gates |
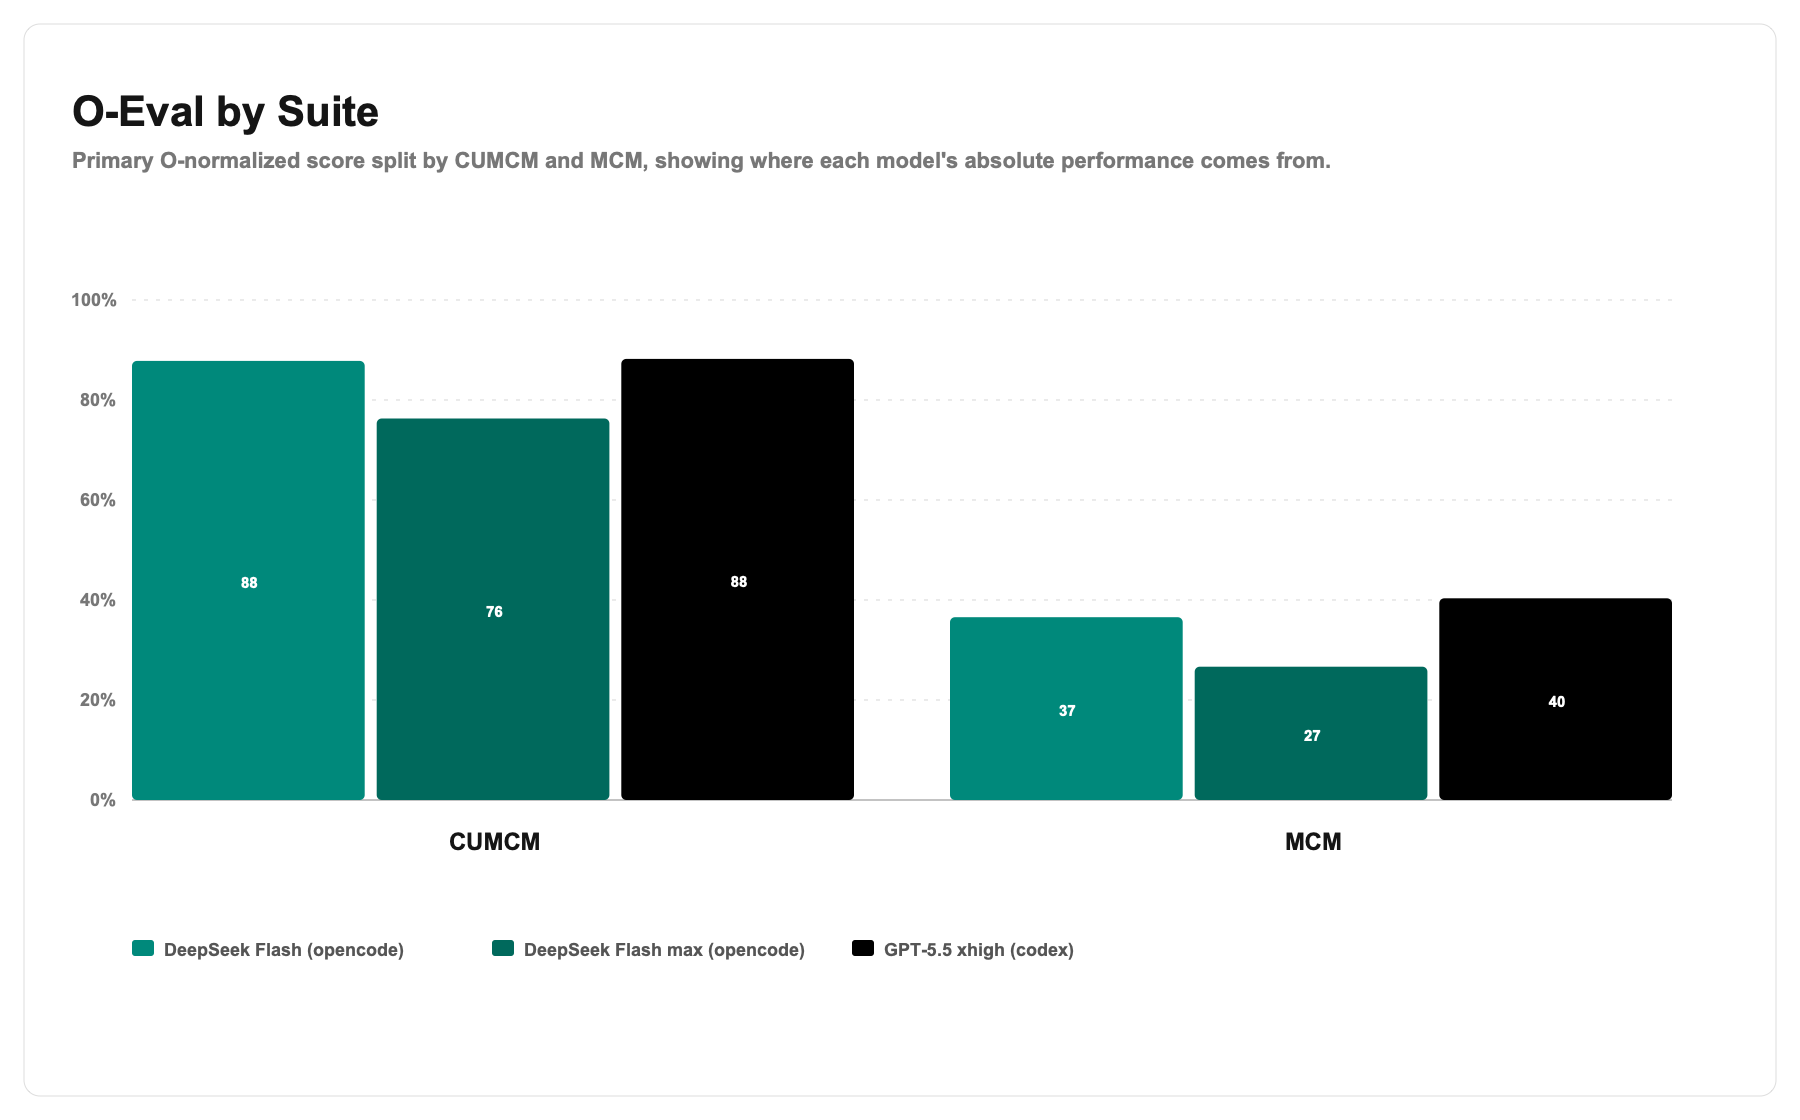
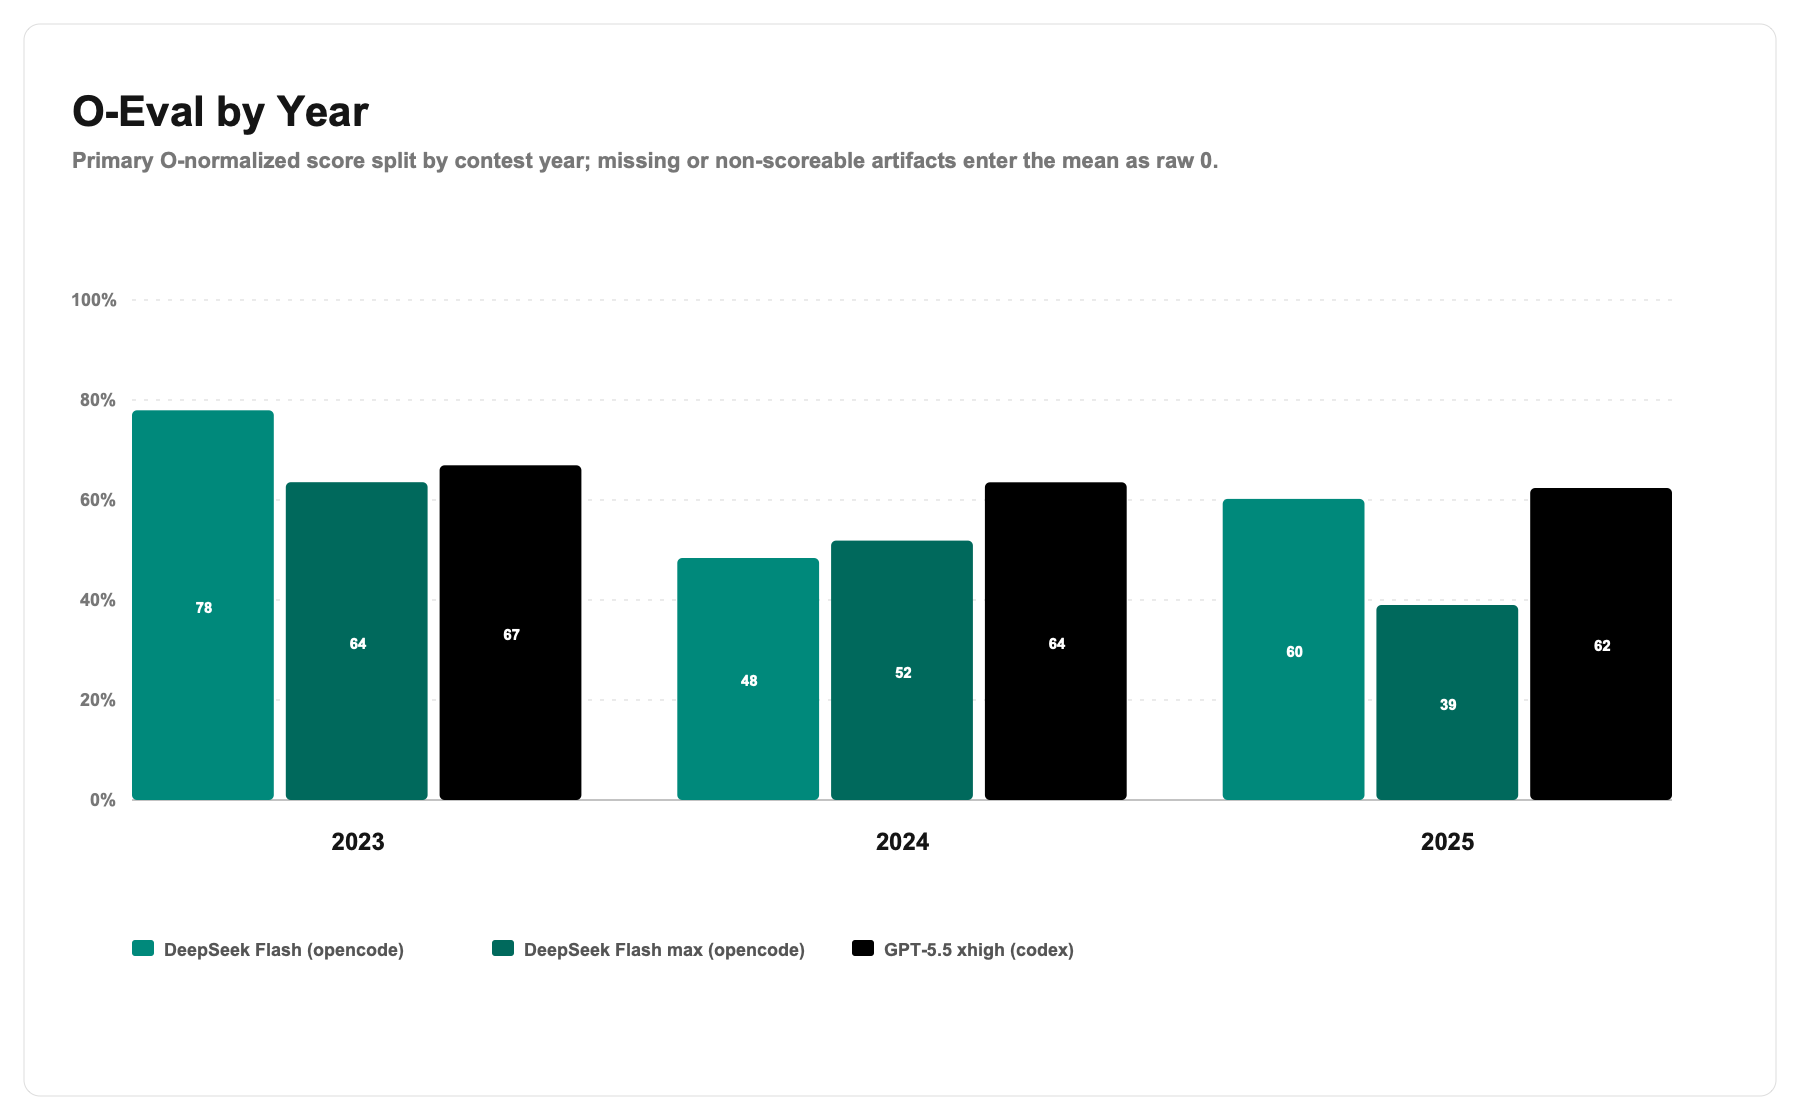
多模态主榜的配套可视化,与纯文本榜共用同一套 AA 风格绘图脚本(write_aa_style_eval_figures.py 与 write_all_models_boeval_2023_2025.py),只是把模型集合收窄到两个多模态条目、并把成本统一为美元。所有数字都由同一份生成报告解析,和主榜不会漂移。
这是此前的纯文本榜(Terminus-2 等 agent 没有图片输入通道),保留在此用于追溯与对照。正式的当前榜首见上面的 Multimodal Leaderboard。
原始榜保留在这里用于追溯自动 scorer 输出;正式解读优先看这个主榜的排名变化,再参考下面的 hard-gated 榜判断高分是否真的是可行解。
| Model | Artifacts | O-Eval | Robust BO-Eval | Cost RMB | Status |
|---|---|---|---|---|---|
| 1Kimi K3Highest original O-Eval before hard-gating confirmed infeasible highs. | 18 / 18 | 64.24% | 15.16% | ¥166.32 | 17 valid + 1 error |
| 2Tencent Hy4 PreviewNear-top O-Eval; strongest after tempered hard gate. | 18 / 18 | 63.90% | 10.75% | ¥97.95 | complete |
| 3Qwen3.8-27B-FP8 thinkingSmall model size, competitive O-Eval; Robust shifts after the stronger baseline. | 18 / 18 | 62.24% | 10.19% | ¥122.72 | 17 valid + 1 error |
| 4GPT-5.6 SOL highStrong oracle-normalized result, stable robust score. | 18 / 18 | 60.56% | 5.13% | ¥59.98 | complete |
| 5v4 flash baseline4h rerun reference; used as the Robust BO comparison anchor. | 17 / 18 | 60.19% | 0.00% | ¥3.07 | 18 finished |
| 6GLM-5.3More expensive in this run due to token and pricing mix. | 18 / 18 | 59.28% | 8.12% | ¥201.28 | complete |
| 7v4 proUseful as a stronger non-flash comparison point. | 18 / 18 | 58.44% | 0.80% | ¥69.04 | complete |
| 8GPT-5.6 SOL xhighLatest monitored reruns: crop planting and Maasai Mara both have artifacts; heliostat field ended in the final 2h timeout. | 17 / 18 | 56.84% | -2.44% | ¥99.26 | 17 valid + 1 error |
| 9GLM-5.3-Flash (ox-alpha)17 valid + 1 final timeout; failures are penalized in both metrics. | 18 / 18 | 55.09% | -1.18% | ¥19.62 | partial |
| 10Gemini 3.7 Flash highPartial artifact coverage; missing tasks receive the failure penalty. | 15 / 18 | 54.94% | -10.59% | ¥82.93 | partial |
| 11Qwen3.8 Flash (Bailian)16 valid + 2 final timeout; no-score tasks are counted as failures. | 18 / 18 | 51.66% | -7.03% | ¥59.34 | partial |
这是更适合公开汇报的温和版对照榜:只处罚已经能明确判定为不可行解的任务;被 gate 的任务在 O-Eval 中按 raw 0 计入,在 Robust BO-Eval 中对非 baseline 模型按 -100% 计入。
| Model | Artifacts | Hard-gated O-Eval | Hard-gated Robust BO-Eval | Original O-Eval | Cost RMB | Hard Gates |
|---|---|---|---|---|---|---|
| 1Tencent Hy4 PreviewGate 后仍是最高 O-Eval,异常高分未被整题处罚。 | 18 / 18 | 63.90% | 10.75% | 63.90% | ¥97.95 | 0 gates |
| 2Qwen3.8-27B-FP8 thinking高分题经独立边界/运动学检查暂未发现 hard-invalid。 | 18 / 18 | 62.24% | 10.19% | 62.24% | ¥122.72 | 0 gates |
| 3GPT-5.6 SOL high高分主要来自多题稳定接近 O 奖参照,当前无 hard gate。 | 18 / 18 | 60.56% | 5.57% | 60.56% | ¥59.98 | 0 gates |
| 4v4 pro作为非 flash 对照,整体绝对分数在中游。 | 18 / 18 | 58.44% | 0.80% | 58.44% | ¥69.04 | 0 gates |
| 5GPT-5.6 SOL xhighxhigh 无 hard gate;农作物和 Maasai Mara 重跑已有 artifact,定日镜重跑最终超时。 | 17 / 18 | 56.84% | -2.44% | 56.84% | ¥99.26 | 0 gates |
| 6v4 flash baseline4h rerun reference;Robust BO 自比较定义为 0。 | 17 / 18 | 56.09% | 0.00% | 60.19% | ¥3.07 | 1 gates |
| 7GLM-5.3仅定日镜安装高度硬错误进入 gate;七鳃鳗量纲问题单独标记。 | 18 / 18 | 53.72% | -2.99% | 59.28% | ¥201.28 | 1 gates |
| 8Kimi K3原始 O-Eval 最高,但两个异常高分被确认不可行后回落。 | 18 / 18 | 53.13% | -1.68% | 64.24% | ¥166.32 | 2 gates |
| 9Qwen3.8 Flash (Bailian)两个 final timeout 作为失败题进入均值。 | 18 / 18 | 51.66% | -7.03% | 51.66% | ¥59.34 | 0 gates |
| 10Gemini 3.7 Flash high部分题缺 artifact,失败题已进入均值处罚。 | 15 / 18 | 49.55% | -21.04% | 54.94% | ¥82.93 | 1 gates |
| 11GLM-5.3-Flash (ox-alpha)CUMCM 2025 A 烟幕遮蔽异常高分已按不可行解 gate。 | 18 / 18 | 49.53% | -7.30% | 55.09% | ¥19.62 | 1 gates |
当前只对证据很硬的情况动手:自动 scorer 给出 hard-invalid 的结果,或人工复核/独立 replay 已确认“高分但不是可行解”的结果。其余可疑但未确认的 proxy/needs-review 题先保留原分。
| Model / Scope | Task | Penalty | Reason |
|---|---|---|---|
| v4 flash baseline | cumcm-2023-a-heliostat-field |
O raw=0;Robust=0 | Q3 年平均热功率 53.7955 MW,低于题目要求的约 60 MW。 |
| Gemini 3.7 Flash high | cumcm-2023-a-heliostat-field |
O raw=0;Robust=-100% | Q3 年平均热功率 54.966 MW,低于题目要求的约 60 MW。 |
| GLM-5.3 | cumcm-2023-a-heliostat-field |
O raw=0;Robust=-100% | Q3 设计说明明确给出一面尾镜安装高度 z=1.9024 m,低于题面 2 m 下限。 |
| GLM-5.3-Flash (ox-alpha) | cumcm-2025-a-smoke-screen |
O raw=0;Robust=-100% | 独立烟幕遮蔽 replay 在 O 参照视线几何下覆盖时长为 0.00s。 |
| Kimi K3 | mcm-2025-b-juneau-tourism |
O raw=0;Robust=-100% | 单位/尺度不可行:resident_acceptance_index=1.5,sustainability_score=232.2,却应是单位尺度得分。 |
| Kimi K3 | mcm-2025-c-olympic-medals |
O raw=0;Robust=-100% | coach-effect 高分不成立:只有三个可评分推荐,端点 verifier reward 为负,BO 为 0。 |
成本按报告中的人民币估算值展示。v4 flash baseline 已切换到 4 小时 rerun;作为 Robust BO-Eval 的参照模型,它的 baseline 自比较仍定义为 0。没有可评分 artifact 的题目在 O-Eval 中按 raw 0 进入平均值,在 Robust BO-Eval 中按单题 -100% 顶格处罚;本轮只把有明确物理、单位或独立 replay 证据的单元进入 hard gate。lamprey 的公共量纲不一致单独标记为评分配置风险,不再整题误罚。
数学建模没有唯一标准答案,所以 TB-MathModel 先用原始 O-Eval 追踪自动 scorer 的完整输出,再用 hard-gated O-Eval 作为更谨慎的公开对照,把 Robust BO-Eval 作为 baseline-relative 的稳健辅助。
直接看 agent 的可行解离 O 奖参照解有多近。100% 就是平均达到 O 奖复现答案的 raw 水平,超过的部分现在会封顶。
先看模型相对基础方案有没有进步,再用截断和失败处罚压住离群点。它回答的是“有没有比 baseline 多做对一点”。
缺失、无可评分 artifact、自动 hard-invalid 或人工复核确认不可行的异常高分,O-Eval 记 raw 0,Robust BO-Eval 对非 baseline 记 -100%。
纯文本榜的配套图表(原始 O-Eval、hard-gated 对照、Robust BO-Eval、token、成本与年/赛制拆分)。多模态版本的图表见上面的 Multimodal Visuals。


每道题都覆盖一个真实应用场景,要求模型完成假设、建模、求解、代码和可验证结果输出。