# 用大白话看 terminal-bench-math-modeling 的 18 题 O-Eval / Robust BO-Eval
生成日期:2026-09-14
这篇文章解释 2023、2024、2025 三年共 18 道 terminal-bench-math-modeling 题。它不重新跑模型,只读取已经保存的 artifact,再用同一套 direction-aware scoring 重新算 O-Eval 主指标、Robust BO-Eval 辅助指标、token 和粗略成本。
## 先说结论
这个 benchmark 看的不是模型会不会写一篇像样的建模论文,而是:给它完整赛题和附件后,它最后交出来的关键数字,能不能追上优秀论文复现答案。
最终主指标现在是 O-Eval:`clamp(模型 direction-aware raw / O raw, 0, 1)`,再对 18 题取平均。大白话说,100% 就是平均达到 O 奖复现答案的 raw 水平;超过 O 奖锚点的部分不再继续加分。
这也是为什么 O-Eval 和 Robust BO-Eval 会出现排序不一致:O-Eval 看的是离 O 有多近,Robust 看的是比 flash 多追回了多少。一个是绝对分,一个是相对进步分,所以它们是互补的,不是二选一。
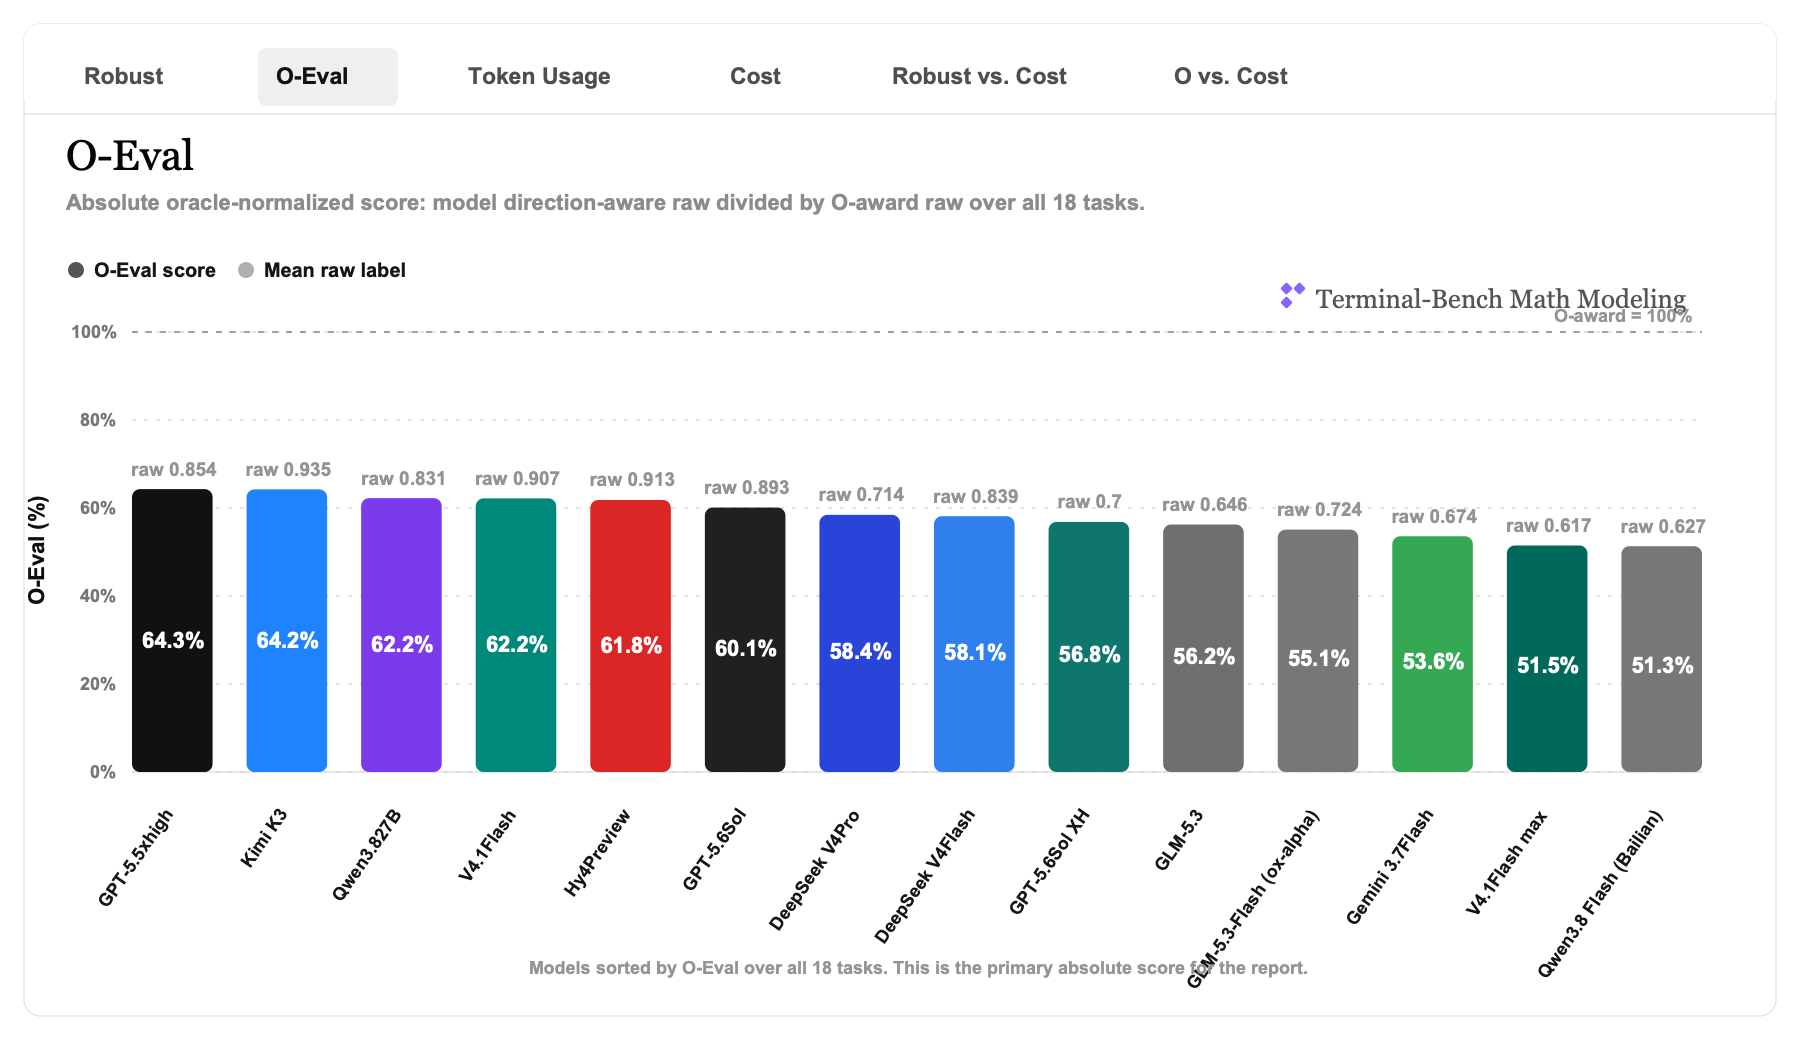
18 题总排名按 O-Eval 算是:GPT-5.5 xhigh (codex) (64.29%) > Kimi K3 (64.24%) > Qwen3.8 27B (62.24%) > DeepSeek Flash (opencode) (62.19%) > Hy4 Preview (61.82%) > GPT-5.6 Sol (60.10%) > v4 pro (58.44%) > GPT-5.6 Sol XH (56.84%) > GLM-5.3 (56.25%) > ox-alpha (55.09%) > Gemini 3.7 Flash (53.58%) > Qwen3.8 Flash (Bailian) (51.32%)。
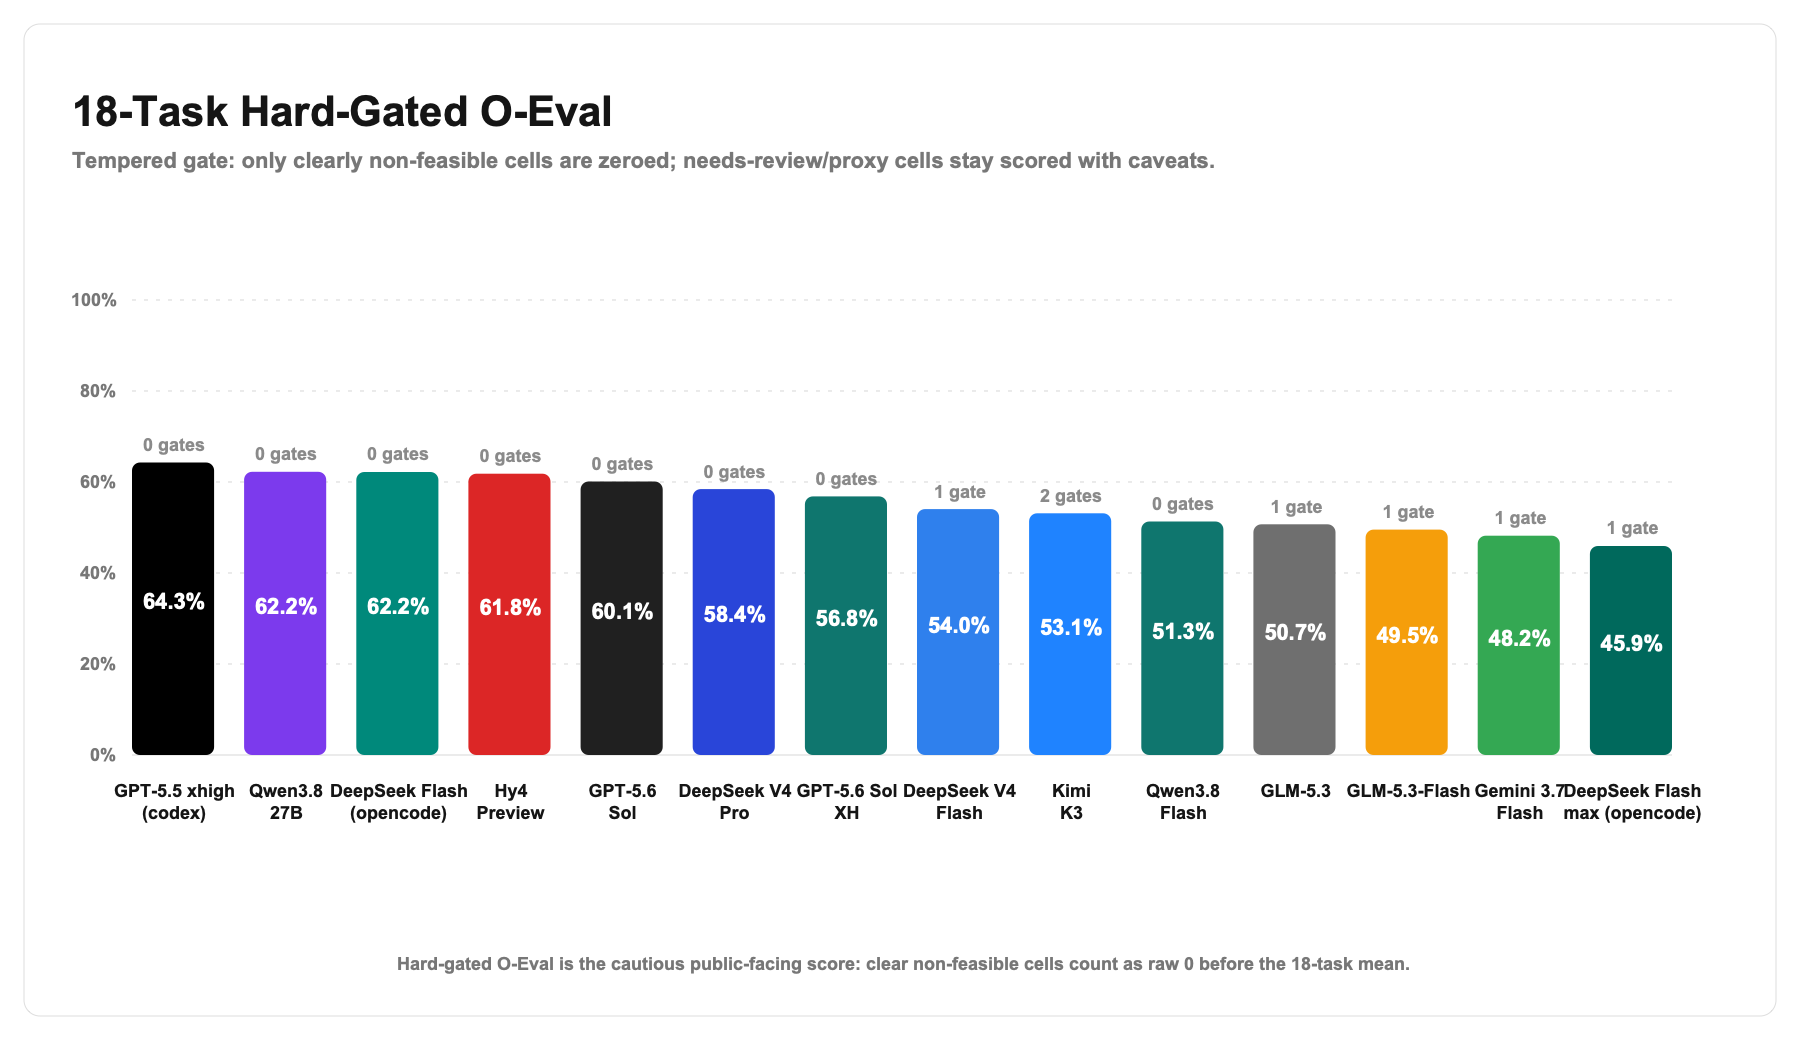
另外新增一个温和版 hard-gated leaderboard:只把“明显不是可行解”的模型-题目格子整题清零,不把所有 needs-review/proxy 题一刀切。按这个谨慎口径,Hard-gated O-Eval 排名是:GPT-5.5 xhigh (codex) (64.29%) > Qwen3.8 27B (62.24%) > DeepSeek Flash (opencode) (62.19%) > Hy4 Preview (61.82%) > GPT-5.6 Sol (60.10%) > v4 pro (58.44%) > GPT-5.6 Sol XH (56.84%) > Kimi K3 (53.13%) > Qwen3.8 Flash (Bailian) (51.32%) > GLM-5.3 (50.70%) > ox-alpha (49.53%) > Gemini 3.7 Flash (48.20%)。
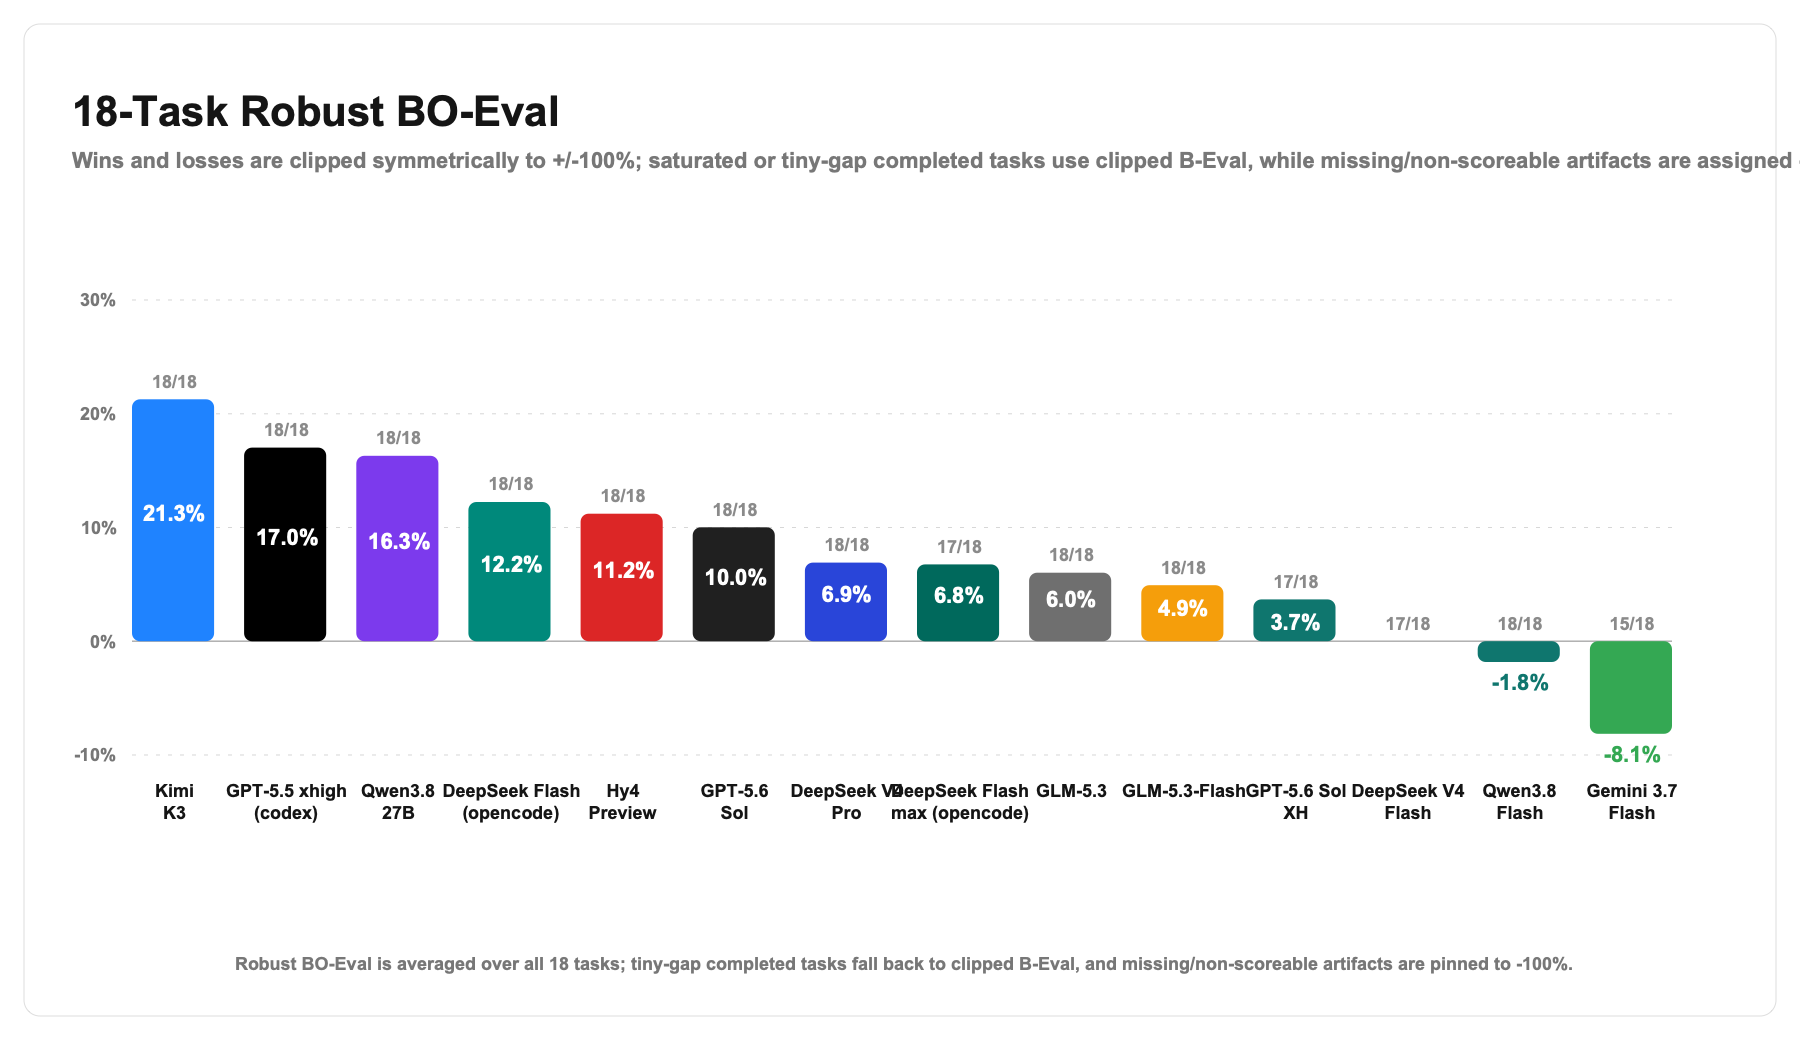
Robust BO-Eval 仍然保留做辅助解释:正常题用 `(模型 raw - flash raw) / (O raw - flash raw)`,而且赢很多和输很多都一起截到 ±100%;分母小于 0.10 的已完成题,改用 clipped B-Eval,也就是把 `模型 raw - flash raw` 截到 ±10pp。若 trial 没有产出可评分结果,就直接记 -100%。它回答的是“相对便宜 flash baseline 多追回多少”,并且不会让 841% 这种小分母离群值主导结论。
如果两个排名冲突,正式主榜以 O-Eval 为准,Robust 只做辅榜和解释。GLM-5.3-Flash 和 DeepSeek flash 的差别也属于这一类:一个可能在相对追赶上更猛,另一个可能在绝对接近 O 上更好。
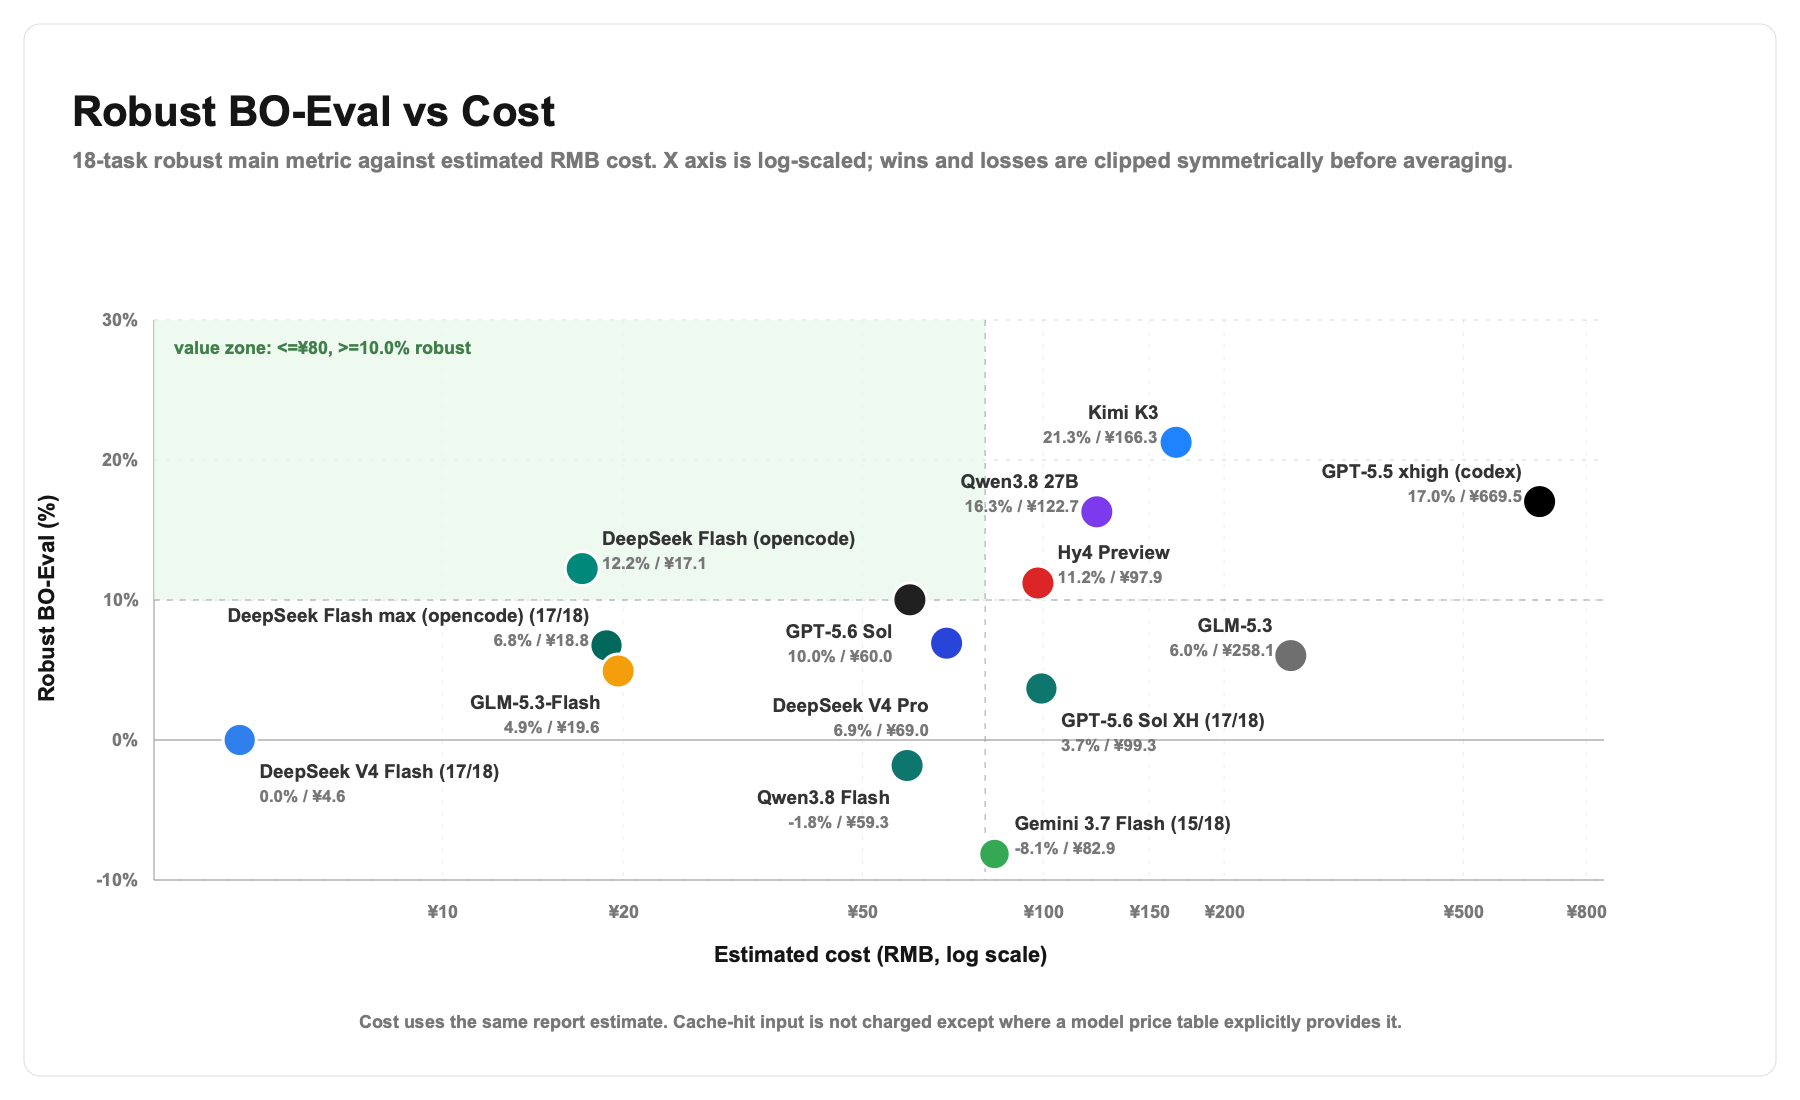
按 Robust 辅助口径排序是:Kimi K3 (21.27%) > GPT-5.5 xhigh (codex) (17.03%) > Qwen3.8 27B (16.30%) > DeepSeek Flash (opencode) (12.24%) > Hy4 Preview (11.21%) > GPT-5.6 Sol (10.01%) > v4 pro (6.91%) > GLM-5.3 (6.03%) > ox-alpha (4.93%) > GPT-5.6 Sol XH (3.68%) > Qwen3.8 Flash (Bailian) (-1.82%) > Gemini 3.7 Flash (-8.14%)。
| 模型 | artifacts | 平均 raw | O-Eval 主分 | Hard-gated O-Eval | Robust BO-Eval 辅助 | Hard-gated Robust | tokens input/cache/output | 估算成本 |
|---|---:|---:|---:|---:|---:|---:|---:|---:|
| v4 flash | 17/18 | 0.838752 | 58.14% | 54.04% | 0.00% | 0.00% | 33,032,997 / 31,802,112 / 1,896,174 | ¥4.60 |
| GPT-5.5 xhigh (codex) | 18/18 | 0.85428 | 64.29% | 64.29% | 17.03% | 17.03% | 108,584,170 / 105,199,744 / 994,910 | ¥669.45 |
| Kimi K3 | 18/18 | 0.934701 | 64.24% | 53.13% | 21.27% | 4.43% | 30,146,116 / 28,928,953 / 956,805 | ¥166.32 |
| Qwen3.8 27B | 18/18 | 0.830722 | 62.24% | 62.24% | 16.30% | 16.30% | 47,245,909 / 0 / 3,178,409 | ¥122.72 |
| DeepSeek Flash (opencode) | 18/18 | 0.907032 | 62.19% | 62.19% | 12.24% | 12.24% | 89,376,395 / 88,668,288 / 569,862 | ¥17.09 |
| Hy4 Preview | 18/18 | 0.912611 | 61.82% | 61.82% | 11.21% | 11.21% | 133,731,323 / 128,999,040 / 2,068,825 | ¥97.95 |
| GPT-5.6 Sol | 18/18 | 0.892644 | 60.10% | 60.10% | 10.01% | 10.45% | 8,774,606 / 7,566,848 / 497,473 | ¥59.98 |
| v4 pro | 18/18 | 0.713865 | 58.44% | 58.44% | 6.91% | 6.91% | 21,309,105 / 20,096,768 / 1,748,356 | ¥69.04 |
| GPT-5.6 Sol XH | 17/18 | 0.700131 | 56.84% | 56.84% | 3.68% | 3.68% | 16,596,399 / 14,928,768 / 841,198 | ¥99.26 |
| GLM-5.3 | 18/18 | 0.646092 | 56.25% | 50.70% | 6.03% | -5.09% | 92,056,972 / 89,637,696 / 2,638,779 | ¥258.05 |
| ox-alpha | 18/18 | 0.724187 | 55.09% | 49.53% | 4.93% | -1.18% | 107,726,029 / 101,466,688 / 3,683,366 | ¥19.62 |
| Gemini 3.7 Flash | 15/18 | 0.674352 | 53.58% | 48.20% | -8.14% | -18.60% | 69,131,259 / 62,497,004 / 705,776 | ¥82.93 |
| Qwen3.8 Flash (Bailian) | 18/18 | 0.626646 | 51.32% | 51.32% | -1.82% | -1.82% | 299,616,972 / 293,563,264 / 6,814,374 | ¥59.34 |
## 温和版 hard-gated 怎么算
hard-gated 不是把所有可疑题都删掉。它只惩罚三类很硬的失败:第一,score_config 已经标出 `invalid_reason` 的硬无效字段;第二,独立重放后确定几何/物理结果为零的高分;第三,明显量纲越界或结构缺失但被开放式“越高越好”指标错误奖励的高分。
被 hard gate 的格子,O-Eval 按 raw 0 进入 18 题平均;Robust BO-Eval 按 -100% 进入 18 题平均。只是 needs-review、proxy-score、还缺更强 replay verifier 的格子,先保留原分,但报告里会标注不能拿来 claim “强于 O”。
| 模型 | Hard-gated O-Eval | Hard-gated Robust | 原始 O-Eval | gate 数 | 成本 |
|---|---:|---:|---:|---:|---:|
| GPT-5.5 xhigh (codex) | 64.29% | 17.03% | 64.29% | 0 | ¥669.45 |
| Qwen3.8 27B | 62.24% | 16.30% | 62.24% | 0 | ¥122.72 |
| DeepSeek Flash (opencode) | 62.19% | 12.24% | 62.19% | 0 | ¥17.09 |
| Hy4 Preview | 61.82% | 11.21% | 61.82% | 0 | ¥97.95 |
| GPT-5.6 Sol | 60.10% | 10.45% | 60.10% | 0 | ¥59.98 |
| v4 pro | 58.44% | 6.91% | 58.44% | 0 | ¥69.04 |
| GPT-5.6 Sol XH | 56.84% | 3.68% | 56.84% | 0 | ¥99.26 |
| v4 flash | 54.04% | 0.00% | 58.14% | 1 | ¥4.60 |
| Kimi K3 | 53.13% | 4.43% | 64.24% | 2 | ¥166.32 |
| Qwen3.8 Flash (Bailian) | 51.32% | -1.82% | 51.32% | 0 | ¥59.34 |
| GLM-5.3 | 50.70% | -5.09% | 56.25% | 1 | ¥258.05 |
| ox-alpha | 49.53% | -1.18% | 55.09% | 1 | ¥19.62 |
| Gemini 3.7 Flash | 48.20% | -18.60% | 53.58% | 1 | ¥82.93 |
这版最大的变化是:Kimi K3 的朱诺旅游和奥运教练效应高分被扣掉,ox-alpha 的烟幕高分被扣掉;七鳃鳗里凡是把原始种群量写成 0-1 归一化指数的格子,也按整题不可行处理。
| 模型 | 赛题 | 原 O-Eval | gated O-Eval | 原 Robust | gated Robust | 原因 |
|---|---|---:|---:|---:|---:|---|
| v4 flash | `cumcm-2023-a-heliostat-field` | 73.82% | 0.00% | 0.00% | 0.00% | hard-invalid/heliostat-constraint: Q2 rated-power constraint violation: 53.795541 MW is below the required approximately 60 MW; Q3 rated-power constraint violation: 53.795541 MW is below the required approximately 60 MW; Q3 does not expose numeric mirror dimensions |
| GLM-5.3 | `cumcm-2023-a-heliostat-field` | 100.00% | 0.00% | 100.00% | -100.00% | explicit Q3 design note violates heliostat installation-height bound: one tail mirror uses z=1.9024 m, below the required 2 m minimum |
| Gemini 3.7 Flash | `cumcm-2023-a-heliostat-field` | 96.90% | 0.00% | 88.16% | -100.00% | hard-invalid/heliostat-constraint: Question 2 rated-power constraint violation: 55.460000 MW is below the required approximately 60 MW; Question 3 rated-power constraint violation: 54.966000 MW is below the required approximately 60 MW |
| ox-alpha | `cumcm-2025-a-smoke-screen` | 100.00% | 0.00% | 10.00% | -100.00% | independent smoke-screen replay gives 0.00s coverage under O-reference line-of-sight geometry |
| Kimi K3 | `mcm-2025-b-juneau-tourism` | 100.00% | 0.00% | 100.00% | -100.00% | unit/scale invalid: resident_acceptance_index=1.5 and sustainability_score=232.2 on a unit-scale score |
| Kimi K3 | `mcm-2025-c-olympic-medals` | 100.00% | 0.00% | 10.00% | -100.00% | invalid high coach-effect result: only three scored recommendations and endpoint verifier reward is negative/BO 0 |
## 图怎么读
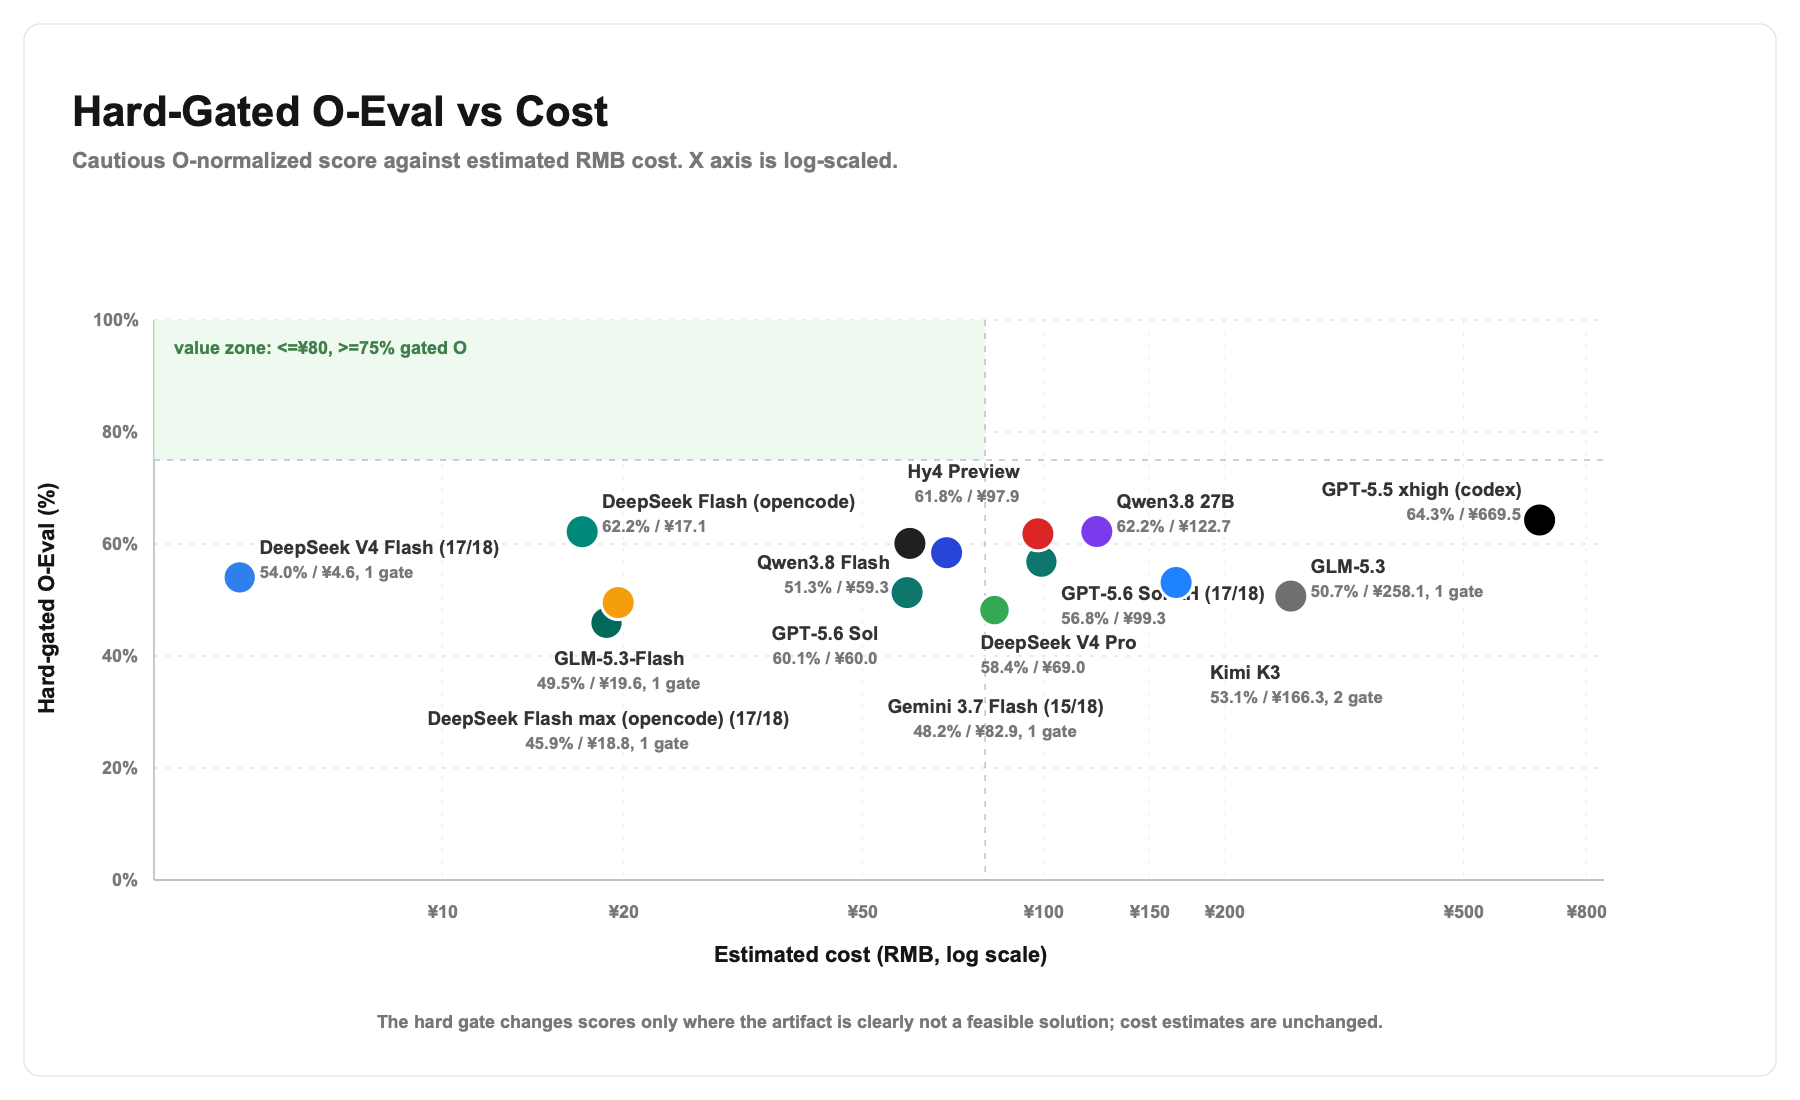
第一组图看温和版 hard-gated O-Eval:它回答“把明显不可行解扣掉以后,谁还稳”。GPT-5.5 xhigh (codex) 在这张榜上排第一;Hy4 Preview 因新增的生产抽检阈值/旅游可持续性越界 gate 回落,Kimi K3 因朱诺旅游和奥运教练效应两个高杠杆坏题明显下滑;ox-alpha 因烟幕几何重放为零,也从原 O-Eval 里掉下来。
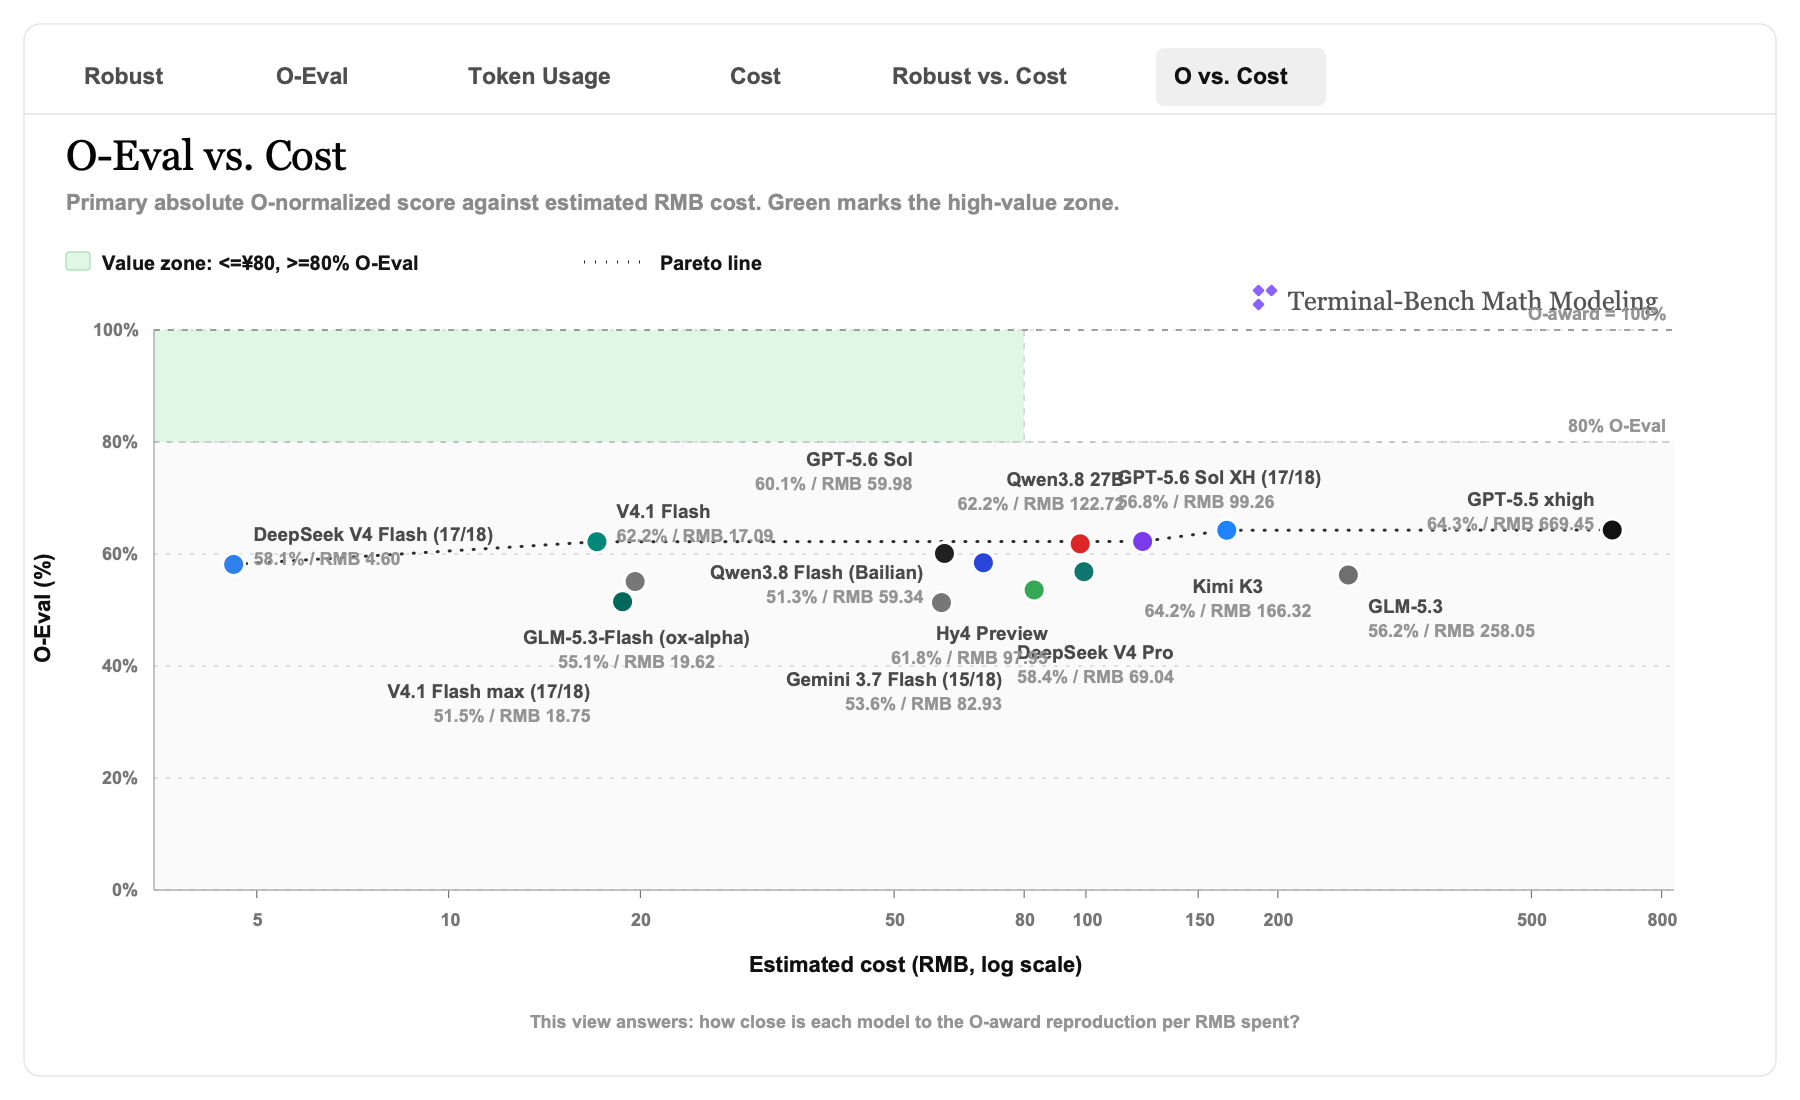
第二组图看原始 O-Eval 主效果;它仍然有意义,因为它展示 verifier 当前定义下的可评分数值表现,但需要和 hard-gated 榜一起读。
Robust 图保留下来,用来看“相对 v4 flash baseline 的增益”是不是稳定;token 和成本图用来解释为什么同样分数会有不同价格。没有可评分 artifact 的 trial 现在按 -100% 记分,不会再被当成普通小分母题。
token 和成本图用来解释为什么同样 O-Eval 分数会有不同价格。
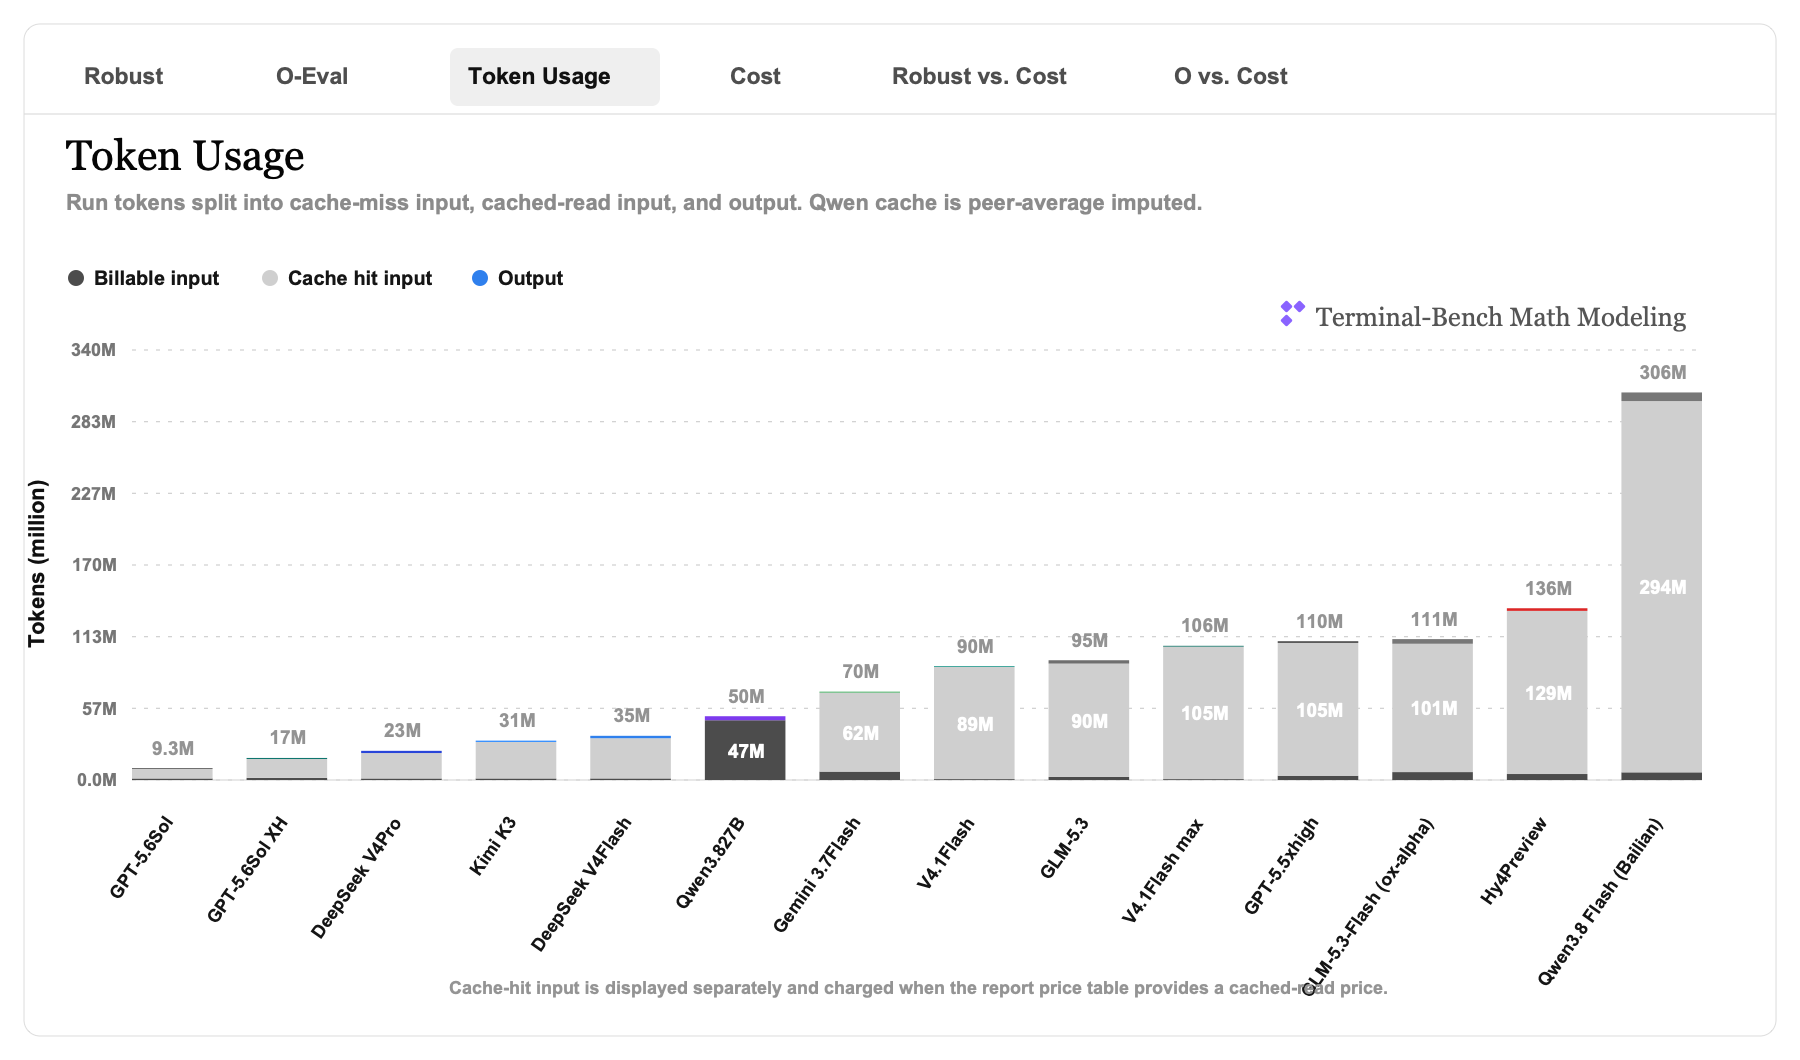
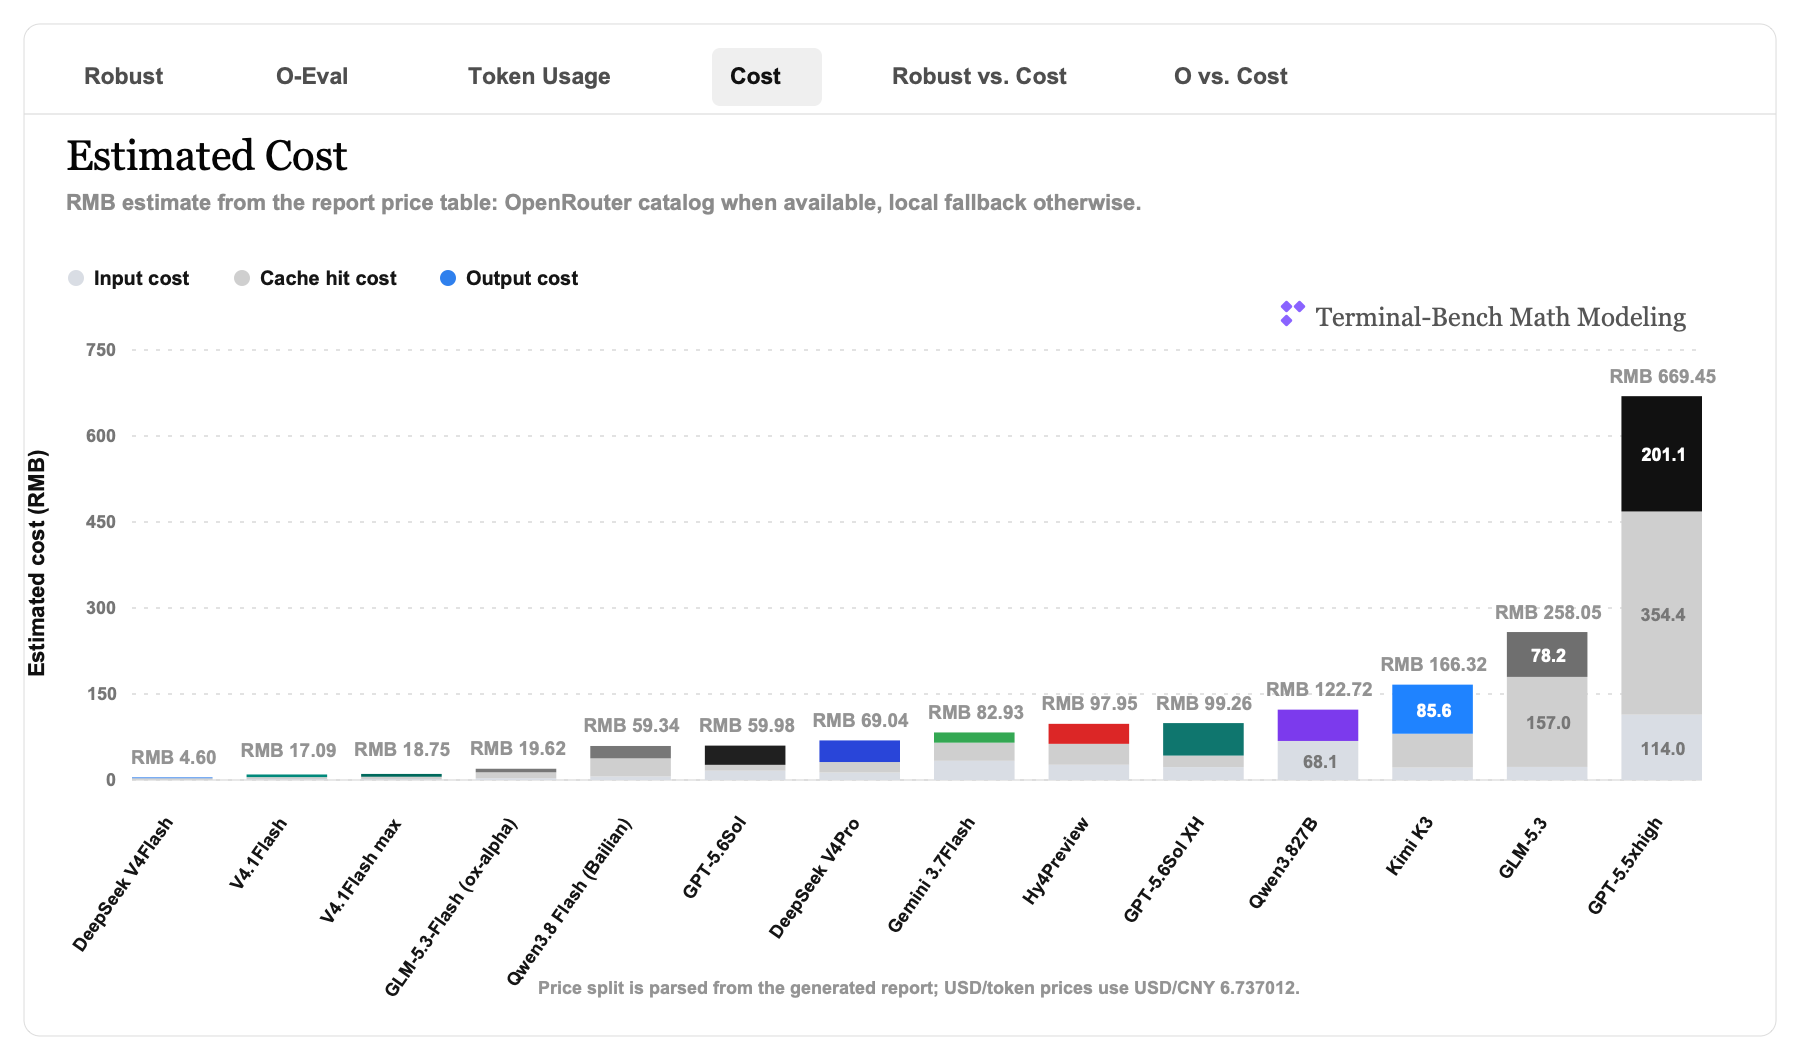
成本统一优先按 OpenRouter 当前 catalog 里的 `prompt`、`input_cache_read`、`input_cache_write`、`completion` 价格算,再用 USD/CNY=6.737012 转成人民币/百万 tokens。价格快照写在 `openrouter-pricing-used-2023-2025.json`;当前 `result.json` 只有 input/cache/output 三类 token,没有单独的 cache write/create 字段,所以显式缓存创建费用不额外拆账。
按这个口径,Qwen3.8 27B 是 62.24% O-Eval、16.30% Robust 辅助、¥122.72 估算成本;它不会再被 841% 这类小分母离群值抬高。
Kimi K3 是 64.24% O-Eval、21.27% Robust 辅助、¥166.32 估算成本。Kimi 2023 的汇总 `result.json` 已经回到 3 completed / 0 error 的状态,所以这里不会再因为旧 error 计数低估 artifacts。
GLM-5.3-Flash (ox-alpha) 已完成 17/18 个有效任务;`cumcm-2023-a-heliostat-field` 因正常模型推理超时记为最终失败,不再重试。目录级 artifact 记录为 18/18,O-Eval 按可评分的有效结果计算。
Qwen3.8 Flash (Bailian) 有 16/18 个有效完成、2 个正常模型推理超时的最终 error;目录级 artifact 记录为 18/18,错误题不进入有效结果。
Hy4 Preview 已完成 18/18 个有效任务,O-Eval 是 61.82%、Robust 辅助是 11.21%。按 OpenRouter `tencent/hy4-preview` 价格估算成本为 ¥97.95。
## B、O、Agent 各自是什么
为了别把三个角色混在一起,后面的逐题表会把它们拆开:
- **B**:v4 flash baseline 的实际提交答案。它是 Robust 里的便宜参考点,不一定是人工写死的 baseline。表里的模型和库优先从它自己的 `result.json` 和 agent 轨迹里抽取。
- **O**:O 奖论文复现答案,也就是 scoring 的 oracle 锚点。表里的模型来自 `expected_result.json`,库来自对应 oracle `solution.py` 的 imports。
- **Agent**:该题当前主表里 O-Eval 最高的非 baseline agent。也就是说,它不是固定某一个模型,而是每道题选“这题做得最接近 O 的那个 agent”来说明模型路线和求解库。
逐题表里的“题型大类”沿用 `intro-mathmodel/数学建模题型-解法速查.md` 的决策树口径,比如解析几何/方程、微分方程/动力系统、运筹优化、数据建模、综合评价/决策、图论网络。复杂题会写成组合类,因为真实赛题常常是“先数据建模,再优化决策”。
这些方法/库不是重新评判答案,只是给读者解释:同一个分数背后,大家到底把赛题抽象成了什么数学问题,又大概靠什么 Python 数值栈求出来。NumPy、Pandas、SciPy 这类是实现工具,不是数学模型;抽不到明确库时,我会写“未显式记录”,不强行脑补。
## O-Eval 到底怎么算
先把每道题最后答案里的关键数字拆出来,比如定日镜场的年平均输出功率、网球势头题的预测准确率、烟幕题的遮蔽时长。每个数字根据方向算 reward:该高的越高越好,该低的越低越好,该贴目标值的就越接近越好。
多个指标平均起来,就是这道题的 direction-aware raw。然后 O-Eval 用 O 奖复现答案做分母:
```text
本题 O-Eval = clamp(模型 raw / O raw, 0, 1)
```
最后对 18 道题取平均。它最像“绝对成绩单”:不关心 flash baseline 有多强或多弱,只问模型答案离 O 奖复现锚点有多近。缺失 artifact 仍按 raw 0 计入,所以覆盖不完整会直接掉分。
下面这张表是 18 道题的 O-Eval 展开。
| 赛题 | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| CUMCM 2023 A | 100.00% | 97.53% | 100.00% | 100.00% | 100.00% | 97.20% | 100.00% | 0.00% | 100.00% | 0.00% | 96.90% | 100.00% |
| CUMCM 2023 B | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| CUMCM 2023 C | 100.00% | 100.00% | 100.00% | 100.00% | 96.36% | 100.00% | 59.79% | 100.00% | 35.51% | 100.00% | 100.00% | 100.00% |
| CUMCM 2024 A | 49.82% | 7.54% | 49.82% | 49.82% | 49.82% | 49.82% | 100.00% | 49.82% | 49.82% | 49.82% | 100.00% | 49.82% |
| CUMCM 2024 B | 78.89% | 94.31% | 100.00% | 73.77% | 36.65% | 44.45% | 31.86% | 47.92% | 25.73% | 39.02% | 46.91% | 0.00% |
| CUMCM 2024 C | 100.00% | 100.00% | 100.00% | 100.00% | 62.52% | 91.85% | 100.00% | 100.00% | 45.57% | 100.00% | 75.68% | 93.97% |
| CUMCM 2025 A | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 93.92% | 85.44% | 100.00% | 100.00% | 0.00% |
| CUMCM 2025 B | 70.43% | 72.98% | 35.70% | 66.82% | 56.12% | 53.73% | 10.98% | 65.75% | 70.33% | 69.20% | 72.26% | 66.50% |
| CUMCM 2025 C | 94.91% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 62.60% | 100.00% | 100.00% | 100.00% | 100.00% |
| MCM 2023 A | 70.26% | 46.95% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 54.54% | 37.32% |
| MCM 2023 B | 3.35% | 2.87% | 2.40% | 13.03% | 2.25% | 3.24% | 3.44% | 7.37% | 6.81% | 8.86% | 6.34% | 2.32% |
| MCM 2023 C | 28.00% | 24.65% | 58.00% | 54.60% | 98.31% | 72.35% | 9.80% | 25.98% | 53.00% | 56.58% | 0.00% | 6.54% |
| MCM 2024 A | 26.54% | 24.67% | 7.02% | 7.02% | 1.56% | 7.02% | 23.53% | 7.02% | 12.50% | 8.96% | 22.90% | 10.81% |
| MCM 2024 B | 40.31% | 47.09% | 75.32% | 21.24% | 30.03% | 38.90% | 29.65% | 66.22% | 70.93% | 63.24% | 18.79% | 27.29% |
| MCM 2024 C | 85.63% | 37.75% | 52.34% | 38.56% | 77.90% | 40.33% | 56.46% | 71.38% | 36.14% | 77.33% | 0.00% | 46.46% |
| MCM 2025 A | 0.00% | 0.00% | 23.33% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% |
| MCM 2025 B | 9.01% | 100.00% | 2.52% | 17.10% | 56.72% | 37.29% | 42.61% | 25.11% | 33.72% | 0.00% | 70.20% | 90.71% |
| MCM 2025 C | 100.00% | 100.00% | 13.86% | 77.43% | 44.56% | 45.71% | 83.82% | 100.00% | 87.03% | 18.61% | 0.00% | 92.09% |
| **最终平均** | **64.29%** | **64.24%** | **62.24%** | **62.19%** | **61.82%** | **60.10%** | **58.44%** | **56.84%** | **56.25%** | **55.09%** | **53.58%** | **51.32%** |
## Robust BO-Eval 怎么辅助解释
有了每题的 direction-aware raw 以后,Robust BO-Eval 额外放进一个便宜 baseline:v4 flash。
它的公式还是先看相对 flash 的比例;如果 flash 已经很接近 O,或者分母不够大,就改用 clipped B-Eval,避免小分母把结果放大到离谱。
所以 Robust BO-Eval 辅助指标这样算:如果 `O raw - flash raw >= 0.10`,用比例但截到 ±100%;如果分母太小,完成了的题就用 clipped B-Eval 但截到 ±10pp;如果 trial 压根没跑出可评分结果,直接记 -100%。直白说,正常题看追回比例,没做出来的题按最坏值算,而且赢很多和输很多都不会冲破上限。
18 道题里有 11 道题满足 `O raw > flash raw`,完成但分母太小或失效的 7 类题会用 clipped B-Eval 进入最终平均;如果某个 trial 没有产出可评分结果,它会直接记 -100% 而不是躲进平均里。
举个真实例子:CUMCM 2024 C `cumcm-2024-c-crop-planting` 里,flash raw=0.631481,O raw=1,分母是 0.368519。Kimi K3 raw=1.07645,但进入 Robust 辅助分的是 100.00%。
下面这张表是 18 道题的 Robust 辅助指标展开。这里没有 `N/A` 逃逸口:完成但分母太小的题会用 clipped B-Eval 进入平均,最终失败或缺失的 trial 则直接记 -100%。
| 赛题 | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| CUMCM 2023 A | 100.00% | 90.58% | 100.00% | 100.00% | 100.00% | 89.29% | 100.00% | -100.00% | 100.00% | -100.00% | 88.16% | 100.00% |
| CUMCM 2023 B | 10.00% | -8.20% | 0.94% | 7.37% | 10.00% | 10.00% | 0.37% | -2.93% | 0.83% | 0.82% | 0.40% | 5.03% |
| CUMCM 2023 C | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -2.69% | -10.00% |
| CUMCM 2024 A | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% |
| CUMCM 2024 B | 78.89% | 94.31% | 100.00% | 73.77% | 36.65% | 44.45% | 31.86% | 47.92% | 25.73% | 39.02% | 46.91% | -100.00% |
| CUMCM 2024 C | 100.00% | 100.00% | 100.00% | 100.00% | -1.71% | 77.88% | 100.00% | 100.00% | -47.71% | 100.00% | 34.01% | 83.63% |
| CUMCM 2025 A | 10.00% | 10.00% | 10.00% | 10.00% | 10.00% | 10.00% | 0.44% | -10.00% | -10.00% | 10.00% | -10.00% | -100.00% |
| CUMCM 2025 B | -24.43% | -13.67% | -100.00% | -39.58% | -84.61% | -94.69% | -100.00% | -44.12% | -24.82% | -29.60% | -16.73% | -40.95% |
| CUMCM 2025 C | -10.00% | -10.00% | 1.52% | -10.00% | -10.00% | -5.39% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% |
| MCM 2023 A | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -9.32% | -10.00% | -10.00% | -10.00% |
| MCM 2023 B | -7.64% | -8.17% | -8.69% | 3.15% | -8.86% | -7.77% | -7.54% | -3.16% | -3.78% | -1.51% | -4.31% | -8.78% |
| MCM 2023 C | 7.19% | 2.88% | 45.86% | 41.48% | 97.82% | 64.36% | -16.27% | 4.59% | 39.42% | 44.04% | -100.00% | -20.46% |
| MCM 2024 A | 20.99% | 18.99% | 0.00% | 0.00% | -5.87% | 0.00% | 17.76% | 0.00% | 5.90% | 2.09% | 17.08% | 4.08% |
| MCM 2024 B | 5.04% | 15.82% | 60.74% | -25.30% | -11.31% | 2.80% | -11.92% | 46.25% | 53.75% | 41.51% | -29.19% | -15.68% |
| MCM 2024 C | 79.28% | 10.27% | 31.29% | 11.43% | 68.14% | 13.98% | 37.24% | 58.74% | 7.95% | 67.32% | -100.00% | 22.83% |
| MCM 2025 A | 0.00% | 0.00% | 23.33% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% |
| MCM 2025 B | -22.85% | 100.00% | -31.61% | -11.93% | 41.57% | 15.33% | 22.51% | -1.12% | 10.51% | -35.02% | 59.77% | 87.46% |
| MCM 2025 C | -10.00% | 10.00% | -10.00% | -10.00% | -10.00% | -10.00% | -10.00% | 10.00% | -10.00% | -10.00% | -100.00% | -10.00% |
| **最终平均** | **17.03%** | **21.27%** | **16.30%** | **12.24%** | **11.21%** | **10.01%** | **6.91%** | **3.68%** | **6.03%** | **4.93%** | **-8.14%** | **-1.82%** |
## 分年份和赛制看
同一个 O-Eval 总分拆开看,会发现 2023、2024、2025 的难点不一样;CUMCM 和 MCM 也不是同一种口味。
| 模型 | 2023 | 2024 | 2025 |
|---|---:|---:|---:|
| GPT-5.5 xhigh (codex) | 66.93% | 63.53% | 62.39% |
| Kimi K3 | 62.00% | 51.89% | 78.83% |
| Qwen3.8 27B | 76.73% | 64.08% | 45.90% |
| DeepSeek Flash (opencode) | 77.94% | 48.40% | 60.23% |
| Hy4 Preview | 82.82% | 43.08% | 59.57% |
| GPT-5.6 Sol | 78.80% | 45.39% | 56.12% |
| v4 pro | 62.17% | 56.92% | 56.23% |
| GPT-5.6 Sol XH | 55.56% | 57.06% | 57.90% |
| GLM-5.3 | 65.89% | 40.12% | 62.76% |
| ox-alpha | 60.91% | 56.39% | 47.97% |
| Gemini 3.7 Flash | 59.63% | 44.05% | 57.08% |
| Qwen3.8 Flash (Bailian) | 57.70% | 38.06% | 58.22% |
| 模型 | CUMCM | MCM | CUMCM artifacts | MCM artifacts |
|---|---:|---:|---:|---:|
| GPT-5.5 xhigh (codex) | 88.23% | 40.34% | 9 | 9 |
| Kimi K3 | 85.82% | 42.67% | 9 | 9 |
| Qwen3.8 27B | 87.28% | 37.20% | 9 | 9 |
| DeepSeek Flash (opencode) | 87.82% | 36.55% | 9 | 9 |
| Hy4 Preview | 77.94% | 45.70% | 9 | 9 |
| GPT-5.6 Sol | 81.89% | 38.31% | 9 | 9 |
| v4 pro | 78.07% | 38.81% | 9 | 9 |
| GPT-5.6 Sol XH | 68.89% | 44.79% | 8 | 9 |
| GLM-5.3 | 68.05% | 44.46% | 9 | 9 |
| ox-alpha | 73.12% | 37.06% | 8 | 9 |
| Gemini 3.7 Flash | 87.97% | 19.20% | 9 | 6 |
| Qwen3.8 Flash (Bailian) | 67.81% | 34.84% | 7 | 9 |
## 18 道题逐题看
### CUMCM 2023 A: 定日镜场布局优化
任务 slug:`cumcm-2023-a-heliostat-field`
**这题在问什么:**在定日镜尺寸和安装高度都可以变化时,重新设计镜场,在满足约 60 MW 年平均输出功率的同时,让单位镜面面积输出尽量大。
**BO/O 答案是什么:**O 奖复现给出的核心设计是年平均热功率 60.336111 MW,单位面积功率 0.506192417 kW/m2,年平均光学效率 0.496428083,镜面总面积 119196 m2,定日镜 3311 面。
**baseline 解法大概是什么:**baseline 用几何解析和太阳运动参数方程做一个简化镜场拟合,再从几何约束中估计设计参数。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/方程 + 物理仿真 + 运筹优化 | 太阳高度角和 DNI 大气辐照模型 + 镜面余弦、遮挡、截断效率的几何光学模型;用坐标附件做数值复现。 | numpy、openpyxl | 实际 baseline agent artifact;题目基准描述:baseline 用几何解析和太阳运动参数方程做一个简化镜场拟合,再从几何约束中估计设计参数。 |
| O:O 奖复现 | 解析几何/方程 + 物理仿真 + 运筹优化 | 几何光学效率代理 + O 奖目标校准 + 固定、优化、可变布局的镜场设计汇总。 | matplotlib、numpy、pandas | 来自 O 奖论文 A175 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 解析几何/方程 + 物理仿真 + 运筹优化 | 太阳轨迹采样 + 向量反射/圆柱接收器射线追踪 + 镜场遮挡校正。 | numpy、scipy | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.738213 = 0.261787。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.738213 | 73.82% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 1.09735 | 100.00% | +35.91 pp | 100.00% |
| Kimi K3 | 0.975341 | 97.53% | +23.71 pp | 90.58% |
| Qwen3.8 27B | 1.24453 | 100.00% | +50.63 pp | 100.00% |
| DeepSeek Flash (opencode) | 1.10393 | 100.00% | +36.57 pp | 100.00% |
| Hy4 Preview | 1.464 | 100.00% | +72.58 pp | 100.00% |
| GPT-5.6 Sol | 0.971969 | 97.20% | +23.38 pp | 89.29% |
| v4 pro | 1.31294 | 100.00% | +57.47 pp | 100.00% |
| GPT-5.6 Sol XH | 0 | 0.00% | -73.82 pp | -100.00% |
| GLM-5.3 | 1.39354 | 100.00% | +65.53 pp | 100.00% |
| ox-alpha | 0 | 0.00% | -73.82 pp | -100.00% |
| Gemini 3.7 Flash | 0.96901 | 96.90% | +23.08 pp | 88.16% |
| Qwen3.8 Flash (Bailian) | 1.45586 | 100.00% | +71.77 pp | 100.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `reproduced.design_summary[2].annual_optical_efficiency` | 越高越好 | 0.496428 / 分 1 | 0.456517 / 分 0.7504 | 0.527651 / 分 1.23126 | 0.5094 / 分 1.10265 | 0.5251 / 分 1.21425 | 0.5264 / 分 1.22296 | 0.702888 / 分 2.00081 | 0.513639 / 分 1.13403 | 0.562315 / 分 1.43764 | 无 artifact | 0.533961 / 分 1.27215 | 无 artifact | 0.4749 / 分 0.8479 | 0.5678 / 分 1.46673 |
| `reproduced.design_summary[2].mirror_area_m2` | 越低越好 | 119,196 / 分 1 | 121,176 / 分 0.8784 | 117,576 / 分 1.10729 | 120,168 / 分 0.9364 | 117,012 / 分 1.1421 | 117,288 / 分 1.12522 | 88,745 / 分 2.14069 | 120,400 / 分 0.9224 | 111,276 / 分 1.44065 | 无 artifact | 113,707 / 分 1.3248 | 无 artifact | 120,780 / 分 0.9003 | 108,402 / 分 1.56226 |
| `reproduced.design_summary[2].mirror_count` | 越低越好 | 3,311 / 分 1 | 3,366 / 分 0.8784 | 3,266 / 分 1.10729 | 3,338 / 分 0.9364 | 2,786 / 分 1.84215 | 3,258 / 分 1.12522 | 4,306 / 分 0.2854 | 3,375 / 分 0.8613 | 3,091 / 分 1.44065 | 无 artifact | 2,321 / 分 2.25039 | 无 artifact | 2,805 / 分 1.82133 | 2,670 / 分 1.96062 |
| `reproduced.design_summary[2].unit_area_power_kw_m2` | 越高越好 | 0.506192 / 分 1 | 0.443946 / 分 0.6584 | 0.515138 / 分 1.0719 | 0.4993 / 分 0.9457 | 0.5134 / 分 1.05833 | 0.5136 / 分 1.0599 | 0.679762 / 分 1.89462 | 0.50041 / 分 0.954 | 0.544185 / 分 1.27506 | 无 artifact | 0.527675 / 分 1.16469 | 无 artifact | 0.4551 / 分 0.7014 | 0.5536 / 分 1.33294 |
| `target_comparison.q3_annual_thermal_power_mw.actual` | 越接近越好 | 60.3361 / 分 1 | 53.7955 / 分 0.5254 | 60.5678 / 分 0.969 | 60 / 分 0.9556 | 60.08 / 分 0.9658 | 60.236 / 分 0.9864 | 60.3254 / 分 0.9985 | 60.2494 / 分 0.9882 | 60.5548 / 分 0.9707 | 无 artifact | 60.0002 / 分 0.9557 | 无 artifact | 54.966 / 分 0.5742 | 60.009 / 分 0.9568 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2023 B: 多波束测线布设
任务 slug:`cumcm-2023-b-multibeam-lines`
**这题在问什么:**给定真实海深数据,设计测线方案,尽量减少测线总长度,同时控制漏测面积和重叠过大的测线长度。
**BO/O 答案是什么:**O 奖复现的核心方案总测线长度 622.0 海里,漏测面积 3.48%,重叠超过 20% 的测线长度 30.0 海里,平均重叠率约 10.48%。
**baseline 解法大概是什么:**baseline 先用数据拟合近似海底地形,再用规则化/贪心测线布置估计覆盖质量。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/方程 + 运筹优化 | 局部平面海底上的多波束扇形覆盖几何;按等深线和重叠率规则做贪心测线布设。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 先用数据拟合近似海底地形,再用规则化/贪心测线布置估计覆盖质量。 |
| O:O 奖复现 | 解析几何/方程 + 运筹优化 | 多波束覆盖宽度公式 + 贪心线距 + 模拟退火对比,并按 O 奖测线长度、漏测率和重叠率校准。 | matplotlib、numpy、pandas | 来自 O 奖论文 B226 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 解析几何/方程 + 运筹优化 | 局部平面射线-海底相交模型 + 不对称半幅覆盖 + 区间重叠计算 + 贪心测线搜索。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.4924,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.4924 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 2.543 | 100.00% | +105.06 pp | 10.00% |
| Kimi K3 | 1.41039 | 100.00% | -8.20 pp | -8.20% |
| Qwen3.8 27B | 1.50182 | 100.00% | +0.94 pp | 0.94% |
| DeepSeek Flash (opencode) | 1.5661 | 100.00% | +7.37 pp | 7.37% |
| Hy4 Preview | 2.34986 | 100.00% | +85.75 pp | 10.00% |
| GPT-5.6 Sol | 2.42566 | 100.00% | +93.33 pp | 10.00% |
| v4 pro | 1.49607 | 100.00% | +0.37 pp | 0.37% |
| GPT-5.6 Sol XH | 1.46314 | 100.00% | -2.93 pp | -2.93% |
| GLM-5.3 | 1.50067 | 100.00% | +0.83 pp | 0.83% |
| ox-alpha | 1.50062 | 100.00% | +0.82 pp | 0.82% |
| Gemini 3.7 Flash | 1.49642 | 100.00% | +0.40 pp | 0.40% |
| Qwen3.8 Flash (Bailian) | 1.54273 | 100.00% | +5.03 pp | 5.03% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `reproduced.problem4_summary.overlap_over_20pct_length_nautical_miles` | 越低越好 | 30 / 分 1 | 162.22 / 分 0.02651 | 0 / 分 3.23359 | 319.46 / 分 0.01228 | 147.98 / 分 0.02961 | 39.58 / 分 0.2731 | 0.3816 / 分 3.22217
需复核: review_extreme_actual_oracle_ratio | 0 / 分 3.23359 | 156.13 / 分 0.02775 | 196.92 / 分 0.02111 | 151.167 / 分 0.02885 | 151.9 / 分 0.02869 | 156.58 / 分 0.02765 | 102.195 / 分 0.0475 |
| `reproduced.problem4_summary.sa_avg_overlap_pct` | 越接近越好 | 10.48 / 分 1 | 28.6623 / 分 0.06469 | 10.3441 / 分 0.9025 | 47.517 / 分 0.03284 | 26.28 / 分 0.07373 | 6.834 / 分 0.2565 | 16.4288 / 分 0.1745 | 12.0574 / 分 0.4436 | 28.4878 / 分 0.06528 | 45.879 / 分 0.03431 | 27.2229 / 分 0.06986 | 27.2259 / 分 0.06985 | 28.01 / 分 0.06694 | 17.984 / 分 0.1435 |
| `target_comparison.problem4_missed_area_pct.actual` | 越低越好 | 3.48 / 分 1 | 0 / 分 3.23359 | 0 / 分 3.23359 | 0 / 分 3.23359 | 0 / 分 3.23359 | 0.6875 / 分 3.03953 | 1e-06 / 分 3.23359
需复核: review_extreme_actual_oracle_ratio | 6.57901e-09 / 分 3.23359
需复核: review_extreme_actual_oracle_ratio | 4.44089e-17 / 分 3.23359 | 0.00198212 / 分 3.23308
需复核: review_extreme_actual_oracle_ratio | 1.4184e-12 / 分 3.23359
需复核: review_extreme_actual_oracle_ratio | 0 / 分 3.23359 | 0.000618794 / 分 3.23343
需复核: review_extreme_actual_oracle_ratio | 0.00169 / 分 3.23316
需复核: review_extreme_actual_oracle_ratio |
| `target_comparison.problem4_total_length_nm.actual` | 越低越好 | 622 / 分 1 | 310 / 分 2.64482 | 244.04 / 分 2.80233 | 405 / 分 2.36284 | 300 / 分 2.67035 | 290 / 分 2.69525 | 258.7966 / 分 2.76918 | 248.75 / 分 2.79187 | 305 / 分 2.65767 | 340 / 分 2.56405 | 300 / 分 2.67035 | 300 / 分 2.67035 | 305 / 分 2.65767 | 268.519 / 分 2.74673 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2023 C: 蔬菜类商品定价
任务 slug:`cumcm-2023-c-vegetable-pricing`
**这题在问什么:**最后一问本身是让商超说明还应采集哪些数据、这些数据怎样帮助补货和定价;它主要是文字建议。
**BO/O 答案是什么:**当前数值 verifier 只看支撑这些建议的最后可量化补货定价结果:未来一周最大利润 5105.6 元,并选择 29 个单品进入补货定价方案。
**baseline 解法大概是什么:**baseline 用规划优化和资源配置模型,把可售空间、补货量和价格决策转成利润最大化问题。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 数据建模 + 运筹优化 | 线性需求回归 + 利润最大化的定价/补货优化。 | matplotlib、numpy、openpyxl、pandas、scipy、scikit-learn、xlrd | 实际 baseline agent artifact;题目基准描述:baseline 用规划优化和资源配置模型,把可售空间、补货量和价格决策转成利润最大化问题。 |
| O:O 奖复现 | 数据建模 + 运筹优化 | K-means++ 商品聚类 + 销量/加价率相关分析 + 线性价格-需求回归 + 网格搜索定价。 | matplotlib、numpy、pandas、scikit-learn | 来自 O 奖论文 C050 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 数据建模 + 运筹优化 | K-means 聚类 + OLS 需求定价回归 + 非线性/混合整数约束利润优化。 | matplotlib、numpy、openpyxl、pandas、scipy、scikit-learn、statsmodels | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=2.5503,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 2.5503 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 1.63508 | 100.00% | -91.52 pp | -10.00% |
| Kimi K3 | 1.13471 | 100.00% | -141.56 pp | -10.00% |
| Qwen3.8 27B | 1.29287 | 100.00% | -125.74 pp | -10.00% |
| DeepSeek Flash (opencode) | 1.71419 | 100.00% | -83.61 pp | -10.00% |
| Hy4 Preview | 0.963631 | 96.36% | -158.67 pp | -10.00% |
| GPT-5.6 Sol | 1.58994 | 100.00% | -96.04 pp | -10.00% |
| v4 pro | 0.597918 | 59.79% | -195.24 pp | -10.00% |
| GPT-5.6 Sol XH | 1.42736 | 100.00% | -112.29 pp | -10.00% |
| GLM-5.3 | 0.355098 | 35.51% | -219.52 pp | -10.00% |
| ox-alpha | 1.70757 | 100.00% | -84.27 pp | -10.00% |
| Gemini 3.7 Flash | 2.52343 | 100.00% | -2.69 pp | -2.69% |
| Qwen3.8 Flash (Bailian) | 1.75501 | 100.00% | -79.53 pp | -10.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `target_comparison.future_week_max_profit_yuan.actual` | 越高越好 | 5,105.6 / 分 1 | 27,722.65 / 分 4.63536 | 8,217.6656 / 分 2.80492 | 5,862.16 / 分 1.80418 | 6,371.6175 / 分 2.1205 | 8,856.14 / 分 2.96313 | 5,465.41 / 分 1.46202 | 7,896.15 / 分 2.71465 | 4,256.2218 / 分 0.419 | 6,951.4365 / 分 2.38948 | 3,217.1071 / 分 0.245 | 8,798.7708 / 分 2.9499 | 20,614.5 / 分 4.27008 | 9,227.31 / 分 3.04478 |
| `target_comparison.problem3_selected_item_count.actual` | 越接近越好 | 29 / 分 1 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 30 / 分 0.7768 | 33 / 分 0.4652 | 33 / 分 0.4652 | 33 / 分 0.4652 | 30 / 分 0.7768 | 33 / 分 0.4652 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2024 A: 板凳龙调头
任务 slug:`cumcm-2024-a-dragon-dance`
**这题在问什么:**沿着前面求出的调头路径行进时,求龙头最大能跑多快,才能保证所有把手速度都不超过 2 m/s。
**BO/O 答案是什么:**O 奖论文给出的最大龙头速度约 1.406276 m/s(速度比例常数 k = 2 / v_max ≈ 1.422195)。
**baseline 解法大概是什么:**baseline 用几何解析和运动学参数方程,沿路径传播各把手位置,再由速度约束反推龙头速度上限。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/方程 + 运动学 | 阿基米德螺线弧长参数化 + 刚体板凳运动学 + 速度约束反推。 | openpyxl | 实际 baseline agent artifact;题目基准描述:baseline 用几何解析和运动学参数方程,沿路径传播各把手位置,再由速度约束反推龙头速度上限。 |
| O:O 奖复现 | 解析几何/方程 + 运动学 | 等距螺线弧长反解 + 把手递推 + 非相邻碰撞检测 + 螺距搜索 + 速度比例缩放。 | matplotlib、numpy、pandas、scipy | 来自 O 奖论文 A016 的可运行复现/expected_result |
| Agent:Gemini 3.7 Flash | 解析几何/方程 + 运动学 | 非线性弧长反解 + 刚性弦长约束 + 多边形碰撞检测。 | matplotlib、numpy、openpyxl、pandas、scipy、shapely | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.34759,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.34759 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| Kimi K3 | 0.0753897 | 7.54% | -127.22 pp | -10.00% |
| Qwen3.8 27B | 0.498231 | 49.82% | -84.94 pp | -10.00% |
| DeepSeek Flash (opencode) | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| Hy4 Preview | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| GPT-5.6 Sol | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| v4 pro | 0.999998 | 100.00% | -34.76 pp | -10.00% |
| GPT-5.6 Sol XH | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| GLM-5.3 | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| ox-alpha | 0.498202 | 49.82% | -84.94 pp | -10.00% |
| Gemini 3.7 Flash | 1 | 100.00% | -34.76 pp | -10.00% |
| Qwen3.8 Flash (Bailian) | 0.498202 | 49.82% | -84.94 pp | -10.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.q5.max_head_speed_mps` | 越高越好 | 1.40628 / 分 1 | 1.91 / 分 2.38253 | 1.24627 / 分 0.5133 | 0.241298 / 分 0.1265 | 1.24628 / 分 0.5133 | 1.24627 / 分 0.5133 | 1.24627 / 分 0.5133 | 1.24627 / 分 0.5133 | 1.40628 / 分 1 | 1.24627 / 分 0.5133 | 1.24627 / 分 0.5133 | 1.24627 / 分 0.5133 | 1.40628 / 分 1 | 1.24627 / 分 0.5133 |
| `experiment_result.q5.max_speed_ratio_when_head_1mps` | 越接近越好 | 1.4222 / 分 1 | 1.047 / 分 0.3127 | 1.60479 / 分 0.4831 | 8.28851 / 分 0.02425 | 1.60477 / 分 0.4831 | 1.60479 / 分 0.4831 | 1.60479 / 分 0.4831 | 1.60479 / 分 0.4831 | 1.4222 / 分 1 | 1.60479 / 分 0.4831 | 1.60479 / 分 0.4831 | 1.60479 / 分 0.4831 | 1.4222 / 分 1 | 1.60479 / 分 0.4831 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2024 B: 生产过程抽检与决策
任务 slug:`cumcm-2024-b-production-decision`
**这题在问什么:**把零配件和成品次品率看成抽样估出来的不确定量,然后重新求问题 2 和问题 3 的最优检测、装配、拆解决策。
**BO/O 答案是什么:**O 奖复现用 3 组后验缺陷率情景重算利润:Q2 case1 利润约 25.9691、25.8694、25.7715;Q3 最优策略后验利润约 86.8529、86.5588、86.2647。
**baseline 解法大概是什么:**baseline 用二项抽样/贝叶斯后验估计次品率,再用期望利润枚举和多阶段决策搜索求最优策略。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 统计推断 + 运筹优化/决策 | 二项分布抽样检验 + 期望利润递推/枚举 + 拆解决策搜索。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用二项抽样/贝叶斯后验估计次品率,再用期望利润枚举和多阶段决策搜索求最优策略。 |
| O:O 奖复现 | 统计推断 + 运筹优化/决策 | 二项假设检验 + 期望利润枚举 + 状态-决策遗传搜索 + Beta 后验更新。 | matplotlib、numpy、pandas、scipy | 来自 O 奖论文 B159 的可运行复现/expected_result |
| Agent:Qwen3.8 27B | 统计推断 + 运筹优化/决策 | Clopper-Pearson 单侧二项置信规则 + 检验功效设计 + 期望利润/返修拆解决策优化。 | matplotlib、numpy、openpyxl、pandas、scipy | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0 = 1。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0 | 0.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.788883 | 78.89% | +78.89 pp | 78.89% |
| Kimi K3 | 0.943081 | 94.31% | +94.31 pp | 94.31% |
| Qwen3.8 27B | 1.44569 | 100.00% | +144.57 pp | 100.00% |
| DeepSeek Flash (opencode) | 0.737706 | 73.77% | +73.77 pp | 73.77% |
| Hy4 Preview | 0.366504 | 36.65% | +36.65 pp | 36.65% |
| GPT-5.6 Sol | 0.444542 | 44.45% | +44.45 pp | 44.45% |
| v4 pro | 0.318573 | 31.86% | +31.86 pp | 31.86% |
| GPT-5.6 Sol XH | 0.479172 | 47.92% | +47.92 pp | 47.92% |
| GLM-5.3 | 0.257329 | 25.73% | +25.73 pp | 25.73% |
| ox-alpha | 0.390214 | 39.02% | +39.02 pp | 39.02% |
| Gemini 3.7 Flash | 0.469069 | 46.91% | +46.91 pp | 46.91% |
| Qwen3.8 Flash (Bailian) | 0 | 0.00% | +0.00 pp | -100.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.q4.posterior_rows[0].q2_best_profit_case1` | 越高越好 | 25.9691 / 分 1 | 无 artifact | 26.6924 / 分 1.20873 | 26.4171 / 分 1.13432 | 27.6194 / 分 1.42499 | 26.9592 / 分 1.2759 | 24.4854 / 分 0.6775 | 25.1307 / 分 0.788 | 23.3696 / 分 0.5452 | 25.6826 / 分 0.9158 | 22.3441 / 分 0.4623 | 24.1494 / 分 0.6313 | 24.0993 / 分 0.625 | 无 artifact |
| `experiment_result.q4.posterior_rows[0].q3_best_policy_profit_under_posterior` | 越高越好 | 86.8529 / 分 1 | 无 artifact | 86.3743 / 分 0.9561 | 90.6398 / 分 1.30994 | 98.6291 / 分 1.75608 | 88.1187 / 分 1.11462 | 73.9907 / 分 0.4476 | 80.8201 / 分 0.6334 | 68.9831 / 分 0.3684 | 82.2811 / 分 0.6951 | 62.7448 / 分 0.3018 | 76.6675 / 分 0.5057 | 77.7896 / 分 0.5349 | 无 artifact |
| `experiment_result.q4.posterior_rows[1].q2_best_profit_case1` | 越高越好 | 25.8694 / 分 1 | 无 artifact | 25.317 / 分 0.8489 | 23.7692 / 分 0.5965 | 27.2215 / 分 1.36155 | 24.7466 / 分 0.7344 | 20.4692 / 分 0.365 | 21.2324 / 分 0.401 | 18.5079 / 分 0.2966 | 20.3757 / 分 0.3611 | 17.8629 / 分 0.2794 | 20.3405 / 分 0.3596 | 22.3374 / 分 0.4678 | 无 artifact |
| `experiment_result.q4.posterior_rows[1].q3_best_policy_profit_under_posterior` | 越高越好 | 86.5588 / 分 1 | 无 artifact | 80.4327 / 分 0.629 | 88.6841 / 分 1.18616 | 93.2924 / 分 1.49973 | 77.9353 / 分 0.5464 | 57.0648 / 分 0.2605 | 64.5483 / 分 0.3206 | 59 / 分 0.2737 | 67.9535 / 分 0.3583 | 46.6109 / 分 0.2064 | 64.4756 / 分 0.3199 | 73.5791 / 分 0.4445 | 无 artifact |
| `experiment_result.q4.posterior_rows[2].q2_best_profit_case1` | 越高越好 | 25.7715 / 分 1 | 无 artifact | 23.8691 / 分 0.6191 | 21.5173 / 分 0.4209 | 26.8051 / 分 1.28835 | 21.0644 / 分 0.3965 | 17.0845 / 分 0.2625 | 18.3198 / 分 0.2933 | 13.8601 / 分 0.2061 | 17.6341 / 分 0.2754 | 11.6857 / 分 0.18 | 16.8862 / 分 0.2582 | 20.4424 / 分 0.3672 | 无 artifact |
| `experiment_result.q4.posterior_rows[2].q3_best_policy_profit_under_posterior` | 越高越好 | 86.2647 / 分 1 | 无 artifact | 74.6558 / 分 0.4714 | 86.3756 / 分 1.01066 | 90.5071 / 分 1.34346 | 67.7368 / 分 0.3584 | 40.9473 / 分 0.186 | 51.7936 / 分 0.2309 | 49.8571 / 分 0.2214 | 58.1951 / 分 0.2694 | 5.88401 / 分 0.1141 | 57.7778 / 分 0.2665 | 69.0139 / 分 0.375 | 无 artifact |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2024 C: 农作物种植策略
任务 slug:`cumcm-2024-c-crop-planting`
**这题在问什么:**2024-2030 年最优种植方案:超产分别按(1)滞销浪费、(2)按 2023 年价格 50% 降价出售,求两种情形下七年总利润最大的种植策略。
**BO/O 答案是什么:**本题为 special case:O 奖论文的完整约束集(含其自创的“实际产量≥0.9×预期销量”)在官方附件上不可行,且论文使用未公开的启发式,其汇报值无法忠实复现。评分锚点改为一套可复现的精确求解结果:按论文式(19)的逐地块销量封顶建模(min(x·y, d) 在逐地块求和之内),用 HiGHS 混合整数规划求解,滞销情境七年总利润约 36271603 元、50% 降价情境约 43282389 元(MIP gap < 1%)。
**baseline 解法大概是什么:**baseline 用规划优化和资源配置模型,在候选种植方案间比较收益与风险。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 运筹优化 + 不确定性仿真 | 模式化种植组合优化 + Monte Carlo 场景仿真,用来评估收益和风险。 | openpyxl、scipy | 实际 baseline agent artifact;题目基准描述:baseline 用规划优化和资源配置模型,在候选种植方案间比较收益与风险。 |
| O:O 奖复现 | 运筹优化 + 不确定性仿真 | 附件清洗 + 候选种植组合 + 贪心/风险调整优化 + Monte Carlo 情景 + CVaR 风险度量 + Spearman 相关性。 | numpy、pandas、scipy | 来自 O 奖论文 C038 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 运筹优化 + 不确定性仿真 | 七年混合整数线性规划(MILP):地块-季次-作物面积连续变量、种植选择二元变量和模式变量,目标是利润最大化。 | matplotlib、numpy、openpyxl、pandas、scipy | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.631481 = 0.368519。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.631481 | 63.15% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 1.36157 | 100.00% | +73.01 pp | 100.00% |
| Kimi K3 | 1.07645 | 100.00% | +44.50 pp | 100.00% |
| Qwen3.8 27B | 1.08109 | 100.00% | +44.96 pp | 100.00% |
| DeepSeek Flash (opencode) | 1.59377 | 100.00% | +96.23 pp | 100.00% |
| Hy4 Preview | 0.625186 | 62.52% | -0.63 pp | -1.71% |
| GPT-5.6 Sol | 0.918474 | 91.85% | +28.70 pp | 77.88% |
| v4 pro | 1.44853 | 100.00% | +81.71 pp | 100.00% |
| GPT-5.6 Sol XH | 1.01501 | 100.00% | +38.35 pp | 100.00% |
| GLM-5.3 | 0.45566 | 45.57% | -17.58 pp | -47.71% |
| ox-alpha | 1.12188 | 100.00% | +49.04 pp | 100.00% |
| Gemini 3.7 Flash | 0.756826 | 75.68% | +12.53 pp | 34.01% |
| Qwen3.8 Flash (Bailian) | 0.939687 | 93.97% | +30.82 pp | 83.63% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.q1.discount_profit_yuan` | 越高越好 | 58,718,967.38 / 分 1 | 58,848,169.12 / 分 1.01817 | 66,485,662.25 / 分 1.743 | 61,956,466.66 / 分 1.37807 | 58,538,452 / 分 0.975 | 70,378,275.83 / 分 1.97632 | 55,769,227.53 / 分 0.7049 | 58,606,354.01 / 分 0.9843 | 70,728,213.38 / 分 1.99486 | 55,710,951.75 / 分 0.7008 | 49,136,565.25 / 分 0.4237 | 59,793,910.68 / 分 1.14198 | 59,990,306 / 分 1.16588 | 57,407,205 / 分 0.8431 |
| `experiment_result.q1.waste_profit_yuan` | 越高越好 | 40,418,876.72 / 分 1 | 25,455,306.25 / 分 0.2448 | 40,320,587 / 分 0.9801 | 39,009,319.86 / 分 0.7748 | 41,417,113.2 / 分 1.18715 | 41,559,514.89 / 分 1.21121 | 36,377,121.89 / 分 0.5455 | 39,580,872.27 / 分 0.8527 | 39,893,151.41 / 分 0.9022 | 42,309,825.25 / 分 1.32921 | 35,321,475.25 / 分 0.4876 | 40,938,579.89 / 分 1.10179 | 31,322,604.25 / 分 0.3478 | 40,598,282.5 / 分 1.03632 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2025 A: 烟幕遮蔽导弹
任务 slug:`cumcm-2025-a-smoke-screen`
**这题在问什么:**5 架无人机、每架最多 3 枚烟幕弹,同时对 3 枚导弹实施遮蔽,求总体遮蔽时间尽量长的投放方案。
**BO/O 答案是什么:**O 奖复现的联合遮蔽时长为 M1 10.3 s、M2 6.2 s、M3 3.4 s,总计 19.9 s。
**baseline 解法大概是什么:**baseline 用轨迹几何和规划优化,把无人机速度、航向、投放时刻、起爆时刻一起搜索,最大化有效遮蔽时长。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/方程 + 运动学 + 运筹优化 | 三维运动学轨迹 + 视线-烟球相交判定 + 紧凑搜索投放参数。 | openpyxl | 实际 baseline agent artifact;题目基准描述:baseline 用轨迹几何和规划优化,把无人机速度、航向、投放时刻、起爆时刻一起搜索,最大化有效遮蔽时长。 |
| O:O 奖复现 | 解析几何/方程 + 运动学 + 运筹优化 | 三维运动学 + 圆柱目标视线遮蔽判定 + 随机搜索 + 多弹贪心分配。 | matplotlib、numpy、pandas | 来自 O 奖论文 A196 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 解析几何/方程 + 运动学 + 运筹优化 | 弹道释放 + 下沉烟球 + 采样圆柱视线并集优化,目标为有效遮蔽时间并集。 | numpy、openpyxl、scipy | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.52799,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.52799 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 1.82929 | 100.00% | +30.13 pp | 10.00% |
| Kimi K3 | 2.89404 | 100.00% | +136.60 pp | 10.00% |
| Qwen3.8 27B | 2.59182 | 100.00% | +106.38 pp | 10.00% |
| DeepSeek Flash (opencode) | 3.57824 | 100.00% | +205.03 pp | 10.00% |
| Hy4 Preview | 4.00403 | 100.00% | +247.60 pp | 10.00% |
| GPT-5.6 Sol | 3.41638 | 100.00% | +188.84 pp | 10.00% |
| v4 pro | 1.53237 | 100.00% | +0.44 pp | 0.44% |
| GPT-5.6 Sol XH | 0.939201 | 93.92% | -58.88 pp | -10.00% |
| GLM-5.3 | 0.854445 | 85.44% | -67.35 pp | -10.00% |
| ox-alpha | 2.55266 | 100.00% | +102.47 pp | 10.00% |
| Gemini 3.7 Flash | 1.23928 | 100.00% | -28.87 pp | -10.00% |
| Qwen3.8 Flash (Bailian) | 0 | 0.00% | -152.80 pp | -100.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.q5_union_duration_s.M1` | 越高越好 | 10.3 / 分 1 | 13.16 / 分 2.19813 | 8.53071 / 分 0.4113 | 11.1 / 分 1.49911 | 7.703 / 分 0.3225 | 16.251 / 分 2.76039 | 27.543 / 分 3.70475 | 17.8668 / 分 2.9632 | 5.97825 / 分 0.2224 | 7.6 / 分 0.314 | 6.6904 / 分 0.2551 | 18.295 / 分 3.01069 | 5.0659 / 分 0.191 | 无 artifact |
| `experiment_result.q5_union_duration_s.M2` | 越高越好 | 6.2 / 分 1 | 7.6 / 分 2.05839 | 9.98433 / 分 2.80607 | 14.865 / 分 3.53738 | 12.0755 / 分 3.18573 | 17.601 / 分 3.79263 | 20.9208 / 分 4.03428 | 13.1348 / 分 3.33418 | 8.51003 / 分 2.41218 | 3.06 / 分 0.1916 | 3.91439 / 分 0.2456 | 5.265 / 分 0.4431 | 6.4811 / 分 1.3205 | 无 artifact |
| `experiment_result.q5_union_duration_s.M3` | 越高越好 | 3.4 / 分 1 | 1.47 / 分 0.1745 | 4.45061 / 分 2.27397 | 8.405 / 分 3.58529 | 11.874 / 分 4.08051 | 13.391 / 分 4.2382 | 14.4207 / 分 4.33262 | 11.3905 / 分 4.02454 | 5.06029 / 分 2.62321 | 5.6 / 分 2.85507 | 4.93947 / 分 2.56302 | 10.04 / 分 3.84923 | 5.8739 / 分 2.95494 | 无 artifact |
| `experiment_result.q5_union_duration_s.total` | 越高越好 | 19.9 / 分 1 | 22.23 / 分 1.68093 | 22.9656 / 分 1.82583 | 34.37 / 分 2.95437 | 31.6525 / 分 2.77859 | 47.243 / 分 3.52173 | 62.8845 / 分 3.94445 | 42.3921 / 分 3.34361 | 19.5486 / 分 0.8717 | 16.26 / 分 0.3962 | 15.5443 / 分 0.3541 | 33.6 / 分 2.90762 | 17.4209 / 分 0.4906 | 无 artifact |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2025 B: 外延层厚度反演
任务 slug:`cumcm-2025-b-sic-thickness`
**这题在问什么:**把多光束反射/透射造成的干涉也考虑进去,重新确定碳化硅外延层厚度,并分析结果可靠性。
**BO/O 答案是什么:**O 奖论文推荐厚度为 SiC 约 7.604 um、Si 约 3.814 um。
**baseline 解法大概是什么:**baseline 用数据拟合与回归分析,从光谱条纹周期和非线性拟合中反推出外延层厚度。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/物理反演 + 数据拟合 | 双光束干涉测厚 + Airy 多光束修正。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用数据拟合与回归分析,从光谱条纹周期和非线性拟合中反推出外延层厚度。 |
| O:O 奖复现 | 解析几何/物理反演 + 数据拟合 | Snell/Fresnel 光学 + Cauchy 色散模型 + FFT 初值 + 非线性最小二乘 + Airy 多光束修正。 | matplotlib、numpy、pandas、scipy | 来自 O 奖论文 B157 的可运行复现/expected_result |
| Agent:Kimi K3 | 解析几何/物理反演 + 数据拟合 | 广义 Airy 多光束反射率模型 + 光谱非线性拟合 + 外延层厚度反演。 | matplotlib、numpy、openpyxl、pandas、scipy | 本题 O-Eval 72.98%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.762319 = 0.237681。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.762319 | 76.23% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.704257 | 70.43% | -5.81 pp | -24.43% |
| Kimi K3 | 0.729831 | 72.98% | -3.25 pp | -13.67% |
| Qwen3.8 27B | 0.357013 | 35.70% | -40.53 pp | -100.00% |
| DeepSeek Flash (opencode) | 0.668246 | 66.82% | -9.41 pp | -39.58% |
| Hy4 Preview | 0.561223 | 56.12% | -20.11 pp | -84.61% |
| GPT-5.6 Sol | 0.537264 | 53.73% | -22.51 pp | -94.69% |
| v4 pro | 0.109821 | 10.98% | -65.25 pp | -100.00% |
| GPT-5.6 Sol XH | 0.657456 | 65.75% | -10.49 pp | -44.12% |
| GLM-5.3 | 0.703334 | 70.33% | -5.90 pp | -24.82% |
| ox-alpha | 0.691962 | 69.20% | -7.04 pp | -29.60% |
| Gemini 3.7 Flash | 0.722558 | 72.26% | -3.98 pp | -16.73% |
| Qwen3.8 Flash (Bailian) | 0.664995 | 66.50% | -9.73 pp | -40.95% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.si_recommended_thickness_um` | 越接近越好 | 3.7899 / 分 1 | 3.38 / 分 0.526 | 3.49649 / 分 0.6078 | 3.8 / 分 0.9783 | 3.4391 / 分 0.5645 | 3.42 / 分 0.5515 | 3.3816 / 分 0.5269 | 3.37611 / 分 0.5236 | 7.87019 / 分 0.1003 | 3.38354 / 分 0.5281 | 3.41874 / 分 0.5506 | 3.42229 / 分 0.553 | 3.4836 / 分 0.5975 | 3.55 / 分 0.6547 |
| `experiment_result.sic_recommended_thickness_um` | 越接近越好 | 7.5712 / 分 1 | 7.57 / 分 0.9987 | 7.79739 / 分 0.8007 | 8.55 / 分 0.4814 | 12.7405 / 分 0.1495 | 7.82 / 分 0.785 | 8.1883 / 分 0.5955 | 6.83062 / 分 0.5509 | 14.2745 / 分 0.1194 | 7.8174 / 分 0.7868 | 7.72399 / 分 0.856 | 7.75608 / 分 0.8309 | 7.7346 / 分 0.8476 | 8.008 / 分 0.6753 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### CUMCM 2025 C: 女胎 NIPT 异常判定
任务 slug:`cumcm-2025-c-nipt`
**这题在问什么:**对女胎样本,用染色体 Z 值、GC 含量、读段数、BMI 等指标判断胎儿是否异常。
**BO/O 答案是什么:**O 奖复现的女胎异常判定模型 leave-one-out accuracy 为 0.8659,F1 为 0.3721。
**baseline 解法大概是什么:**baseline 用综合评价和权重决策,把多项检测指标合成风险分数,再给出异常判定。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 数据建模/统计推断 + 综合评价/决策 | 男胎 Y 浓度 logit 线性模型 + 女胎 Z 值阈值判别 + BMI 分组时点决策。 | matplotlib、numpy、openpyxl、pandas、scipy、scikit-learn、statsmodels | 实际 baseline agent artifact;题目基准描述:baseline 用综合评价和权重决策,把多项检测指标合成风险分数,再给出异常判定。 |
| O:O 奖复现 | 数据建模/统计推断 + 综合评价/决策 | 胎儿浓度 logit 混合效应近似 + BMI 时点优化 + 女胎异常分类器。 | matplotlib、numpy、pandas、scipy、scikit-learn | 来自 O 奖论文 C023 的可运行复现/expected_result |
| Agent:Kimi K3 | 数据建模/统计推断 + 综合评价/决策 | REML 随机截距线性混合模型拟合 logit(Y 浓度) + BMI 分组风险时点预测 + 留一验证。 | matplotlib、numpy、openpyxl、pandas、scipy、scikit-learn、statsmodels | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.50636,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.50636 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.949136 | 94.91% | -55.72 pp | -10.00% |
| Kimi K3 | 1.2898 | 100.00% | -21.66 pp | -10.00% |
| Qwen3.8 27B | 1.52152 | 100.00% | +1.52 pp | 1.52% |
| DeepSeek Flash (opencode) | 1.23552 | 100.00% | -27.08 pp | -10.00% |
| Hy4 Preview | 1.18464 | 100.00% | -32.17 pp | -10.00% |
| GPT-5.6 Sol | 1.45242 | 100.00% | -5.39 pp | -5.39% |
| v4 pro | 1.36091 | 100.00% | -14.55 pp | -10.00% |
| GPT-5.6 Sol XH | 0.62605 | 62.60% | -88.03 pp | -10.00% |
| GLM-5.3 | 1.07118 | 100.00% | -43.52 pp | -10.00% |
| ox-alpha | 1.07306 | 100.00% | -43.33 pp | -10.00% |
| Gemini 3.7 Flash | 1.23407 | 100.00% | -27.23 pp | -10.00% |
| Qwen3.8 Flash (Bailian) | 1.28768 | 100.00% | -21.87 pp | -10.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.female_loo_accuracy` | 越高越好 | 0.8659 / 分 1 | 0.9007 / 分 1.25464 | 0.775207 / 分 0.5695 | 0.895868 / 分 1.22293 | 0.910744 / 分 1.31751 | 0.838 / 分 0.8114 | 0.861157 / 分 0.962 | 0.894215 / 分 1.21185 | 0.912397 / 分 1.32748 | 0.733884 / 分 0.4762 | 0.798347 / 分 0.6398 | 0.876033 / 分 1.08107 | 0.8909 / 分 1.18924 | 0.9056 / 分 1.28581 |
| `female_abnormality.leave_one_out_f1` | 越高越好 | 0.3721 / 分 1 | 0.5082 / 分 1.75808 | 0.418803 / 分 1.32872 | 0.423529 / 分 1.35668 | 0.5 / 分 1.72553 | 0.4842 / 分 1.65968 | 0.432432 / 分 1.40731 | 0.492063 / 分 1.693 | 0.430108 / 分 1.39433 | 0.337449 / 分 0.7759 | 0.45045 / 分 1.50254 | 0.380165 / 分 1.06505 | 0.4107 / 分 1.27889 | 0.4124 / 分 1.28956 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2023 A: 植物群落抗旱韧性
任务 slug:`mcm-2023-a-plant-community`
**这题在问什么:**综合物种数、干旱、污染和栖息地压力,说明怎样保证植物群落长期可生存。
**BO/O 答案是什么:**O 奖复现的核心量化结论包括最优/阈值物种数 2,beta 压力下生物量下降 32.0%,五物种均匀度 0.8826。
**baseline 解法大概是什么:**baseline 把物种数阈值、功能性状、干旱敏感性和污染/栖息地压力合成为管理前沿。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 微分方程/动力系统 + 生态仿真 | Lotka-Volterra 竞争动力系统 + 物种功能性状/干旱敏感性参数化。 | numpy | 实际 baseline agent artifact;题目基准描述:baseline 把物种数阈值、功能性状、干旱敏感性和污染/栖息地压力合成为管理前沿。 |
| O:O 奖复现 | 微分方程/动力系统 + 生态仿真 | Lotka-Volterra 启发的差分生态仿真 + 干旱脉冲 + 多样性稳定性校准。 | matplotlib、numpy、pandas | 来自 O 奖论文 2309229 的可运行复现/expected_result |
| Agent:Qwen3.8 27B | 微分方程/动力系统 + 生态仿真 | 离散年度群落动力学:物种生物量、干旱记忆和性状参数共同递推。 | matplotlib、numpy、pandas | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.63203,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.63203 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.702577 | 70.26% | -92.95 pp | -10.00% |
| Kimi K3 | 0.469546 | 46.95% | -116.25 pp | -10.00% |
| Qwen3.8 27B | 1.07044 | 100.00% | -56.16 pp | -10.00% |
| DeepSeek Flash (opencode) | 1.34086 | 100.00% | -29.12 pp | -10.00% |
| Hy4 Preview | 1.29643 | 100.00% | -33.56 pp | -10.00% |
| GPT-5.6 Sol | 1.36442 | 100.00% | -26.76 pp | -10.00% |
| v4 pro | 1.17942 | 100.00% | -45.26 pp | -10.00% |
| GPT-5.6 Sol XH | 1.36441 | 100.00% | -26.76 pp | -10.00% |
| GLM-5.3 | 1.53878 | 100.00% | -9.32 pp | -9.32% |
| ox-alpha | 1.16341 | 100.00% | -46.86 pp | -10.00% |
| Gemini 3.7 Flash | 0.545375 | 54.54% | -108.67 pp | -10.00% |
| Qwen3.8 Flash (Bailian) | 0.373162 | 37.32% | -125.89 pp | -10.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `target_comparison.beta_decline_pct.actual` | 越低越好 | 32 / 分 1 | 2.0207 / 分 3.17556 | 37.5859 / 分 0.4074 | 51.07 / 分 0.1676 | 14.5724 / 分 2.71171 | 3.764 / 分 3.12264 | 15.5953 / 分 2.66242 | 20.4702 / 分 2.38693 | 12.453 / 分 2.80671 | 20.3261 / 分 2.39626 | 1.87062 / 分 3.17999 | 15.2259 / 分 2.6805 | 35.63 / 分 0.5141 | 37.7449 / 分 0.4006 |
| `target_comparison.five_species_pielou_evenness.actual` | 越高越好 | 0.8826 / 分 1 | 0.999955 / 分 1.68207 | 0.987074 / 分 1.62627 | 0.90847 / 分 1.19522 | 0.7206 / 分 0.4255 | 0.8573 / 分 0.8259 | 0.902412 / 分 1.15281 | 0.9949 / 分 1.66054 | 0.810421 / 分 0.6244 | 0.986318 / 分 1.62289 | 0.941244 / 分 1.3979 | 0.8318 / 分 0.7026 | 0.8885 / 分 1.048 | 0.8214 / 分 0.6623 |
| `target_comparison.optimal_species_count.actual` | 越接近越好 | 2 / 分 1 | 8 / 分 0.03846 | 5 / 分 0.07407 | 7 / 分 0.0458 | 5 / 分 0.07407 | 5 / 分 0.07407 | 5 / 分 0.07407 | 7 / 分 0.0458 | 4 / 分 0.1071 | 5 / 分 0.07407 | 8 / 分 0.03846 | 4 / 分 0.1071 | 5 / 分 0.07407 | 6 / 分 0.0566 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2023 B: 马赛马拉保护区
任务 slug:`mcm-2023-b-maasai-mara`
**这题在问什么:**把土地分区和政策方案整理成给当地管理者的非技术报告,说明推荐方案的收益和用地分配。
**BO/O 答案是什么:**O 奖复现的方案 2 收益指标值约 154948.974,农业/狩猎/旅游/保护区格点数分别为 12、2、9、13。
**baseline 解法大概是什么:**baseline 用空间土地利用优化,把农业、狩猎、旅游和野生动物保护的格点分配成收益最大化问题。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 空间规划/图论网络 + 运筹优化 + 动力系统 | 元胞/格点空间分配的多目标规划 + Lotka-Volterra 生态动态 + 多准则决策。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用空间土地利用优化,把农业、狩猎、旅游和野生动物保护的格点分配成收益最大化问题。 |
| O:O 奖复现 | 空间规划/图论网络 + 运筹优化 + 动力系统 | 6x6 空间规划评分 + Dijkstra 交互距离 + 经济/生态场景效益校准。 | matplotlib、numpy、pandas | 来自 O 奖论文 2315379 的可运行复现/expected_result |
| Agent:DeepSeek Flash (opencode) | 空间规划/图论网络 + 运筹优化 + 动力系统 | 100 格点多目标功能分区 + 离散 logistic 野生动物、旅游和经济动态。 | matplotlib、numpy、pandas、pulp、scipy | 本题 O-Eval 13.03%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.102093 = 0.897907。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.102093 | 10.21% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.0334959 | 3.35% | -6.86 pp | -7.64% |
| Kimi K3 | 0.028745 | 2.87% | -7.33 pp | -8.17% |
| Qwen3.8 27B | 0.0240411 | 2.40% | -7.81 pp | -8.69% |
| DeepSeek Flash (opencode) | 0.13034 | 13.03% | +2.82 pp | 3.15% |
| Hy4 Preview | 0.0225035 | 2.25% | -7.96 pp | -8.86% |
| GPT-5.6 Sol | 0.0323553 | 3.24% | -6.97 pp | -7.77% |
| v4 pro | 0.0343714 | 3.44% | -6.77 pp | -7.54% |
| GPT-5.6 Sol XH | 0.0737116 | 7.37% | -2.84 pp | -3.16% |
| GLM-5.3 | 0.0681417 | 6.81% | -3.40 pp | -3.78% |
| ox-alpha | 0.0885694 | 8.86% | -1.35 pp | -1.51% |
| Gemini 3.7 Flash | 0.0633515 | 6.34% | -3.87 pp | -4.31% |
| Qwen3.8 Flash (Bailian) | 0.023241 | 2.32% | -7.89 pp | -8.78% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `target_comparison.scenario2_agriculture_cells.actual` | 越接近越好 | 12 / 分 1 | 42 / 分 0.0458 | 96 / 分 0.01685 | 630 / 分 0.002325
需复核: review_extreme_actual_oracle_ratio | 872 / 分 0.001672
需复核: review_extreme_actual_oracle_ratio | 14 / 分 0.4186 | 700 / 分 0.002089
需复核: review_extreme_actual_oracle_ratio | 100 / 分 0.0161 | 60 / 分 0.02913 | 30 / 分 0.07407 | 34 / 分 0.06143 | 19 / 分 0.1706 | 0 / 分 0.1071 | 250 / 分 0.006014 |
| `target_comparison.scenario2_benefit_million.actual` | 越高越好 | 154,948.974 / 分 1 | 25.3 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 50.9078 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 47.699 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 6,796.8 / 分 0.1115 | 178.36 / 分 0.1073
需复核: review_extreme_actual_oracle_ratio | 249.491 / 分 0.1073
需复核: review_extreme_actual_oracle_ratio | 16.8217 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 22.16 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 40.69 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 31.3485 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 44.1259 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 82.4 / 分 0.1072
需复核: review_extreme_actual_oracle_ratio | 408.45 / 分 0.1074
需复核: review_extreme_actual_oracle_ratio |
| `target_comparison.scenario2_hunting_cells.actual` | 越接近越好 | 2 / 分 1 | 3 / 分 0.1935 | 16 / 分 0.01685 | 58 / 分 0.004267 | 100 / 分 0.002443 | 12 / 分 0.02344 | 518 / 分 0.0004649
需复核: review_extreme_actual_oracle_ratio | 60 / 分 0.004121 | 16 / 分 0.01685 | 10 / 分 0.02913 | 10 / 分 0.02913 | 10 / 分 0.02913 | 16 / 分 0.01685 | 1,204 / 分 0.0001996
需复核: review_extreme_actual_oracle_ratio |
| `target_comparison.scenario2_tourism_cells.actual` | 越接近越好 | 9 / 分 1 | 30 / 分 0.04891 | 64 / 分 0.01926 | 67 / 分 0.01828 | 1,080 / 分 0.001007
需复核: review_extreme_actual_oracle_ratio | 26 / 分 0.05973 | 1,000 / 分 0.001089
需复核: review_extreme_actual_oracle_ratio | 50 / 分 0.02567 | 104 / 分 0.01124 | 18 / 分 0.1071 | 25 / 分 0.06323 | 19 / 分 0.09747 | 30 / 分 0.04891 | 736 / 分 0.001483
需复核: review_extreme_actual_oracle_ratio |
| `target_comparison.scenario2_wildlife_cells.actual` | 越接近越好 | 13 / 分 1 | 25 / 分 0.115 | 224 / 分 0.007339 | 145 / 分 0.01168 | 448 / 分 0.003573 | 48 / 分 0.04267 | 1,000 / 分 0.001578
需复核: review_extreme_actual_oracle_ratio | 190 / 分 0.008737 | 220 / 分 0.00748 | 42 / 分 0.05105 | 31 / 分 0.07975 | 52 / 分 0.03846 | 54 / 分 0.03665 | 1,414 / 分 0.001112
需复核: review_extreme_actual_oracle_ratio |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2023 C: Wordle 难度评估
任务 slug:`mcm-2023-c-wordle`
**这题在问什么:**在给纽约时报编辑的总结信之前,最后一个可量化核心是判断 EERIE 的难度,并给出难度分类模型准确率。
**BO/O 答案是什么:**O 奖复现把 EERIE 判为中等难度组 2,难度分类模型 holdout accuracy 为 0.7。
**baseline 解法大概是什么:**baseline 用报告量时间序列、单词属性特征和分类模型来预测 Wordle 分布及难度等级。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 数据建模/时间序列 + 分类/聚类 | 带星期效应的对数线性时间序列预测 + 词特征 KNN 难度估计。 | numpy、openpyxl、pandas、scipy、scikit-learn | 实际 baseline agent artifact;题目基准描述:baseline 用报告量时间序列、单词属性特征和分类模型来预测 Wordle 分布及难度等级。 |
| O:O 奖复现 | 数据建模/时间序列 + 分类/聚类 | 移动平均差分预测 + 单词词汇特征 + K-means 难度聚类 + 树模型分类。 | matplotlib、numpy、pandas、scikit-learn | 来自 O 奖论文 2307946 的可运行复现/expected_result |
| Agent:Hy4 Preview | 数据建模/时间序列 + 分类/聚类 | 峰后对数幂律衰减预测 + 星期效应 + 滚动校准 + 词特征难度分类。 | matplotlib、numpy、openpyxl、pandas、scikit-learn、statsmodels | 本题 O-Eval 98.31%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.224201 = 0.775799。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.224201 | 22.42% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.280001 | 28.00% | +5.58 pp | 7.19% |
| Kimi K3 | 0.246521 | 24.65% | +2.23 pp | 2.88% |
| Qwen3.8 27B | 0.58 | 58.00% | +35.58 pp | 45.86% |
| DeepSeek Flash (opencode) | 0.54604 | 54.60% | +32.18 pp | 41.48% |
| Hy4 Preview | 0.98308 | 98.31% | +75.89 pp | 97.82% |
| GPT-5.6 Sol | 0.723478 | 72.35% | +49.93 pp | 64.36% |
| v4 pro | 0.0979775 | 9.80% | -12.62 pp | -16.27% |
| GPT-5.6 Sol XH | 0.259776 | 25.98% | +3.56 pp | 4.59% |
| GLM-5.3 | 0.529999 | 53.00% | +30.58 pp | 39.42% |
| ox-alpha | 0.56584 | 56.58% | +34.16 pp | 44.04% |
| Gemini 3.7 Flash | 0 | 0.00% | -22.42 pp | -100.00% |
| Qwen3.8 Flash (Bailian) | 0.0654407 | 6.54% | -15.88 pp | -20.46% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `target_comparison.lightgbm_like_accuracy.actual` | 越高越好 | 0.7 / 分 1 | 0.4845 / 分 0.2242 | 0.5 / 分 0.28 | 0.4907 / 分 0.2465 | 0.583333 / 分 0.58 | 0.5739 / 分 0.546 | 0.6953 / 分 0.9831 | 0.623188 / 分 0.7235 | 0.449438 / 分 0.09798 | 0.494382 / 分 0.2598 | 0.569444 / 分 0.53 | 0.5794 / 分 0.5658 | 无 artifact | 0.4404 / 分 0.06544 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2024 A: 七鳃鳗生态影响
任务 slug:`mcm-2024-a-lamprey`
**这题在问什么:**判断七鳃鳗可变性别比例是否也会让生态系统中的其他生物受益,尤其是寄生者/宿主相关指标。
**BO/O 答案是什么:**O 奖复现的共存情景资源水平为 0.55,寄生者指数 8.562,宿主鱼指数 1080.356。
**baseline 解法大概是什么:**baseline 用生态动力系统仿真,把资源水平、性别比例、七鳃鳗、宿主鱼和寄生者一起演化。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 微分方程/动力系统 + 生态仿真 | 分阶段确定性常微分方程(ODE)种群模型 + Euler 数值积分。 | matplotlib | 实际 baseline agent artifact;题目基准描述:baseline 用生态动力系统仿真,把资源水平、性别比例、七鳃鳗、宿主鱼和寄生者一起演化。 |
| O:O 奖复现 | 微分方程/动力系统 + 生态仿真 | 资源驱动性别比 + 分阶段种群动力学 + Lotka-Volterra/Nicholson-Bailey 生态模型 + 稳定性指标。 | matplotlib、numpy、pandas | 来自 O 奖论文 2407093 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 微分方程/动力系统 + 生态仿真 | 四仓室食物网常微分方程(ODE)+ 四阶 Runge-Kutta(RK4)数值积分。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 本题 O-Eval 26.54%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.0701754 = 0.929825。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.0701754 | 7.02% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.265383 | 26.54% | +19.52 pp | 20.99% |
| Kimi K3 | 0.246711 | 24.67% | +17.65 pp | 18.99% |
| Qwen3.8 27B | 0.0701754 | 7.02% | +0.00 pp | 0.00% |
| DeepSeek Flash (opencode) | 0.0701754 | 7.02% | +0.00 pp | 0.00% |
| Hy4 Preview | 0.0155642 | 1.56% | -5.46 pp | -5.87% |
| GPT-5.6 Sol | 0.0701754 | 7.02% | +0.00 pp | 0.00% |
| v4 pro | 0.235294 | 23.53% | +16.51 pp | 17.76% |
| GPT-5.6 Sol XH | 0.0701754 | 7.02% | +0.00 pp | 0.00% |
| GLM-5.3 | 0.125 | 12.50% | +5.48 pp | 5.90% |
| ox-alpha | 0.0895894 | 8.96% | +1.94 pp | 2.09% |
| Gemini 3.7 Flash | 0.228957 | 22.90% | +15.88 pp | 17.08% |
| Qwen3.8 Flash (Bailian) | 0.108108 | 10.81% | +3.79 pp | 4.08% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.parasite_coexistence_case.final_parasite_index` | 越接近越好 | 8.562 / 分 1 | 0.436551 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 5.32608 / 分 0.241 | 6.1147 / 分 0.2957 | 0.523833 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.092707 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.05606 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.384952 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 1 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.593156 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.480867 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 69.7873 / 分 0.0165 | 5.3513 / 分 0.2424 | 0.7266 / 分 0
无效: invalid_normalized_value_for_raw_population_index |
| `experiment_result.parasite_coexistence_case.host_fish_index` | 越高越好 | 1,080.356 / 分 1 | 0.256981 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 39.0082 / 分 0.1107
需复核: review_index_scale_or_units | 0.395114 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.843327 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.422515 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 1 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.185551 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.501714 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.774634 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.845848 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 367.6338 / 分 0.1539 | 8.6612 / 分 0
无效: invalid_normalized_value_for_raw_population_index | 0.8596 / 分 0
无效: invalid_normalized_value_for_raw_population_index |
| `experiment_result.parasite_coexistence_case.resource_level` | 越接近越好 | 0.55 / 分 1 | 1 / 分 0.2105 | 0.4 / 分 0.4444 | 0.4 / 分 0.4444 | 1 / 分 0.2105 | 1 / 分 0.2105 | 3 / 分 0.04669 | 1 / 分 0.2105 | 0.6 / 分 0.7059 | 1 / 分 0.2105 | 0.75 / 分 0.375 | 1.65 / 分 0.09836 | 0.4 / 分 0.4444 | 0.3 / 分 0.3243 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2024 B: 潜水器搜索迁移
任务 slug:`mcm-2024-b-submersible-search`
**这题在问什么:**把潜水器搜索模型迁移到加勒比海场景,并说明洋流、海底地形和多潜水器协同时需要怎样调整。
**BO/O 答案是什么:**O 奖复现给出的加勒比海调整为洋流不确定性乘数 1.35、地形不确定性乘数 1.2。
**baseline 解法大概是什么:**baseline 用贝叶斯搜索规划,先估计位置后验,再按海流和地形不确定性调整搜索区域。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 随机仿真/贝叶斯搜索 + 综合评价/路径规划 | SIR 粒子滤波 + 平流扩散漂移模型 + 多准则装备评价 + 贝叶斯搜索更新。 | numpy | 实际 baseline agent artifact;题目基准描述:baseline 用贝叶斯搜索规划,先估计位置后验,再按海流和地形不确定性调整搜索区域。 |
| O:O 奖复现 | 随机仿真/贝叶斯搜索 + 综合评价/路径规划 | RK4 动力漂移 + Monte Carlo 粒子群 + 熵权装备评分 + Bayesian 搜索更新 + 类蚁群路径排序。 | matplotlib、numpy、pandas | 来自 O 奖论文 2419984 的可运行复现/expected_result |
| Agent:Qwen3.8 27B | 随机仿真/贝叶斯搜索 + 综合评价/路径规划 | 5 万粒子 Monte Carlo 位置后验 + 海流漂移/扩散不确定性 + 搜索区域规划。 | numpy | 本题 O-Eval 75.32%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.371417 = 0.628583。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.371417 | 37.14% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.403101 | 40.31% | +3.17 pp | 5.04% |
| Kimi K3 | 0.470888 | 47.09% | +9.95 pp | 15.82% |
| Qwen3.8 27B | 0.753209 | 75.32% | +38.18 pp | 60.74% |
| DeepSeek Flash (opencode) | 0.212392 | 21.24% | -15.90 pp | -25.30% |
| Hy4 Preview | 0.300348 | 30.03% | -7.11 pp | -11.31% |
| GPT-5.6 Sol | 0.389026 | 38.90% | +1.76 pp | 2.80% |
| v4 pro | 0.296505 | 29.65% | -7.49 pp | -11.92% |
| GPT-5.6 Sol XH | 0.662162 | 66.22% | +29.07 pp | 46.25% |
| GLM-5.3 | 0.709302 | 70.93% | +33.79 pp | 53.75% |
| ox-alpha | 0.632353 | 63.24% | +26.09 pp | 41.51% |
| Gemini 3.7 Flash | 0.187946 | 18.79% | -18.35 pp | -29.19% |
| Qwen3.8 Flash (Bailian) | 0.272873 | 27.29% | -9.85 pp | -15.68% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.caribbean_adaptation.current_multiplier` | 越接近越好 | 1.35 / 分 1 | 1.5 / 分 0.5192 | 1.7 / 分 0.3164 | 2 / 分 0.1995 | 1.4 / 分 0.7642 | 2.2 / 分 0.1601 | 1.6 / 分 0.3932 | 1.75 / 分 0.2883 | 1.9 / 分 0.2275 | 1.35 / 分 1 | 1.35 / 分 1 | 1.35 / 分 1 | 2.15 / 分 0.1684 | 1.6 / 分 0.3932 |
| `experiment_result.caribbean_adaptation.terrain_uncertainty_multiplier` | 越接近越好 | 1.2 / 分 1 | 1.7 / 分 0.2236 | 1.35 / 分 0.4898 | 1.25 / 分 0.7423 | 1.25 / 分 0.7423 | 1.6 / 分 0.2647 | 1.75 / 分 0.2075 | 1.35 / 分 0.4898 | 1.45 / 分 0.3655 | 1.5 / 分 0.3243 | 1.4 / 分 0.4186 | 1.6 / 分 0.2647 | 1.75 / 分 0.2075 | 2 / 分 0.1525 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2024 C: 网球势头预警
任务 slug:`mcm-2024-c-tennis-momentum`
**这题在问什么:**把势头模型转成教练能用的赛中提示:什么时候可能发生势头转换,应重点监控哪些指标。
**BO/O 答案是什么:**O 奖复现的最终比赛预警率为 0.006;前三个势头预警特征相关系数约为 0.0302、-0.0223、0.0154。
**baseline 解法大概是什么:**baseline 用势头时间序列、随机性检验和贝叶斯/分类预警模型,把比赛数据转成教练提示。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 数据建模/时间序列 + 统计检验/分类预警 | 发球校正 EWMA 势头指标 + 游程/Ljung-Box 随机性检验 + Markov 链 + 预警分类。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用势头时间序列、随机性检验和贝叶斯/分类预警模型,把比赛数据转成教练提示。 |
| O:O 奖复现 | 数据建模/时间序列 + 统计检验/分类预警 | 发球校正残差 + 双时间 EWMA 势头指标 + Ljung-Box/游程检验 + Bayesian 转移预警。 | matplotlib、numpy、pandas、scipy | 来自 O 奖论文 2401298 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 数据建模/时间序列 + 统计检验/分类预警 | 发球和破发点基准胜率 + EWMA 残差势头 + Ljung-Box/游程检验 + 转折预警。 | matplotlib、numpy、pandas、scipy、scikit-learn、statsmodels | 本题 O-Eval 85.63%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.306291 = 0.693709。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.306291 | 30.63% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.856263 | 85.63% | +55.00 pp | 79.28% |
| Kimi K3 | 0.377542 | 37.75% | +7.13 pp | 10.27% |
| Qwen3.8 27B | 0.523386 | 52.34% | +21.71 pp | 31.29% |
| DeepSeek Flash (opencode) | 0.385581 | 38.56% | +7.93 pp | 11.43% |
| Hy4 Preview | 0.778964 | 77.90% | +47.27 pp | 68.14% |
| GPT-5.6 Sol | 0.403266 | 40.33% | +9.70 pp | 13.98% |
| v4 pro | 0.564619 | 56.46% | +25.83 pp | 37.24% |
| GPT-5.6 Sol XH | 0.713777 | 71.38% | +40.75 pp | 58.74% |
| GLM-5.3 | 0.361433 | 36.14% | +5.51 pp | 7.95% |
| ox-alpha | 0.773319 | 77.33% | +46.70 pp | 67.32% |
| Gemini 3.7 Flash | 0 | 0.00% | -30.63 pp | -100.00% |
| Qwen3.8 Flash (Bailian) | 0.464638 | 46.46% | +15.83 pp | 22.83% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.dual_temporal_bayes.final_match_warning_rate` | 越接近越好 | 0.006 / 分 1 | 0.333333 / 分 0.2683 | 0.0273556 / 分 0.8489 | 0.4844 / 分 0.2005 | 0.212766 / 分 0.3672 | 0.8 / 分 0.1313 | 0.0988 / 分 0.5639 | 0.5 / 分 0.1954 | 0.253049 / 分 0.3269 | 0.166667 / 分 0.4276 | 0.303797 / 分 0.2872 | 0.011976 / 分 0.9526 | 无 artifact | 0.06587 / 分 0.6671 |
| `experiment_result.top_swing_features[0].warning_correlation` | 越接近越好 | 0.0302 / 分 1 | -0.412335 / 分 0.2133 | -0.0288096 / 分 0.6704 | 0.1819 / 分 0.4417 | 0.289185 / 分 0.3166 | 0.218 / 分 0.3899 | 0.0415 / 分 0.9139 | 0.25068 / 分 0.3524 | -0.0651453 / 分 0.5572 | -0.0256758 / 分 0.6823 | -0.226975 / 分 0.3182 | 0.0882577 / 分 0.6739 | 无 artifact | -0.1901 / 分 0.3526 |
| `experiment_result.top_swing_features[1].warning_correlation` | 越接近越好 | -0.0223 / 分 1 | -0.242174 / 分 0.3531 | -0.0274409 / 分 0.9589 | 0.1637 / 分 0.3922 | -0.0676086 / 分 0.7259 | -0.1332 / 分 0.5197 | -0.0351 / 分 0.9036 | 0.185976 / 分 0.3655 | -0.0605063 / 分 0.7585 | -0.0235936 / 分 0.9893 | -0.21091 / 分 0.3888 | 0.0751836 / 分 0.5518 | 无 artifact | 0.1483 / 分 0.4129 |
| `experiment_result.top_swing_features[2].warning_correlation` | 越接近越好 | 0.0154 / 分 1 | -0.171886 / 分 0.3905 | 0.0221353 / 分 0.9469 | 0.1476 / 分 0.4758 | -0.040101 / 分 0.6838 | -0.1039 / 分 0.5015 | -0.028 / 分 0.7344 | 0.066918 / 分 0.6996 | -0.0594703 / 分 0.6158 | -0.023347 / 分 0.7559 | -0.130371 / 分 0.4515 | 0.0265459 / 分 0.915 | 无 artifact | -0.1464 / 分 0.4258 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2025 A: 楼梯磨损反推人流
任务 slug:`mcm-2025-a-stair-wear`
**这题在问什么:**根据楼梯磨损反推典型一天大约多少人使用,以及这些人是短时间集中经过还是长时间稀疏经过。
**BO/O 答案是什么:**O 奖复现估计日均使用人数 73.52,短时峰值约 27.6 人,若分散到 10 小时则每小时约 4.6 人。
**baseline 解法大概是什么:**baseline 用物理磨损反演,把磨损深度、材料假设和年龄区间换算成通行次数与典型日使用模式。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 解析几何/物理反演 + 数据估计 | 磨损体积反演交通量模型。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用物理磨损反演,把磨损深度、材料假设和年龄区间换算成通行次数与典型日使用模式。 |
| O:O 奖复现 | 解析几何/物理反演 + 数据估计 | 磨损体积模型(WVM)+ 磨损分布模型(WDM)。 | matplotlib、numpy、pandas | 来自 O 奖论文 2501909 的可运行复现/expected_result |
| Agent:Qwen3.8 27B | 解析几何/物理反演 + 数据估计 | WVM/WDM 反演楼梯交通量:由踏面磨损形态推日均和峰值人流。 | matplotlib、numpy、openpyxl、pandas | 本题 O-Eval 23.33%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0 = 1。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0 | 0.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0 | 0.00% | +0.00 pp | 0.00% |
| Kimi K3 | 0 | 0.00% | +0.00 pp | 0.00% |
| Qwen3.8 27B | 0.233333 | 23.33% | +23.33 pp | 23.33% |
| DeepSeek Flash (opencode) | 0 | 0.00% | +0.00 pp | 0.00% |
| Hy4 Preview | 0 | 0.00% | +0.00 pp | 0.00% |
| GPT-5.6 Sol | 0 | 0.00% | +0.00 pp | 0.00% |
| v4 pro | 0 | 0.00% | +0.00 pp | 0.00% |
| GPT-5.6 Sol XH | 0 | 0.00% | +0.00 pp | 0.00% |
| GLM-5.3 | 0 | 0.00% | +0.00 pp | 0.00% |
| ox-alpha | 0 | 0.00% | +0.00 pp | 0.00% |
| Gemini 3.7 Flash | 0 | 0.00% | +0.00 pp | 0.00% |
| Qwen3.8 Flash (Bailian) | 0 | 0.00% | +0.00 pp | 0.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `daily_use_pattern.peak_period_users` | 越接近越好 | 27.6 / 分 1 | 54 / 分 0 | 70.0271 / 分 0 | 21.1 / 分 0 | 15.98 / 分 0 | 55.84 / 分 0 | 69.3 / 分 0 | 7.305 / 分 0 | 28.72 / 分 0 | 72.1415 / 分 0 | 1.82 / 分 0 | 7 / 分 0 | 90.8 / 分 0 | 7.6 / 分 0 |
| `daily_use_pattern.regular_hour_users_if_spread_over_10_hours` | 越接近越好 | 4.6 / 分 1 | 7.8 / 分 0 | 3.77069 / 分 0 | 6 / 分 0 | 4.57 / 分 0.7 | 12.41 / 分 0 | 19.8 / 分 0 | 1.178 / 分 0 | 4.42 / 分 0 | 11.0987 / 分 0 | 0.48 / 分 0 | 2 / 分 0 | 13.97 / 分 0 | 14.4 / 分 0 |
| `experiment_result.estimated_daily_users` | 越接近越好 | 73.52 / 分 1 | 78.2 / 分 0 | 107.734 / 分 0 | 60.2 / 分 0 | 45.66 / 分 0 | 124.08 / 分 0 | 197.9 / 分 0 | 11.783 / 分 0 | 44.18 / 分 0 | 110.9869 / 分 0 | 4.8 / 分 0 | 20 / 分 0 | 139.74 / 分 0 | 152 / 分 0 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2025 B: 朱诺旅游可持续政策
任务 slug:`mcm-2025-b-juneau-tourism`
**这题在问什么:**给朱诺旅游委员会写一页备忘录,概括预测、各种限制/收费措施的效果,并推荐最优可持续旅游政策。
**BO/O 答案是什么:**O 奖复现推荐终端政策:日容量 11000 人,游客费 55 USD,年游客 1491526,总收入 431610327.83 USD,居民接受度 1.0,可持续得分 1.007。
**baseline 解法大概是什么:**baseline 用可持续旅游政策优化,把游客量、收费、保护投入、居民接受度和冰川压力一起做动态规划。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 系统动力学 + 动态规划/多目标优化 | 系统动力学反馈模型 + 有限期动态规划优化。 | 未显式记录;可能只用 Python 标准库或未在轨迹中留下安装/import 线索 | 实际 baseline agent artifact;题目基准描述:baseline 用可持续旅游政策优化,把游客量、收费、保护投入、居民接受度和冰川压力一起做动态规划。 |
| O:O 奖复现 | 系统动力学 + 动态规划/多目标优化 | 游客需求、经济收益、环境压力、社会接受度耦合的动态规划。 | matplotlib、numpy、pandas | 来自 O 奖论文 2504448 的可运行复现/expected_result |
| Agent:Kimi K3 | 系统动力学 + 动态规划/多目标优化 | 游客需求-冰川健康-居民接受度耦合系统动力学 + 有限期动态规划。 | matplotlib、numpy、pandas、scipy | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题进入 Robust 比例口径。分母是 O raw - flash raw = 1 - 0.259364 = 0.740636。Robust 辅助指标用 (模型 raw - flash raw) / 这个分母,但最终截到 ±100%,所以超大离群值不会继续放大。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 0.259364 | 25.94% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 0.0900957 | 9.01% | -16.93 pp | -22.85% |
| Kimi K3 | 1.46014 | 100.00% | +120.08 pp | 100.00% |
| Qwen3.8 27B | 0.0252273 | 2.52% | -23.41 pp | -31.61% |
| DeepSeek Flash (opencode) | 0.171015 | 17.10% | -8.83 pp | -11.93% |
| Hy4 Preview | 0.567213 | 56.72% | +30.78 pp | 41.57% |
| GPT-5.6 Sol | 0.372904 | 37.29% | +11.35 pp | 15.33% |
| v4 pro | 0.426076 | 42.61% | +16.67 pp | 22.51% |
| GPT-5.6 Sol XH | 0.251056 | 25.11% | -0.83 pp | -1.12% |
| GLM-5.3 | 0.337214 | 33.72% | +7.78 pp | 10.51% |
| ox-alpha | 0 | 0.00% | -25.94 pp | -35.02% |
| Gemini 3.7 Flash | 0.702044 | 70.20% | +44.27 pp | 59.77% |
| Qwen3.8 Flash (Bailian) | 0.907133 | 90.71% | +64.78 pp | 87.46% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `experiment_result.annual_visitors` | 越高越好 | 1,491,526 / 分 1 | 1,504,148 / 分 1.14073 | 1,453,152 / 分 0.5406 | 1,176,317 / 分 0 | 1,200,000 / 分 0 | 1,433,729 / 分 0.308 | 1,600,000 / 分 1.83234 | 1,600,000 / 分 1.83234 | 1,600,000 / 分 1.83234 | 1,450,292 / 分 0.5063 | 1,575,000 / 分 1.69284 | 1,185,309 / 分 0 | 1,740,224 / 分 2.38065 | 2,258,158 / 分 3.32026 |
| `experiment_result.optimal_daily_cap` | 越接近越好 | 11,000 / 分 1 | 12,000 / 分 0 | 20,000 / 分 0 | 8,000 / 分 0 | 15,000 / 分 0 | 16,000 / 分 0 | 20,000 / 分 0 | 20,000 / 分 0 | 16,000 / 分 0 | 20,000 / 分 0 | 15,000 / 分 0 | 15,000 / 分 0 | 16,500 / 分 0 | 12,000 / 分 0 |
| `experiment_result.optimal_visitor_fee_usd` | 越接近越好 | 55 / 分 1 | 30 / 分 0 | 20 / 分 0 | 20 / 分 0 | 50 / 分 0 | 30 / 分 0 | 20 / 分 0 | 20 / 分 0 | 30 / 分 0 | 20 / 分 0 | 35 / 分 0 | 60 / 分 0 | 15 / 分 0 | 30 / 分 0 |
| `experiment_result.resident_acceptance_index` | 越高越好 | 1 / 分 1 | 87.14→0.8714 / 分 0.4155 | 0.742865 / 分 0 | 1.5 / 分 0
无效: invalid_unit_interval_out_of_range | 81.33→0.8133 / 分 0.1514 | 0.937972 / 分 0.7181 | 0.6496 / 分 0 | 0.61511 / 分 0 | 75.8→0.758 / 分 0 | 1 / 分 1 | 0.667084 / 分 0 | 0.636608 / 分 0 | 1 / 分 1 | 0.6817 / 分 0 |
| `experiment_result.sustainability_score` | 越高越好 | 1.007 / 分 1 | 79.3886→0.793886 / 分 0 | 0.899694 / 分 0 | 232.2 / 分 8.76084
需复核: review_extreme_actual_oracle_ratio | 86.51→0.8651 / 分 0 | 0.705995 / 分 0 | 95.8906→0.958906 / 分 0.512 | 69.7742→0.697742 / 分 0 | 68.5976→0.685976 / 分 0 | 0.833326 / 分 0 | 78.5144→0.785144 / 分 0 | 70.0293→0.700293 / 分 0 | 74.76→0.7476 / 分 0 | 43.223→0.43223 / 分 0 |
| `experiment_result.total_revenue_usd` | 越高越好 | 431,610,327.83 / 分 1 | 397,696,731.2 / 分 0 | 369,645,540 / 分 0 | 299,225,756 / 分 0 | 341,250,000 / 分 0 | 366,651,514.42 / 分 0 | 433,505,235.6 / 分 1.05894 | 413,042,845.93 / 分 0.4051 | 423,000,000 / 分 0.7241 | 345,937,862.94 / 分 0 | 410,713,333.84 / 分 0.3304 | 348,925,381.94 / 分 0 | 426,354,880 / 分 0.8316 | 496,297,968.11 / 分 2.12254 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
### MCM 2025 C: 奥运奖牌与强教练效应
任务 slug:`mcm-2025-c-olympic-medals`
**这题在问什么:**说明模型还能发现哪些原创奖牌规律,以及这些规律怎样指导国家奥委会分配项目和教练资源。
**BO/O 答案是什么:**O 奖复现的教练效应建议中,四个候选投资的预计奖牌增益为 1.666667、2.0、3.0、1.777778,全局强教练效应 75 分位跳升为 6.0。
**baseline 解法大概是什么:**baseline 用奥运奖牌预测、项目重要性分析和滚动三届历史成绩跳升来筛选可能的强教练效应。
**B / O / Agent 用的题型大类、数学模型和库:**
| 角色 | 题型大类 | 中文数学模型 | 主要库/求解器 | 备注 |
|---|---|---|---|---|
| B:v4 flash baseline | 数据建模/机器学习 + Monte Carlo 仿真 | 历史加权平均 + 主办国效应 + Monte Carlo 奖牌仿真。 | matplotlib、numpy、pandas、scipy、scikit-learn | 实际 baseline agent artifact;题目基准描述:baseline 用奥运奖牌预测、项目重要性分析和滚动三届历史成绩跳升来筛选可能的强教练效应。 |
| O:O 奖复现 | 数据建模/机器学习 + Monte Carlo 仿真 | 运动员能力特征工程 + 随机森林 + Monte Carlo 奖牌分配 + Poisson 项目弹性。 | matplotlib、numpy、pandas、scikit-learn | 来自 O 奖论文 2505964 的可运行复现/expected_result |
| Agent:GPT-5.5 xhigh (codex) | 数据建模/机器学习 + Monte Carlo 仿真 | 按项目训练随机森林二分类器预测金牌/奖牌 + Monte Carlo 2028 奖牌表投影。 | numpy、pandas、scipy、scikit-learn | 本题 O-Eval 100.00%,这里取非 baseline 中本题最高者 |
**这题怎么换成 O-Eval / Robust:**O-Eval 直接用 `clamp(模型 raw / O raw, 0, 1)`;这题鲁棒辅助口径失效:flash raw=1.57531,O raw=1,flash 已经达到或超过 O,分母不为正。Robust 辅助指标改用 clipped B-Eval:把 gain = 模型 raw - flash raw 截到 ±10pp 再进平均。
**本题 raw、O-Eval、B-Eval vs flash 和 Robust 辅助指标:**
| 模型 | 本题 raw | O-Eval 主分 | B-Eval vs flash | Robust BO-Eval 辅助 |
|---|---:|---:|---:|---:|
| O 奖复现答案 | 1 | 100.00% | N/A | N/A |
| v4 flash baseline | 1.57531 | 100.00% | +0.00 pp | 0.00% |
| GPT-5.5 xhigh (codex) | 1.33936 | 100.00% | -23.59 pp | -10.00% |
| Kimi K3 | 2.9955 | 100.00% | +142.02 pp | 10.00% |
| Qwen3.8 27B | 0.138589 | 13.86% | -143.67 pp | -10.00% |
| DeepSeek Flash (opencode) | 0.774277 | 77.43% | -80.10 pp | -10.00% |
| Hy4 Preview | 0.44561 | 44.56% | -112.97 pp | -10.00% |
| GPT-5.6 Sol | 0.457106 | 45.71% | -111.82 pp | -10.00% |
| v4 pro | 0.838169 | 83.82% | -73.71 pp | -10.00% |
| GPT-5.6 Sol XH | 2.10169 | 100.00% | +52.64 pp | 10.00% |
| GLM-5.3 | 0.870336 | 87.03% | -70.50 pp | -10.00% |
| ox-alpha | 0.186115 | 18.61% | -138.92 pp | -10.00% |
| Gemini 3.7 Flash | 0 | 0.00% | -157.53 pp | -100.00% |
| Qwen3.8 Flash (Bailian) | 0.920868 | 92.09% | -65.44 pp | -10.00% |
**评测问题和模型答案:**下面表里的“/ 分”是单指标 reward,不是整题分。`a→b` 表示评测器做了单位换算或百分比归一化后用 `b` 计分。
| 评测指标 | 方向 | BO/O 答案 | v4 flash | GPT-5.5 xhigh (codex) | Kimi K3 | Qwen3.8 27B | DeepSeek Flash (opencode) | Hy4 Preview | GPT-5.6 Sol | v4 pro | GPT-5.6 Sol XH | GLM-5.3 | ox-alpha | Gemini 3.7 Flash | Qwen3.8 Flash (Bailian) |
|---|---|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| `great_coach_model.global_top_jump_75pct` | 越高越好 | 6 / 分 1 | 3 / 分 0.1935 | 2.5 / 分 0.1706 | 10 / 分 2.88031 | 2 / 分 0.1525 | 3 / 分 0.1935 | 3 / 分 0.1935 | 3.333 / 分 0.2126 | 0 / 分 0.1071 | 3.66667 / 分 0.2358 | 3.6667 / 分 0.2358 | 1.66667 / 分 0.1425 | 无 artifact | 9.33 / 分 2.72722 |
| `great_coach_model.recommendations[0].estimated_medal_count_gain` | 越高越好 | 1.66667 / 分 1 | 3 / 分 3.03688 | 2.5 / 分 2.64223 | 4 / 分 3.53897 | 0.429 / 分 0.1391 | 2.33 / 分 2.46248 | 1.667 / 分 1.00166 | 1.667 / 分 1.00166 | 2 / 分 1.98083 | 3.5 / 分 3.31911 | 2 / 分 1.98083 | 0.666667 / 分 0.1667 | 无 artifact | 1.44 / 分 0.4687 |
| `great_coach_model.recommendations[1].estimated_medal_count_gain` | 越高越好 | 2 / 分 1 | 3 / 分 2.64223 | 2.5 / 分 2.12601 | 4 / 分 3.23359 | 0.491 / 分 0.1372 | 1.33 / 分 0.2637 | 1.667 / 分 0.4188 | 1.667 / 分 0.4188 | 2 / 分 1 | 3.5 / 分 2.981 | 2 / 分 1 | 1.2 / 分 0.2308 | 无 artifact | 1.44 / 分 0.3 |
| `great_coach_model.recommendations[2].estimated_medal_count_gain` | 越高越好 | 3 / 分 1 | 2.52 / 分 0.4286 | 2.5 / 分 0.4186 | 4 / 分 2.32914 | 0.491 / 分 0.1255 | 1.33 / 分 0.1773 | 1.222 / 分 0.1684 | 1.517 / 分 0.1953 | 2 / 分 0.2647 | 3.5 / 分 1.87083 | 2 / 分 0.2647 | 1.6 / 分 0.2045 | 无 artifact | 1.44 / 分 0.1875 |
**一句话带走:**这题真正看的不是模型有没有写出漂亮过程,而是最后几个关键数值能不能落在正确方向上。
## 为什么排名会长这样
O-Eval 第一的是 GPT-5.5 xhigh (codex),主分是 64.29%。这说明它在 18 题平均 raw 上最接近 O 奖复现锚点,不是靠某一道小分母题爆表冲上去。
Robust 辅助第一的是 Kimi K3,辅助分是 21.27%。这个口径说明它在 flash 弱项上追回 gap 的能力强,但它不再是唯一主表,因为它仍然依赖 flash 和 O 之间那段尺子的形状。
温和版 hard-gated 第一的是 GPT-5.5 xhigh (codex),主分是 64.29%。这张榜不是新的数学分数,而是给公开解读加了一道保守阀门:明显不可行的高分不再继续抬平均数。
GLM-5.3 和 v4 pro 的位置很接近,说明它们在 flash 弱项上整体有稳定增益;GPT-5.6 Sol high、Kimi K3、Qwen3.8 27B 都有强题,但 O-Eval 会把强题、弱题、缺失题放到同一张绝对成绩单里平均。
Gemini 3.7 Flash 只有 15/18 个 artifact,所以缺失题按 raw 0 进入统计;这会直接压低它的 O-Eval 主分。
所以这套结果要分三眼看:O-Eval 是最终主排名,Robust BO-Eval 是相对 flash 的辅助口径,score-cost 图再加一眼:同样的分,到底花了多少钱。