
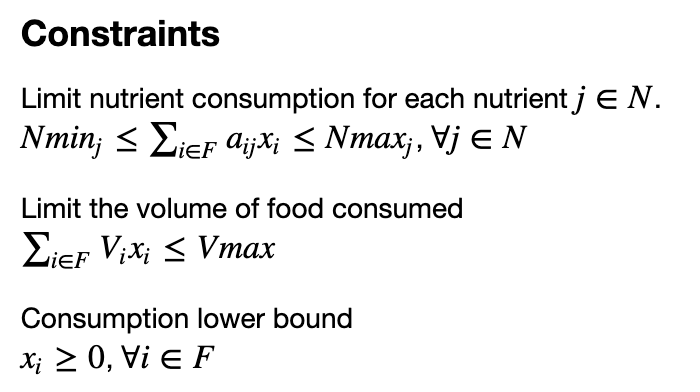
上一篇我们使用pyomo对(啤酒混合策略、燃料设计策略、饮食营养策略)进行了建模求解,这一篇我们自己动手,把这三个问题改写为用遗传算法geatpy进行求解。其中饮食营养策略涉及比较复杂的数据结构,需要动手实践下才能好好理解geatpy的使用语法。
特别指出的是,python里的高级数据类型:字典{},可以很方便地辅助我们进行多变量规划问题的建模,life is short , i use python。
一、实践1:啤酒混合策略(Jenchura, 2017)
方法1:常规写法
定义模型:
# -*- coding: utf-8 -*-
"""MyProblem.py"""
import numpy as np
import geatpy as ea
class MyProblem(ea.Problem): # 继承Problem父类
 def __init__(self):
        name = 'MyProblem' # 初始化name(函数名称,可以随意设置)
        M = 1 # 初始化M(目标维数)
        maxormins = [1] # 初始化maxormins(目标最小最大化标记列表,1:最小化该目标;-1:最大化该目标)
        Dim = 3 # 初始化Dim(决策变量维数),这里就是啤酒混合中的三种原料
        varTypes = [0] * Dim # 初始化varTypes(决策变量的类型,元素为0表示对应的变量是连续的;1表示是离散的)
        lb = [0,0,0] # 决策变量下界
        ub = [100,100,100] # 决策变量上界,由于这个问题并没有规定上界,因此我们可以自己给一个很大的值,比如100或者10000
        lbin = [1,1,1] # 决策变量下边界(0表示不包含该变量的下边界,1表示包含)
        ubin = [1,1,1] # 决策变量上边界(0表示不包含该变量的上边界,1表示包含)
 # 调用父类构造方法完成实例化
        ea.Problem.__init__(self, name, M, maxormins, Dim, varTypes, lb, ub, lbin, ubin)
 def aimFunc(self, pop): # 目标函数
        Vars = pop.Phen # 得到决策变量矩阵
        x1 = Vars[:, [0]]
        x2 = Vars[:, [1]]
        x3 = Vars[:, [2]]
        pop.ObjV = 0.32*x1 + 0.25*x2 + 0.05*x3 # 计算目标函数值,赋值给pop种群对象的ObjV属性,这里就是啤酒混合的总cost
 # 采用可行性法则处理约束
        pop.CV = np.hstack([
                        -x1 - x2 - x3 + 100, #体积约束,即x1+x2+x3>=100
 -0.005*x1 + 0.003*x2 + 0.04*x3 # 组成成分约束,即0.005*x1 - 0.003*x2 - 0.04*x3 >= 0.04
                        ])
模型求解:
if __name__ == '__main__':
 """================================实例化问题对象==========================="""
    problem = MyProblem() # 生成问题对象
 """==================================种群设置==============================="""
    Encoding = 'RI' # 编码方式
    NIND = 100 # 种群规模
    Field = ea.crtfld(Encoding, problem.varTypes, problem.ranges, problem.borders) # 创建区域描述器
    population = ea.Population(Encoding, Field, NIND) # 实例化种群对象(此时种群还没被初始化,仅仅是完成种群对象的实例化)
 """================================算法参数设置============================="""
    myAlgorithm = ea.soea_DE_rand_1_L_templet(problem, population) # 实例化一个算法模板对象
    myAlgorithm.MAXGEN = 500 # 最大进化代数
    myAlgorithm.mutOper.F = 0.5 # 差分进化中的参数F
    myAlgorithm.recOper.XOVR = 0.7 # 重组概率
 """===========================调用算法模板进行种群进化======================="""
    [population, obj_trace, var_trace] = myAlgorithm.run() # 执行算法模板
    population.save() # 把最后一代种群的信息保存到文件中
 # 输出结果
    best_gen = np.argmin(problem.maxormins * obj_trace[:, 1]) # 记录最优种群个体是在哪一代
    best_ObjV = obj_trace[best_gen, 1]
    print('最优的目标函数值为:%s'%(best_ObjV))
    print('最优的决策变量值为:')
 for i in range(var_trace.shape[1]):
        print(var_trace[best_gen, i])
    print('有效进化代数:%s'%(obj_trace.shape[0]))
    print('最优的一代是第 %s 代'%(best_gen + 1))
    print('评价次数:%s'%(myAlgorithm.evalsNum))
    print('时间已过 %s 秒'%(myAlgorithm.passTime))
模型结果:
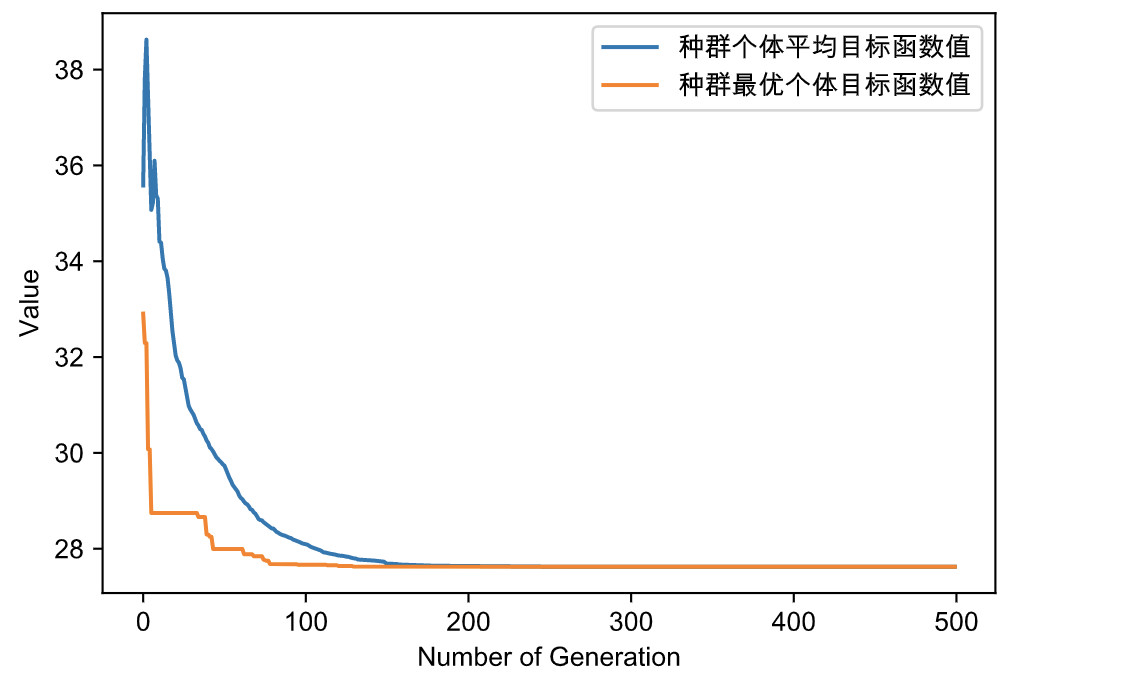
种群信息导出完毕。
最优的目标函数值为:27.62500000320636
最优的决策变量值为:
37.500000042895515
62.49999995791917
0.0
有效进化代数:500
最优的一代是第 433 代
评价次数:50000
时间已过 0.5115456581115723 秒
方法2:使用字典
我们跟上一篇的pyomo多变量问题实践使用python字典,这样可以更方便地书写geatpy代码,更多变量的时候也更加易扩展,代码如下:
定义模型:
data = {
 'A': {'abv': 0.045, 'cost': 0.32},
 'B': {'abv': 0.037, 'cost': 0.25},
 'W': {'abv': 0.000, 'cost': 0.05},
}


vol = 100
abv = 0.040


C = data.keys()
# -*- coding: utf-8 -*-
"""MyProblem.py"""
import numpy as np
import geatpy as ea
class MyProblem(ea.Problem): # 继承Problem父类
def __init__(self):
name = 'MyProblem' # 初始化name(函数名称,可以随意设置)
M = 1 # 初始化M(目标维数)
maxormins = [1] # 初始化maxormins(目标最小最大化标记列表,1:最小化该目标;-1:最大化该目标)
Dim = 3 # 初始化Dim(决策变量维数)
varTypes = [0] * Dim # 初始化varTypes(决策变量的类型,元素为0表示对应的变量是连续的;1表示是离散的)
lb = [0,0,0] # 决策变量下界
ub = [100,100,100] # 决策变量上界,由于这个问题并没有规定上界,因此我们可以自己给一个很大的值,比如100或者10000
lbin = [1,1,1] # 决策变量下边界(0表示不包含该变量的下边界,1表示包含),或者写作【1】*3
ubin = [1,1,1] # 决策变量上边界(0表示不包含该变量的上边界,1表示包含)
# 调用父类构造方法完成实例化
ea.Problem.__init__(self, name, M, maxormins, Dim, varTypes, lb, ub, lbin, ubin)
def aimFunc(self, pop): # 目标函数
Vars = pop.Phen # 得到决策变量矩阵
x = {} # 用一个字典存储决策变量
for i,c in zip(range(len(C)),C):
x[c] = Vars[:, [i]] # 怎么用字典得到决策变量矩阵
pop.ObjV = sum(x[c]*data[c]['cost'] for c in C) # 计算目标函数值,赋值给pop种群对象的ObjV属性
# 采用可行性法则处理约束
pop.CV = np.hstack([
- sum(x[c] for c in C) + 100 , #体积约束,即x1+x2+x3>=100
- sum(x[c]*(data[c]['abv'] - abv) for c in C) #组成成分约束,即0.005*x1 - 0.003*x2 - 0.04*x3 >= 0.04
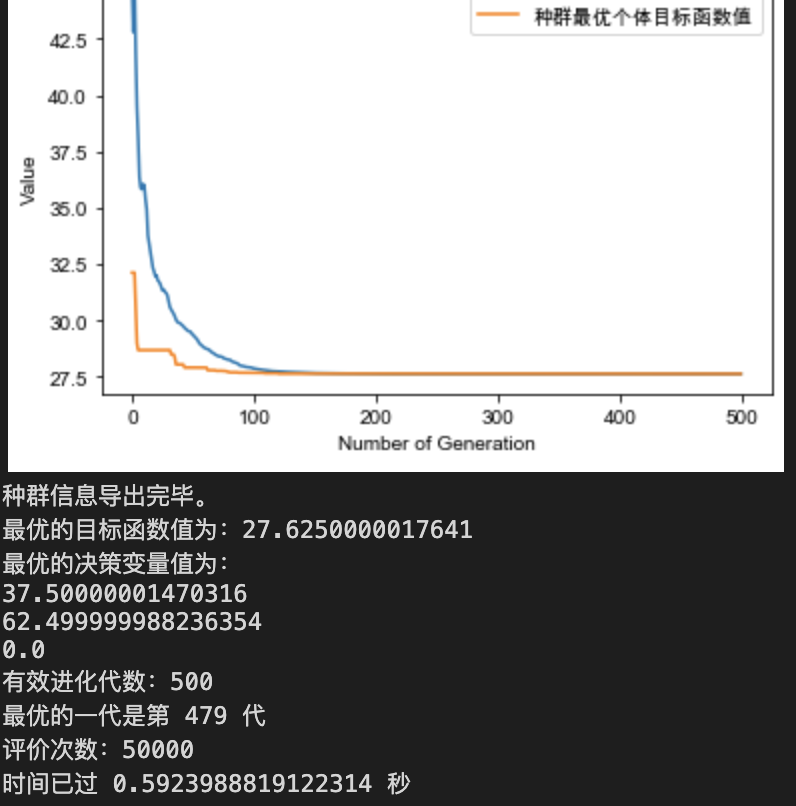
]) 最终得到的结果和普通写法是一样的:
二、实践2:寒冷天气燃料设计问题
data = {
 'ethanol'          : {'MW':  46.07, 'SG': 0.791, 'A': 8.04494, 'B': 1554.3,  'C': 222.65},
 'methanol'         : {'MW':  32.04, 'SG': 0.791, 'A': 7.89750, 'B': 1474.08, 'C': 229.13},
 'isopropyl alcohol': {'MW':  60.10, 'SG': 0.785, 'A': 8.11778, 'B': 1580.92, 'C': 219.61},
 'acetone'          : {'MW':  58.08, 'SG': 0.787, 'A': 7.02447, 'B': 1161.0,  'C': 224.0},
 'xylene'           : {'MW': 106.16, 'SG': 0.870, 'A': 6.99052, 'B': 1453.43, 'C': 215.31},
 'toluene'          : {'MW':  92.14, 'SG': 0.865, 'A': 6.95464, 'B': 1344.8,  'C': 219.48},
}
S = data.keys()
def Pvap(T, s):
return 10**(data[s]['A'] - data[s]['B']/(T + data[s]['C'])) # 单种组成成分s的Antoine蒸汽压
def Pvap_denatured(T):
return 0.4*Pvap(T, 'ethanol') + 0.6*Pvap(T, 'methanol') # 假设变性酒精是乙醇和甲醇的40/60(摩尔分数)的混合物,那么它的蒸汽压是多少
def Pmix(T,x):
return sum(x[s]*Pvap(T,s) for s in S) # 计算多种组成成分的蒸汽压# -*- coding: utf-8 -*-
"""MyProblem.py"""
import numpy as np
import geatpy as ea
class MyProblem(ea.Problem): # 继承Problem父类
def __init__(self):
name = 'MyProblem' # 初始化name(函数名称,可以随意设置)
M = 1 # 初始化M(目标维数)
maxormins = [-1] # 初始化maxormins,本问题是最大化蒸汽压(目标最小最大化标记列表,1:最小化该目标;-1:最大化该目标)
Dim = 6 # 初始化Dim(决策变量维数)
varTypes = [0] * Dim # 初始化varTypes(决策变量的类型,元素为0表示对应的变量是连续的;1表示是离散的)
lb = [0]* Dim # 决策变量下界
ub = [10000] * Dim # 决策变量上界,由于这个问题并没有规定上界,因此我们可以自己给一个很大的值,比如100或者10000
lbin = [1] * Dim # 决策变量下边界(0表示不包含该变量的下边界,1表示包含),或者写作【1】*3
ubin = [1] * Dim # 决策变量上边界(0表示不包含该变量的上边界,1表示包含)
# 调用父类构造方法完成实例化
ea.Problem.__init__(self, name, M, maxormins, Dim, varTypes, lb, ub, lbin, ubin)
def aimFunc(self, pop): # 目标函数
Vars = pop.Phen # 得到决策变量矩阵
x = {} # 用一个字典存储决策变量
for i,s in zip(range(len(S)),S):
x[s] = Vars[:, [i]] # 怎么用字典得到决策变量矩阵
pop.ObjV = Pmix(-10,x) # 计算目标函数值,最大化10摄氏度时的蒸汽压
# 采用可行性法则处理约束
pop.CV = np.hstack([
-sum(x[s] for s in S)+1, # 摩尔分数之和等于1
Pmix(30,x) - Pvap_denatured(30) , #30°C时,混合燃料蒸汽压小于或等于变性酒精蒸汽压
Pmix(40,x) - Pvap_denatured(40) #40°C时,混合燃料蒸汽压小于或等于变性酒精蒸汽压
]) if __name__ == '__main__':
"""================================实例化问题对象==========================="""
problem = MyProblem() # 生成问题对象
"""==================================种群设置==============================="""
Encoding = 'RI' # 编码方式
NIND = 100 # 种群规模
Field = ea.crtfld(Encoding, problem.varTypes, problem.ranges, problem.borders) # 创建区域描述器
population = ea.Population(Encoding, Field, NIND) # 实例化种群对象(此时种群还没被初始化,仅仅是完成种群对象的实例化)
"""================================算法参数设置============================="""
myAlgorithm = ea.soea_DE_rand_1_L_templet(problem, population) # 实例化一个算法模板对象
myAlgorithm.MAXGEN = 500 # 最大进化代数
myAlgorithm.mutOper.F = 0.5 # 差分进化中的参数F
myAlgorithm.recOper.XOVR = 0.7 # 重组概率
"""===========================调用算法模板进行种群进化======================="""
[population, obj_trace, var_trace] = myAlgorithm.run() # 执行算法模板
population.save() # 把最后一代种群的信息保存到文件中
# 输出结果
best_gen = np.argmin(problem.maxormins * obj_trace[:, 1]) # 记录最优种群个体是在哪一代
best_ObjV = obj_trace[best_gen, 1]
print('最优的目标函数值为:%s'%(best_ObjV))
print('最优的决策变量值为:')
for i in range(var_trace.shape[1]):
print(var_trace[best_gen, i])
print('有效进化代数:%s'%(obj_trace.shape[0]))
print('最优的一代是第 %s 代'%(best_gen + 1))
print('评价次数:%s'%(myAlgorithm.evalsNum))
print('时间已过 %s 秒'%(myAlgorithm.passTime))结果:
种群信息导出完毕。
最优的目标函数值为:17.481748736011284
最优的决策变量值为:
0.0
0.0
0.0
0.42816068078343505
0.5718119476118912
3.111782763846932e-05
有效进化代数:500
最优的一代是第 494 代
评价次数:52900
时间已过 0.56656813621521 秒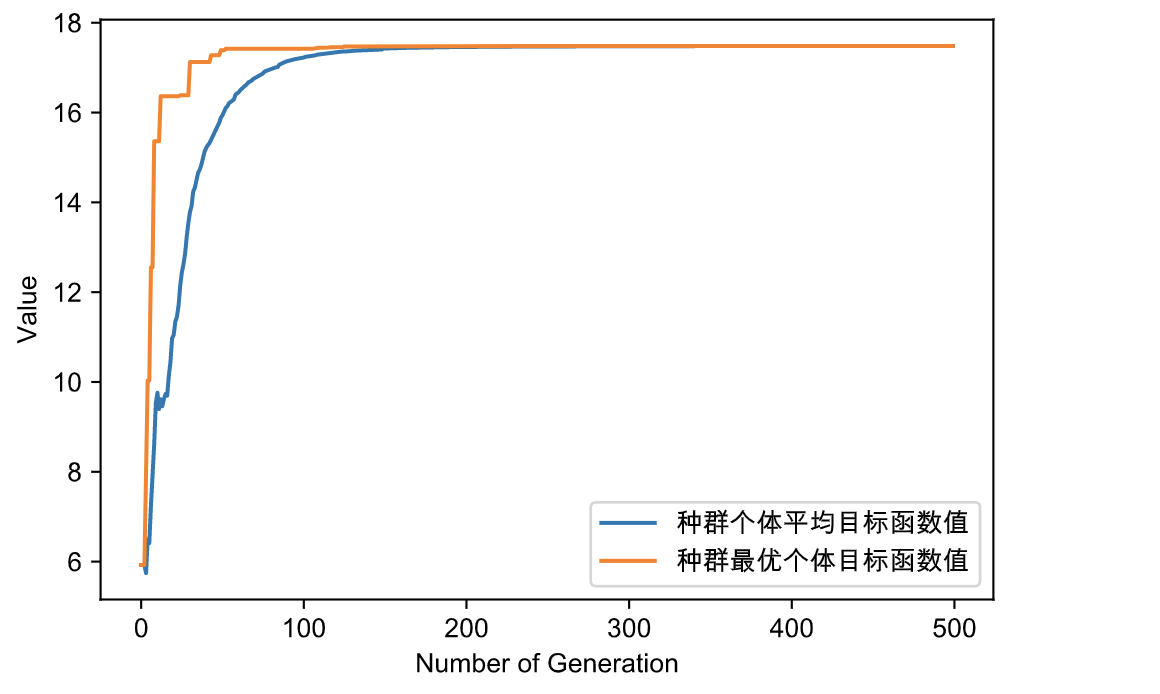
需要注意的是:
np.abs(sum(x[s] for s in S)-1), #当pop.CV中硬性规定摩尔分数之和等于1时,算法结果很差,这是进化算法的一个固有问题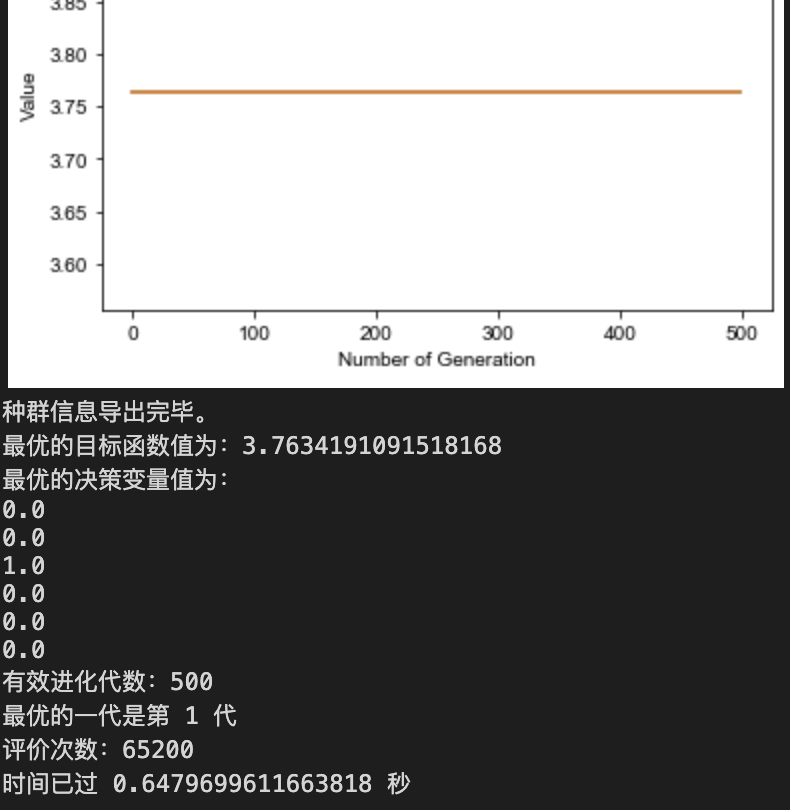
三、实践3:饮食营养问题(Danzig,1990)
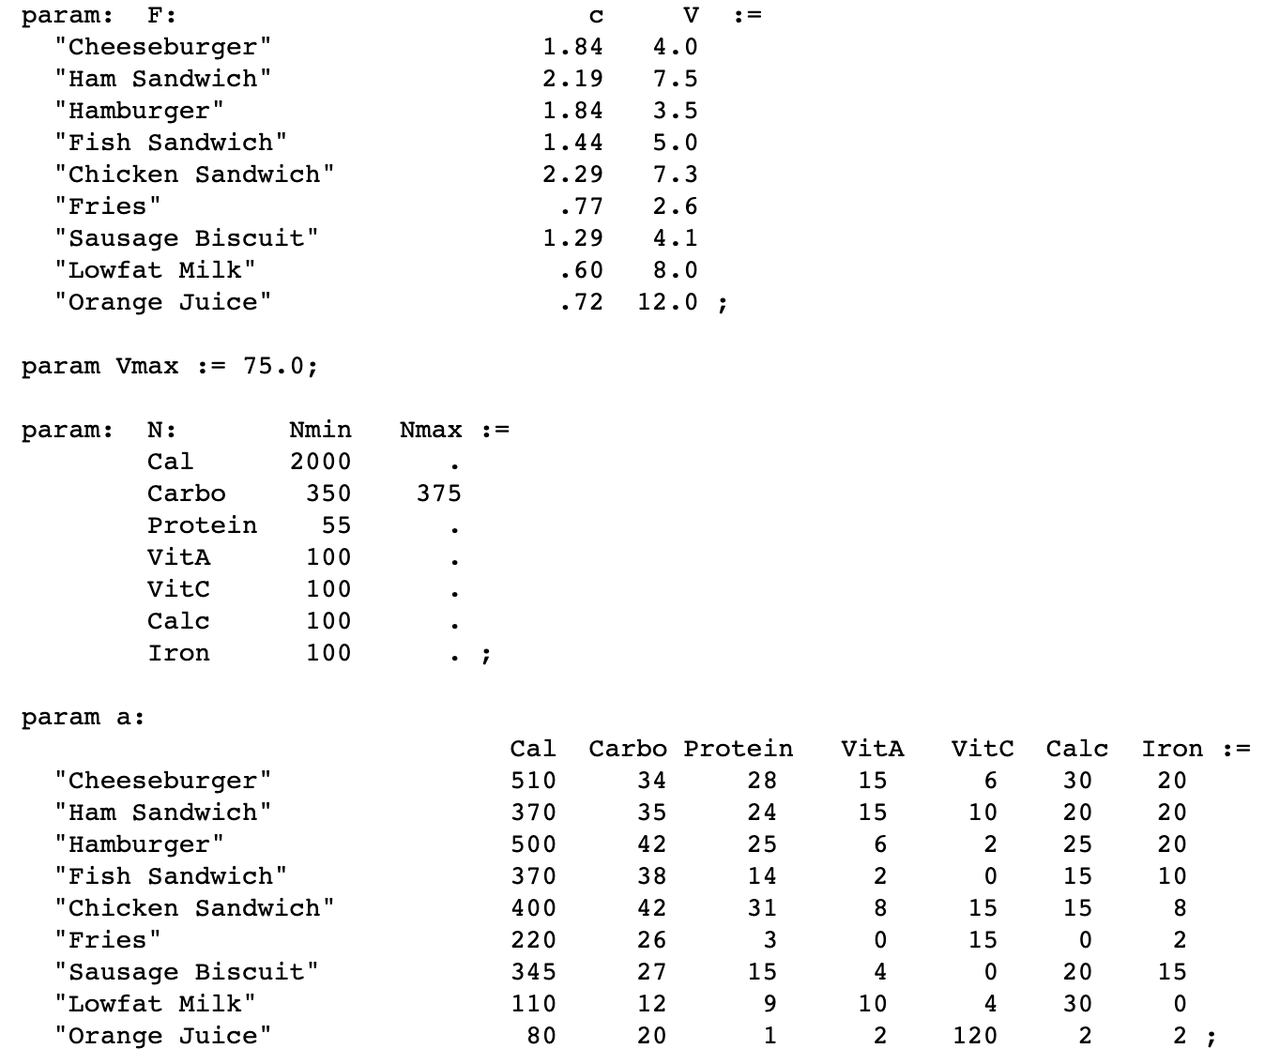
这个问题写起来是比较麻烦的,因为涉及的方面比较多所以写起来也比较麻烦,下图中各个字段具体含义可以回顾上节内容:
1、理解np.hstack()
这个函数是我们进行约束条件pop.CV的时候用到的,因为这次我们的约束条件写起来比较麻烦(约束条件涉及到i,j):
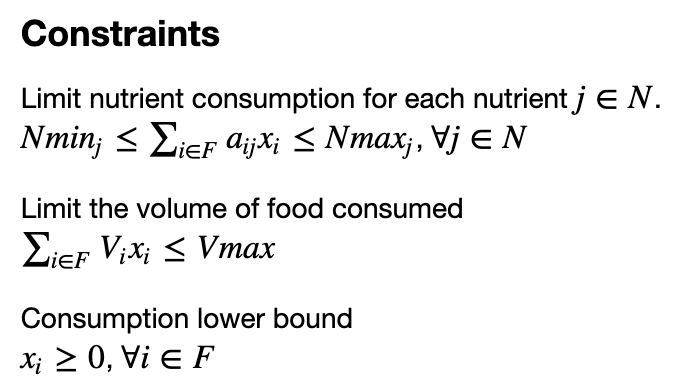
因此我们需要先理解这个函数,它的功能是将两个数组横向合并:
a1=np.array([[1,2],[3,4],[5,6]])
a2=np.array([[7,8],[9,10],[11,12]])
a3= np.hstack([a1,a2])
print(a3)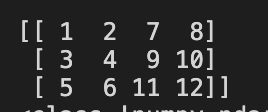
2、数据准备
F = {
"Cheeseburger" :{'c':1.84,'v':4.0},
"Ham Sandwich" : {'c':2.19,'v': 7.5},
"Hamburger":{'c':1.84,'v':3.5},
"Fish Sandwich" : {'c':1.44,'v':5.0},
"Chicken Sandwich":{'c':2.29,'v':7.3},
"Fries" :{'c':0.77,'v': 2.6 },
"Sausage Biscuit":{'c':1.29 , 'v':4.1},
"Lowfat Milk" : {'c':0.60,'v': 8.0},
"Orange Juice":{'c':0.72,'v':12.0}
}


Vmax=75


N = {
'Cal' :{'Nmin':2000, 'Nmax':10000},
'Carbo' :{'Nmin':350, 'Nmax':375},
'Protein' :{'Nmin':55, 'Nmax':10000},
'VitA' :{'Nmin':100, 'Nmax':10000},
'VitC' :{'Nmin':100, 'Nmax':10000},
'Calc' :{'Nmin':100, 'Nmax':10000},
'Iron' :{'Nmin':100, 'Nmax':10000},
}


a = {
"Cheeseburger" : {'Cal':510,'Carbo':34,'Protein':28,'VitA':15,'VitC':6,'Calc':30,'Iron':20},
"Ham Sandwich" : {'Cal':370,'Carbo':35,'Protein':24,'VitA':15,'VitC':10,'Calc':20,'Iron':20} ,
"Hamburger" : {'Cal':500,'Carbo':42,'Protein':25,'VitA':6,'VitC':2,'Calc':25,'Iron':20} ,
"Fish Sandwich" : {'Cal':370,'Carbo':38,'Protein':14,'VitA':2,'VitC':0,'Calc':15,'Iron':10} ,
"Chicken Sandwich" : {'Cal':400,'Carbo':42,'Protein':31,'VitA':8,'VitC':15,'Calc':15,'Iron':8} ,
"Fries" : {'Cal':220,'Carbo':26,'Protein':3,'VitA':0,'VitC':15,'Calc':0,'Iron':2} ,
"Sausage Biscuit" : {'Cal':345,'Carbo':27,'Protein':15,'VitA':4,'VitC':0,'Calc':20,'Iron':15} ,
"Lowfat Milk" : {'Cal':110,'Carbo':12,'Protein':9,'VitA':10,'VitC':4,'Calc':30,'Iron':0} ,
"Orange Juice" : {'Cal':80,'Carbo':20,'Protein':1,'VitA':2,'VitC':120,'Calc':2,'Iron':2} ,
}
# 食物名和营养名的列表
foods = F.keys()
nutrients = N.keys()
print(foods)
print(nutrients)
'''
dict_keys(['Cheeseburger', 'Ham Sandwich', 'Hamburger', 'Fish Sandwich', 'Chicken Sandwich', 'Fries', 'Sausage Biscuit', 'Lowfat Milk', 'Orange Juice'])
dict_keys(['Cal', 'Carbo', 'Protein', 'VitA', 'VitC', 'Calc', 'Iron'])
'''# 通过F获得cost食品价格
cost = {}
for i in foods:
cost[i] = F[i]['c']
print(cost)
# 通过F获得volume食品体积
volume = {}
for i in foods:
volume[i] = F[i]['v']
print(volume)
'''
{'Cheeseburger': 1.84, 'Ham Sandwich': 2.19, 'Hamburger': 1.84, 'Fish Sandwich': 1.44, 'Chicken Sandwich': 2.29, 'Fries': 0.77, 'Sausage Biscuit': 1.29, 'Lowfat Milk': 0.6, 'Orange Juice': 0.72}
{'Cheeseburger': 4.0, 'Ham Sandwich': 7.5, 'Hamburger': 3.5, 'Fish Sandwich': 5.0, 'Chicken Sandwich': 7.3, 'Fries': 2.6, 'Sausage Biscuit': 4.1, 'Lowfat Milk': 8.0, 'Orange Juice': 12.0}
'''# 通过N获得Nmin最低营养要求
Nmin = {}
for i in nutrients:
Nmin[i] = N[i]['Nmin']
print(Nmin)
# 通过N获得Nax最低营养要求
Nmax = {}
for i in nutrients:
Nmax[i] = N[i]['Nmax']
print(Nmax)
'''
{'Cal': 2000, 'Carbo': 350, 'Protein': 55, 'VitA': 100, 'VitC': 100, 'Calc': 100, 'Iron': 100}
{'Cal': 10000, 'Carbo': 375, 'Protein': 10000, 'VitA': 10000, 'VitC': 10000, 'Calc': 10000, 'Iron': 10000}
'''3、模型编程
# 目标函数:Minimize the cost of food that is consumed
def cost_rule(cost,x):
 return sum(cost[i]*x[i] for i in foods)


# 约束条件
# Limit nutrient consumption for each nutrient
def min_nutrient_rule(j,x):
    value = sum(a[i][j]*x[i] for i in foods)
 return Nmin[j] - value


def max_nutrient_rule(j,x):
    value = sum(a[i][j]*x[i] for i in foods)
 return value - Nmax[j]


# Limit the volume of food consumed
def volume_rule(volume,x):
 return sum(volume[i]*x[i] for i in foods) - Vmax
# -*- coding: utf-8 -*-
"""MyProblem.py"""
import numpy as np
import geatpy as ea
class MyProblem(ea.Problem): # 继承Problem父类
def __init__(self):
name = 'MyProblem' # 初始化name(函数名称,可以随意设置)
M = 1 # 初始化M(目标维数)
maxormins = [1] # 初始化maxormins,本问题是最小化cost(目标最小最大化标记列表,1:最小化该目标;-1:最大化该目标)
Dim = 9 # 初始化Dim(决策变量维数),9种食物
varTypes = [0] * Dim # 初始化varTypes(决策变量的类型,元素为0表示对应的变量是连续的;1表示是离散的)
lb = [0]* Dim # 决策变量下界
ub = [10000] * Dim # 决策变量上界,由于这个问题并没有规定上界,因此我们可以自己给一个很大的值,比如100或者10000
lbin = [1] * Dim # 决策变量下边界(0表示不包含该变量的下边界,1表示包含)
ubin = [1] * Dim # 决策变量上边界(0表示不包含该变量的上边界,1表示包含)
# 调用父类构造方法完成实例化
ea.Problem.__init__(self, name, M, maxormins, Dim, varTypes, lb, ub, lbin, ubin)
def aimFunc(self, pop): # 目标函数
Vars = pop.Phen # 得到决策变量矩阵
x = {} # 用一个字典存储决策变量
for i,f in zip(range(len(foods)),foods):
x[f] = Vars[:, [i]] # 怎么用字典得到决策变量矩阵
pop.ObjV = sum(cost[i]*x[i] for i in foods) # 计算目标函数值,最大化10摄氏度时的蒸汽压
# 采用可行性法则处理约束
pop.CV = np.hstack([
volume_rule(volume,x) # 最大体积限制
])
for j in nutrients:
pop.CV = np.hstack( [pop.CV,min_nutrient_rule(j,x) ] ) # 最小营养限制
pop.CV = np.hstack( [pop.CV,max_nutrient_rule(j,x) ] ) # 最大营养限制if __name__ == '__main__':
"""================================实例化问题对象==========================="""
problem = MyProblem() # 生成问题对象
"""==================================种群设置==============================="""
Encoding = 'RI' # 编码方式
NIND = 100 # 种群规模
Field = ea.crtfld(Encoding, problem.varTypes, problem.ranges, problem.borders) # 创建区域描述器
population = ea.Population(Encoding, Field, NIND) # 实例化种群对象(此时种群还没被初始化,仅仅是完成种群对象的实例化)
"""================================算法参数设置============================="""
myAlgorithm = ea.soea_DE_rand_1_L_templet(problem, population) # 实例化一个算法模板对象
myAlgorithm.MAXGEN = 500 # 最大进化代数
myAlgorithm.mutOper.F = 0.5 # 差分进化中的参数F
myAlgorithm.recOper.XOVR = 0.7 # 重组概率
"""===========================调用算法模板进行种群进化======================="""
[population, obj_trace, var_trace] = myAlgorithm.run() # 执行算法模板
population.save() # 把最后一代种群的信息保存到文件中
# 输出结果
best_gen = np.argmin(problem.maxormins * obj_trace[:, 1]) # 记录最优种群个体是在哪一代
best_ObjV = obj_trace[best_gen, 1]
print('最优的目标函数值为:%s'%(best_ObjV))
print('最优的决策变量值为:')
for i in range(var_trace.shape[1]):
print(var_trace[best_gen, i])
print('有效进化代数:%s'%(obj_trace.shape[0]))
print('最优的一代是第 %s 代'%(best_gen + 1))
print('评价次数:%s'%(myAlgorithm.evalsNum))
print('时间已过 %s 秒'%(myAlgorithm.passTime))4、模型结果
可以看到每天的最低消费是15美元,跟pyomo实践里得到的结果一样
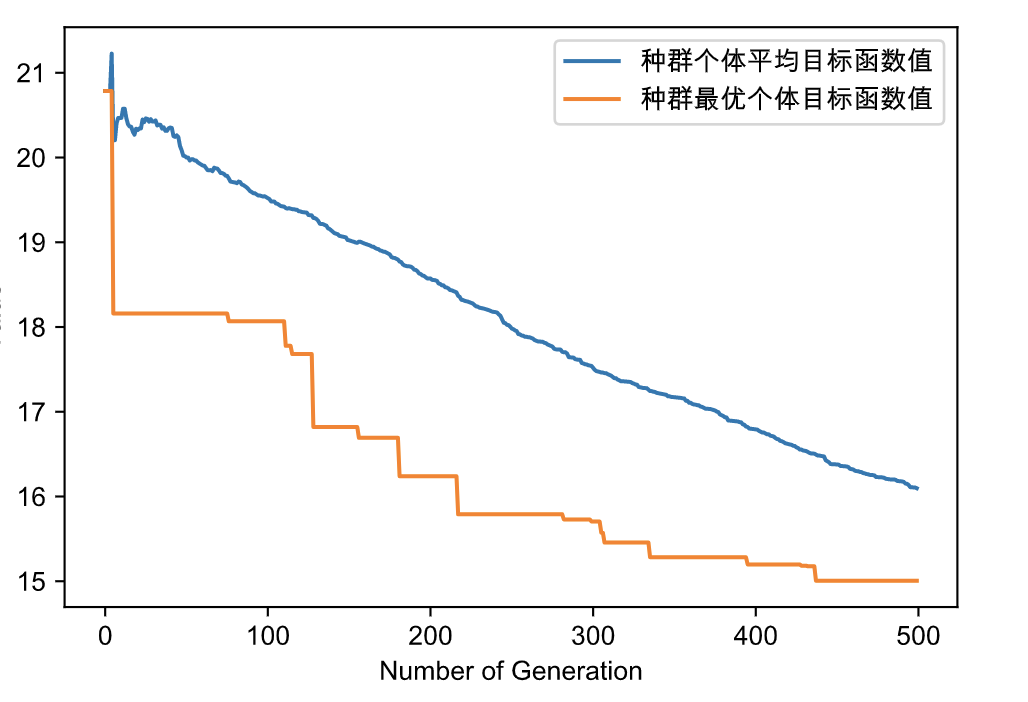
种群信息导出完毕。
最优的目标函数值为:15.006541106717268
最优的决策变量值为:
4.170816605310961
0.0
0.1361945982215054
0.16754066745178284
0.0
5.947026835638826
0.06781133655392207
3.622824405817513
0.0
有效进化代数:500
最优的一代是第 438 代
评价次数:56800
时间已过 0.8515150547027588 秒
参考
【1】python运筹优化(五):多变量规划问题pyomo实践:https://zhuanlan.zhihu.com/p/134950216