avatar

Xiaojun Wu

Ph.D. Candidate, HKUST(GZ)
Affiliate LLM Researcher, IDEA Research
wuxiaojun@idea.edu.cn & wuxiaojun@pku.edu.cn & xwu647@connect.hkust-gz.edu.cn


Writing

Blog

文章会在知乎和本博客同步发布。

Back to homepage

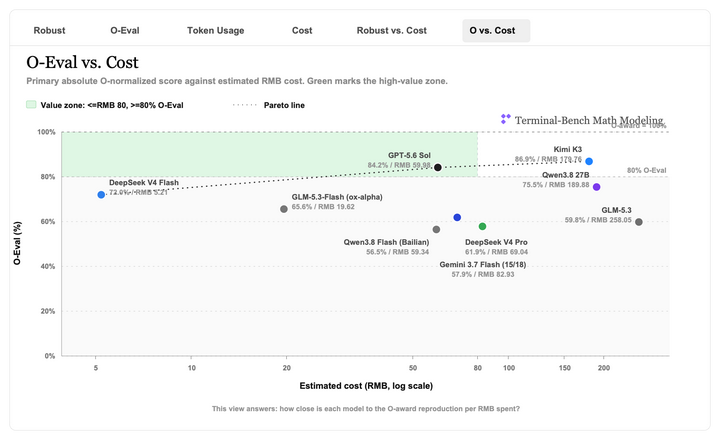
TB-MathModel(一):第一个 Agentic and Verifiable Benchmark for Mathematical Modeling

阅读 知乎未公开 收藏 12 点赞 3

Agentic、verifiable、统一标准环境,对于评测大模型未来解决真实数学建模问题的长程能力,或者把数学建模任务作为 RL envs 去用强化学习优化模型,都有非常重要的意义。如果只看普通数学题,今天的大模型已经很强了。给一道 AIME,给一道证明题,或者给一道高中竞赛题,我们通常能把问题压缩成一句话:最后答案是多少?但真实世界里的数学不是这样...

Read article
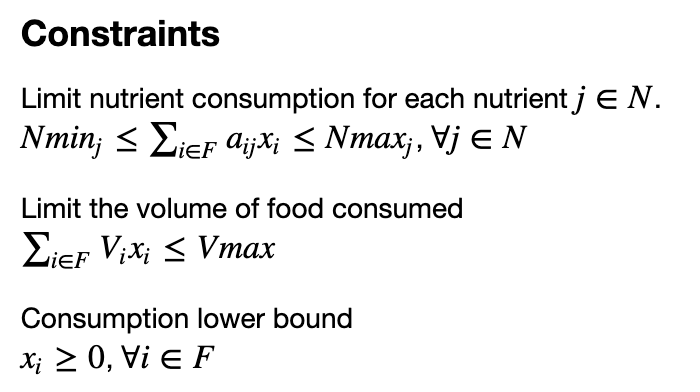
最优化(二):从收益-风险约束看 Adam 和 Muon,优化器如何选择一次更新?

阅读 知乎未公开 收藏 38 点赞 20

上一篇我们从梯度、曲率和参数尺度出发,梳理了 SGD、Adam、AdamW 与 Muon。这一篇换一个视角:金融里的收益与风险。Adam 的更新大致是: 表示平滑后的梯度方向, 表示历史梯度的均方根尺度。形式上,它很像“信号除以波动尺度”,因此容易让人联想到 Sharpe ratio。但这个类比一旦继续追问“哪个参数是资产、哪几个方向组成投资组合”,就...

Read article
最优化(一):从梯度下降到 Adam、AdamW、Muon,优化器到底在优化什么?

阅读 知乎未公开 收藏 57 点赞 26

训练神经网络的时候,我们常说“换个优化器试试”。SGD 不行换 AdamW,AdamW 不稳调学习率,最近又有人把 MLP 和 Attention 的矩阵权重交给 Muon。但优化器到底在做什么?最直观的答案是:每一步都要回答一个问题。 现在参数在这里,loss 在这里,我应该往哪个方向走、走多远,才更可能让 loss 下降?这篇先不急着提出新优化器。...

Read article
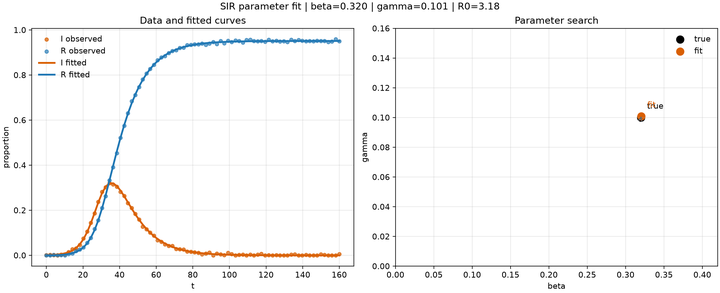
Python 微分方程(六):参数不是猜出来的,怎么把数据拟合回方程里

阅读 知乎未公开 收藏 20 点赞 5

前几篇我们一直在做一类事:已知方程、已知初值、已知参数,往前算曲线。这一篇换个方向。如果题目只给你观测数据,不告诉你 beta、gamma 这些参数,你怎么把它们反推出来?先给一句人话答案:先用微分方程生成一条“猜的曲线”,再拿它和真实数据比差距,差距越小,参数越像真的。这就是参数识别,也可以理解成“把数据拟合回方程里”。这一节的 takeaway:微...

Read article
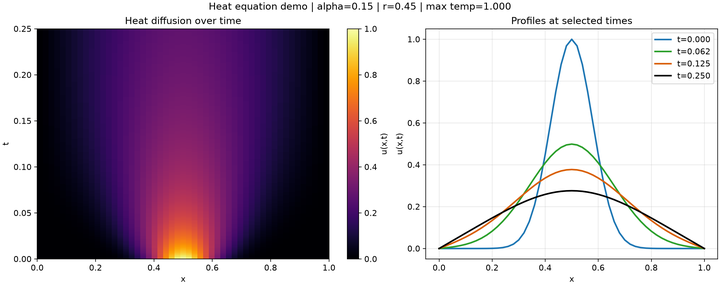
Python 微分方程(五):热量为什么会自己摊平?

阅读 知乎未公开 收藏 29 点赞 6

上一章我们看的是稳态问题:两头条件都给定,空间曲线怎么连起来。这一章再往前一步,把时间加回来。一根两头固定温度的热棒,为什么中间一块热斑会慢慢散开,最后整根棒都变平?先给一句人话答案:每个点都在和左右邻居交换热量,所以高的地方会往低的地方流。这就是热传导方程最核心的直觉。偏微分方程的英文是 partial differential equation,简...

Read article
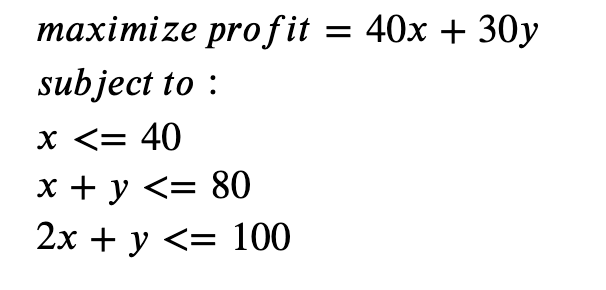
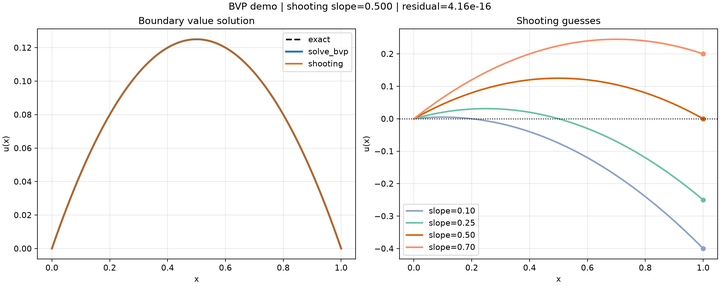
Python 微分方程(四):边值问题,边界条件在两头时怎么办?

阅读 知乎未公开 收藏 2 点赞 2

前几篇我们一直在做一类题:给一个起点,往后推一条曲线。这一篇换一种更麻烦、也更常见的题:如果题目不是给你一个起点,而是把条件放在两头,你还怎么把中间那条曲线找出来?先给一句人话答案:这类题不能只从左边往右走,因为你走到右边以后还得刚好满足右端条件。这就是边值问题的核心。边值问题的英文是 boundary value problem,简称 BVP。先别急...

Read article
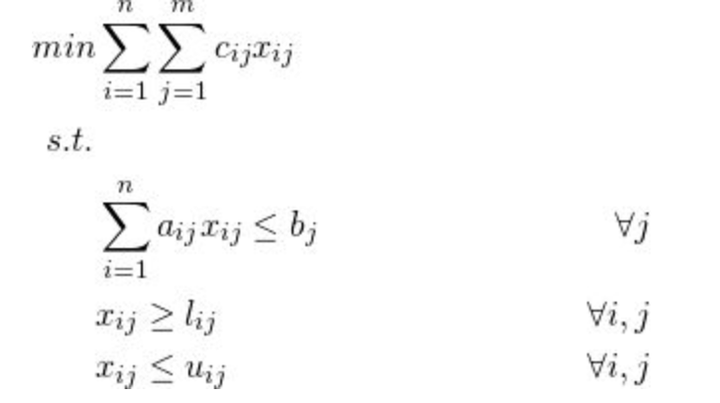
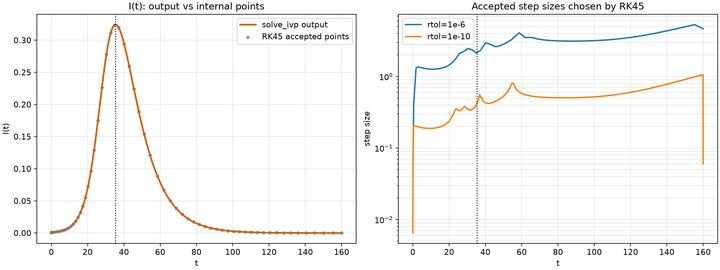
Python 微分方程(三):solve_ivp 到底怎样一步步算出 SIR 曲线

阅读 知乎未公开 收藏 9 点赞 0

前两篇我们都在用这一行:sol = solve_ivp(...)如果教程停在这里,读者会很容易产生一种感觉:我把方程交给一个函数,它把曲线吐出来;至于中间发生了什么,我只能相信它。这就是“概念墙”。这一篇专门拆这堵墙。我们不从数值分析术语开始,而从一个具体问题开始:SIR 模型里,如果只知道今天的 S、I、R,电脑怎么一步步估计明天、后天、再后面的状态...

Read article

Python 微分方程(二):SIR 传染病模型

阅读 知乎未公开 收藏 12 点赞 2

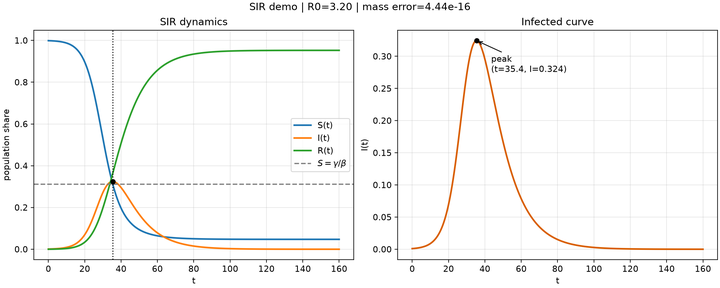
上一篇我们把一个单方程常微分方程跑通了。常微分方程的英文是 ordinary differential equation,简称 ODE。这一篇往前走一步:不只跟踪一个量,而是同时跟踪三类人。这一篇先问一个具体问题:为什么一场传播刚开始会扩散,但过一段时间感染者又会自己降下来?先给一句人话答案:感染者一边把易感者拉进感染桶,一边又有人康复离开感染桶;前者...

Read article

Python 微分方程(一):从 solve_ivp 开始

阅读 知乎未公开 收藏 26 点赞 6

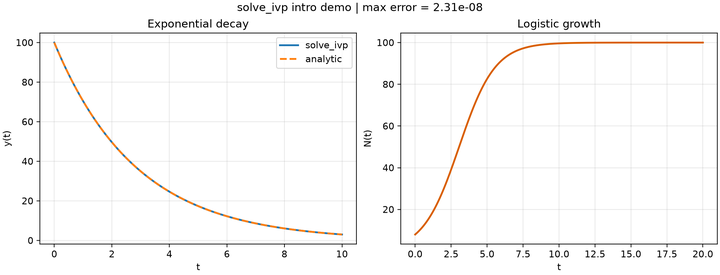
运筹优化更像是在回答“怎么分配才最优”,微分方程更像是在回答“系统会怎么演化”。这两条线在数学建模里经常并排出现:一条处理决策,一条处理动态。这一篇先不碰复杂模型,只做一件事:假设药物进入身体后会按比例慢慢减少,怎么用 Python 算出接下来 10 小时的浓度曲线?这个问题足够小,但已经包含了微分方程建模的完整闭环:建模 - 求解 - 画图 - 解释...

Read article

Agentic数据合成(二):DataArc-SynData-Toolkit 上新:面向 Agent RL Training 的Scalable and Verifiable Envs 合成框架

阅读 知乎未公开 收藏 149 点赞 75

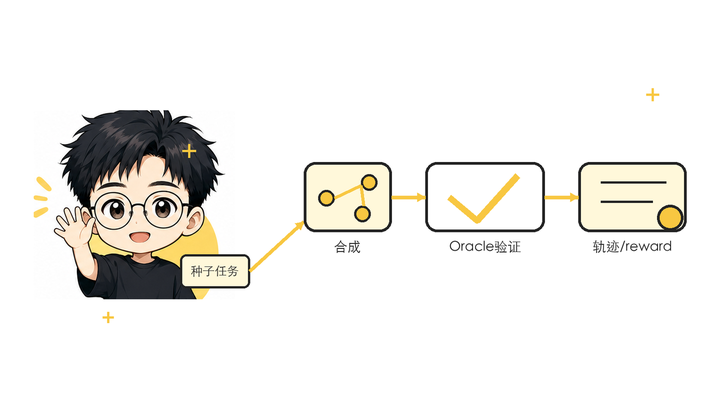
上一篇《高质量 Agent 训练数据,正在怎么被合成?》,里面讲到一个趋势: Agent 训练数据正在从“问答样本”变成“可执行环境 + 任务指令 + verifier + 轨迹 + reward”。 这句话听起来有点抽象。如果你只是训练一个 Chat 模型,一条数据可能是:user question -> assistant answer但如果...

Read article

Bayesian-Agent(六):怎么快速地上手Bayesian-Agent?你其实无需更改你正在使用的Harness,BA可即插即用

阅读 知乎未公开 收藏 14 点赞 6

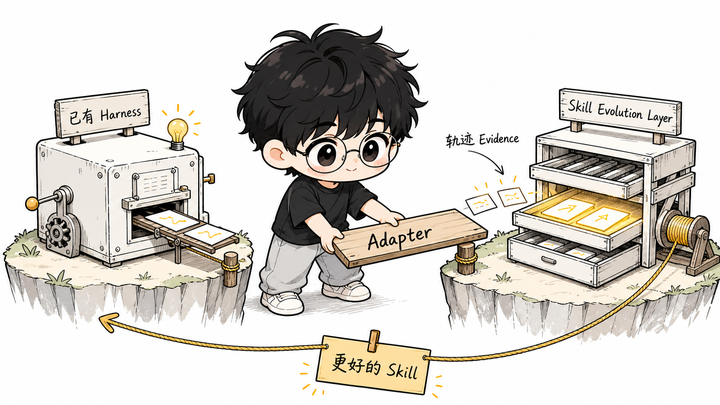
前面几篇文章里,我主要在讲 Bayesian-Agent 为什么需要贝叶斯、它和 frequentist skill evolving 的区别、没有手写 skill catalog 的 zero-shot 模式是否仍然有效。这篇文章换一个角度,回答一个更工程化的问题:如果我已经有自己的 agent 了,怎么快速接入 Bayesian-Agent?论文地...

Read article

Agentic数据合成(一):从CLI-Gym到OpenThoughts-Agent,2026年进展持续更新中。。。

阅读 知乎未公开 收藏 57 点赞 28

高质量 Agent 训练数据,正在怎么被合成?大模型正在从“回答问题”走向“自主操作电脑”。这个转变里,有一个很硬的瓶颈:高质量、可执行、可验证的 Agent 训练数据不够。一个终端任务看起来可能很简单,比如“修好某个测试环境里的失败用例”。但真正把它做成训练数据,通常需要完整的 Docker 环境、初始故障状态、任务指令、验证脚本,以及一条能真正完成...

Read article

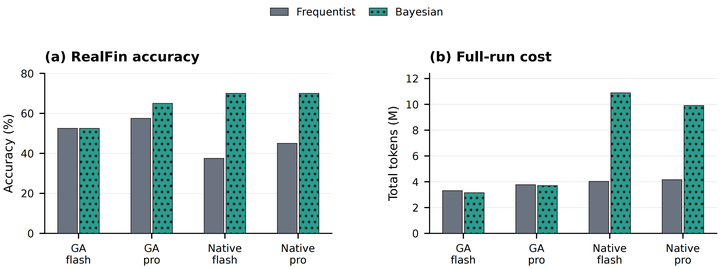
Bayesian-Agent(五):口说无凭,让我们用实验来证明,Agent skill evolving 真的需要贝叶斯

阅读 知乎未公开 收藏 4 点赞 5

我们有什么证据说明 Agent skill evolving 真的需要 Bayesian belief?上一篇文章里,我讨论了一个问题:Agent skill evolving 为什么需要贝叶斯?我直接进化不就行了吗?这个问题很合理。因为如果一个方法最后只是“错了就改 prompt / 改 skill”,那它确实不一定需要叫 Bayesian。它最多是...

Read article

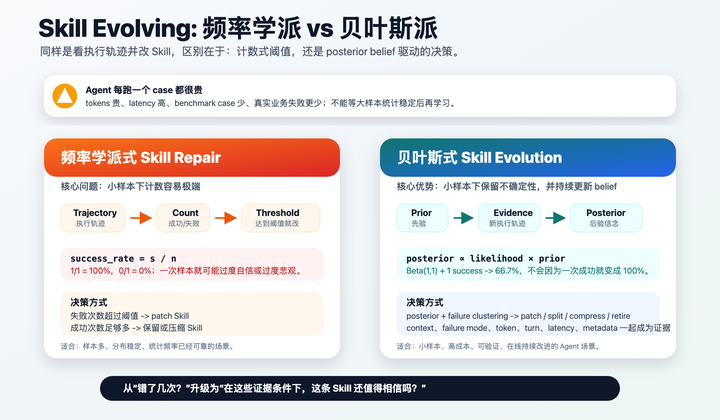
Bayesian-Agent(四):skill evolving为什么需要贝叶斯,我直接进化不就行了吗?

阅读 知乎未公开 收藏 9 点赞 9

那么有的同学就会问了:其实目前Bayesian-Agent的本质也还是根据执行轨迹,看错哪里了去针对性的改skill, 那么我们采用贝叶斯方式建模这个过程的优势在哪里呢?系列文章更新中。。。Bayesian-Agent(三):从三门问题到 Bayesian-Agent:Evidence Model、后天学习与 Skill 自进化Bayesian-Age...

Read article

Bayesian-Agent(三):从三门问题到 Bayesian-Agent:Evidence Model、后天学习与 Skill 自进化

阅读 知乎未公开 收藏 13 点赞 4

当前的大语言模型已经拥有非常丰富的知识和技能,但很多能力仍然需要被进一步验证。其中最重要的一类能力,是能否从经验和教训中反思,并持续改进自己的 Skills。我们把这种能力称为后天学习 acquired learning。从三门问题到贝叶斯skill学习Acquired learning refers to knowledge or skills ga...

Read article

Bayesian Agent (一):让 Harness 与 Skills 的 Self-Evolving过程不再黑盒、没有方向,走向贝叶斯信念

阅读 知乎未公开 收藏 59 点赞 19

最近 Harness Engineering 这个概念开始火起来。AI和大模型领域发展日新月异,Prompt Engineering、Context Engineering、RAG、Memory、Tool Use、Harness新名词层出不穷,好像每个词都是一套新范式。但如果把它们放到同一个视角下看,本质其实很简单:大语言模型吐出的每一个 token,...

Read article

强化学习小白理解GRPO(三):适配自定义任务,以Finance-R1为例

阅读 知乎未公开 收藏 17 点赞 8

唉。。。因为很多事情鸽了很久的第三篇来了,年初前两篇受到很多同学的赞同和好评,这一年大家对于GRPO和强化学习也基本都是很熟悉,各种变体DAPO/VAPO/GSPO等层出不穷,是今年工业界和学术界的“显学“了。这篇就给出第二篇中提出的任务吧,虽然对于技术人员并不难,但是可以作为技术小白的入门。1.任务说明我们的想法时根据一家公司过去5天的新闻,来判断该...

Read article

强化学习小白理解GRPO(二):GRPO核心代码实践

阅读 知乎未公开 收藏 691 点赞 401

系列文章更新中。。。wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践20251203难产的第三篇虽迟但到orz: 强化学习小白理解GRPO(三):适配自定义任务,以Finance-R1为例强化学习小白理解GRPO(四):从 Ad...

Read article

强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀

阅读 知乎未公开 收藏 2187 点赞 1137

20260817第四篇已更新:wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践强化学习小白理解GRPO(四):从 Advantage 加权到分布重塑,SFT、RL 和OPD原来是一家人最近Deepseek-R1-Zero和Dee...

Read article

数独问题的求解与可能的现实意义:以列车调度问题为例

阅读 知乎未公开 收藏 12 点赞 3

最近听说有朋友在做数独游戏,因此探索了一下这个游戏。找了下网上的内容基本都只强调数独游戏的益智性和对于孩子专注性的训练,难道这个数学游戏是不是和其他数学模型一样可以被应用于现实生活中(我认为这是很重要的,数学抽象于现实生活又能够应用于现实生活生产活动中,这就是数学建模的意义不是吗)?现实生活中有哪些问题可以被建模成数独模型吗?最终也是发现确实某些情况下...

Read article

python运筹优化(八):运输问题

阅读 知乎未公开 收藏 223 点赞 58

运输问题是一类特殊的线性规划问题,一般的运输问题就是要解决:把某种产品从若干个产地调运到若干个销地,在已知每个产地的供应量、每个销地的需求量、各地之间的运输单价的前提下,如何确定一个使得总的运输费用最小的方案。具体的数学模型和笔算求解可以参考中国大学MOOC上江西财经大学的运筹学课程。这个课程包含了运筹学要求掌握的所有问题,以及这些问题的单纯形法求解、...

Read article

python运筹优化(七):利用遗传算法为机器学习模型调参

阅读 知乎未公开 收藏 129 点赞 34

作为一名熟练的机器学习调包侠和调参侠,面临的一个很大的问题就是机器学习模型有很多超参数需要人工去调参,超参数的设置很大程度上影响着模型最后预测结果的好坏。特征工程和调参是机器学习算法运用中最耗费人工的2个部分。那么如何利用遗传算法进行把调参变得“高大上”呢?这其实已经触碰到了时下最火热的AutoML(自动化机器学习)的领域了:自动化调参,不需要人工。本...

Read article

python运筹优化(六):多变量规划问题geatpy实践

阅读 知乎未公开 收藏 89 点赞 34

上一篇我们使用pyomo对(啤酒混合策略、燃料设计策略、饮食营养策略)进行了建模求解,这一篇我们自己动手,把这三个问题改写为用遗传算法geatpy进行求解。其中饮食营养策略涉及比较复杂的数据结构,需要动手实践下才能好好理解geatpy的使用语法。特别指出的是,python里的高级数据类型:字典{},可以很方便地辅助我们进行多变量规划问题的建模,life...

Read article

python运筹优化(五):多变量规划问题pyomo实践

阅读 知乎未公开 收藏 118 点赞 29

我们之前都是每个决策变量比较少,可以很方便的写出来(比如只有x1,x2两个决策变量),但如果变量比较多(x1-xi,i是比较大的整数的情况下),也就是我们的目标函数和约束条件出现了连加符号∑的情况,我们的程序该怎么写呢?本篇以啤酒混合策略、寒冷天气混合燃料策略、饮食营养策略三个例子进行讲解。一、实践1:啤酒混合策略(Jenchura, 2017)1、问...

Read article

python运筹优化(四):对偶问题pyomo实践

阅读 知乎未公开 收藏 59 点赞 10

一、对偶问题1、经济含义考虑线性规划问题在这个最大化问题中,当资源i增加一个单位(即资源i的资源限量从bi增加到bi+1)而其他资源都不变时,所引起的目标函数最优值增加的量则称为资源i的影子价格(shadow price)。资源i的影子价格实际上就是资源i的边际利润。影子价格越大,说明这种资源相对紧缺;影子价格越小,说明这种资源相对不紧缺;如果最优生产...

Read article

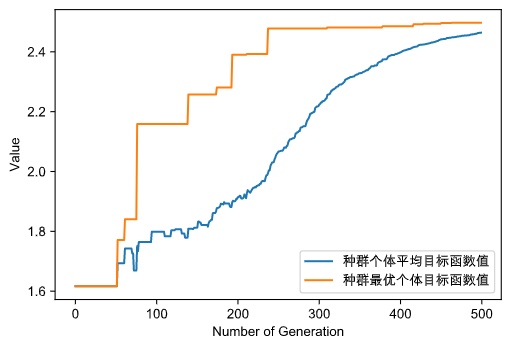
python运筹优化(三):遗传算法和Geatpy使用实践

阅读 知乎未公开 收藏 321 点赞 105

这个专栏以工具实践为主,因此我们先讲进化算法工具包geatpy的使用。关于遗传算法的推导原理我们举一个最简单的袋鼠爬山的例子,然后看遗传算法从头到尾怎么“编码-计算适应度-选择淘汰-基因交叉-基因突变-不断进化” 的。一、geatpy框架Geatpy2整体上看由工具箱内核函数(内核层)和面向对象进化算法框架(框架层)两部分组成。其中面向对象进化算法框架...

Read article

python运筹优化(二):Pyomo使用简介

阅读 知乎未公开 收藏 174 点赞 50

一、概述Pyomo是一个基于python的开源软件包,它支持多种优化功能,用于制定和分析优化模型。Pyomo可用于定义符号问题、创建具体的问题实例,并使用标准解决程序解决这些实例。Pyomo支持多种问题类型,包括:线性规划二次规划非线性规划整数线性规划混合整数二次规划混合整数非线性规划整数随机规划广义分隔编程微分代数方程具有平衡约束的数学规划Pyomo...

Read article

python运筹优化(一):Cplex for python使用简介

阅读 知乎未公开 收藏 482 点赞 153

运筹学(OR)和优化模型包括线性规划(LP)、混合整数线性规划(MILP)和二次规划(QP)。一般我们使用LP/MILP包来单独建模一个实际的优化问题,例如GAMS、AMPL、OPL或其他,然后使用优化求解器(例如CPLEX、gu、Mosek、Xpress等)来解决它,并将最优结果提供给经理和决策者。在OR和数据科学社区中,许多人推荐使用Python这...

Read article

© 2025 Xiaojun Wu. All rights reserved. Powered by Jekyll and Minimal Light theme.