
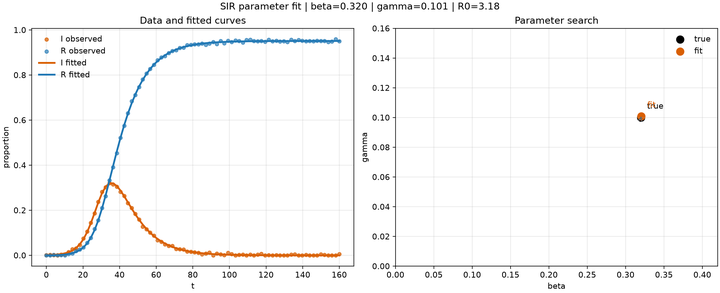
前几篇我们一直在做一类事:
已知方程、已知初值、已知参数,往前算曲线。
这一篇换个方向。
如果题目只给你观测数据,不告诉你 beta、gamma 这些参数,你怎么把它们反推出来?
先给一句人话答案:
先用微分方程生成一条“猜的曲线”,再拿它和真实数据比差距,差距越小,参数越像真的。
这就是参数识别,也可以理解成“把数据拟合回方程里”。
这一节的 takeaway:微分方程不只会正向求解,还可以反过来做参数标定。
0. 先看最小问题
还是用第二篇的 SIR 模型。
SIR 是 Susceptible-Infectious-Recovered 的缩写,中文通常叫“易感者-感染者-康复者模型”。
这一次我们不再问“曲线会怎么走”,而是问:
如果我已经看到了几天的感染人数,能不能倒推出这次传播有多强、恢复有多快?
这类问题很常见:
- 疫情数据反推传播参数
- 药物浓度反推代谢速率
- 生态数据反推种群增长率
这一节的 takeaway:很多建模题不是在算未来,而是在用数据倒推模型里的参数。
1. 变量和未知量不是一回事
这一篇里有两层量。
第一层是状态变量:
-
S(t):易感者比例 -
I(t):感染者比例 -
R(t):康复者比例
第二层是参数:
-
beta:传播速率 -
gamma:康复速率
状态变量是“这一天系统长什么样”。
参数是“这套系统的性格有多强”。
这里最容易犯的错,是把参数当成状态。
例如 beta 和 gamma 不是每天都在变的曲线,它们更像是模型的旋钮。
如果你换一批数据,旋钮可能要重拧,但在一次拟合里,它们通常先假设为常数。
顺手再提醒一句:
beta 和 gamma 不是概率,不需要卡在 0 到 1 之间,也不一定要“大于 1”。
它们是按时间单位计的速率,常见写法就是“每天 0.32 次”“每天 0.10 次”。
这一节的 takeaway:状态变量描述系统当前状态,参数描述系统运行方式。
2. 先造一份能验算的假数据
最小可用做法不是直接上真实数据,而是先造一份“像真的”数据。
这样有两个好处:
- 你知道真相,方便检查拟合有没有跑偏
- 你可以控制噪声大小,观察拟合有多稳
我们先选一组“真参数”:
beta_true = 0.32gamma_true = 0.10
再用它们生成一条 SIR 轨迹,然后在 I(t) 和 R(t) 上加一点小噪声。
这一步的意思是:
先假装自己只有观测值,再看能不能把原始参数找回来。
这一节的 takeaway:先做合成数据,是最省力也最稳的验算方式。
3. 残差是什么
拟合的核心不是“猜一个参数”,而是“算两条曲线的差”。
这条差就叫残差。
如果观测值记成 y_obs,模型预测值记成 y_pred,那最朴素的残差就是:
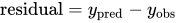
如果我们同时盯住 I(t) 和 R(t),那残差就可以拼成一个向量:
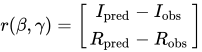
求解器要做的事,就是不断调 beta 和 gamma,让这个残差向量尽量短。
这一节的 takeaway:参数拟合本质上就是“把预测和观测之间的差压到最小”。
4. least_squares 怎么找参数
SciPy 里最顺手的工具之一是 least_squares。
它的人话版本就是:
你给我一个参数猜测,我帮你反复缩小残差。
如果只拟合一个显式函数,curve_fit 也很好用。
但只要模型本身先要跑一遍 solve_ivp,least_squares 往往更顺手,因为它更通用。
这里我们用 least_squares,因为它正好能把“微分方程 + 拟合”串起来。
这一节的 takeaway:curve_fit 适合直接拟合曲线,least_squares 更适合包着一个微分方程模型一起拟合。
5. solve_ivp 和 least_squares 怎么接起来
这一步的逻辑其实很朴素:
-
least_squares先给一组参数 -
solve_ivp用这组参数算出整条轨迹 - 把轨迹和数据比差距
-
least_squares再改参数 - 重复直到残差足够小
代码可以写成这样:
import numpy as np
from scipy.integrate import solve_ivp
from scipy.optimize import least_squares


def sir_rhs(t, y, beta, gamma):
    # y = [S, I, R],分别是三只桶里的比例
    S, I, R = y

    # infection 对应 S -> I 的流量
    infection = beta * S * I

    # recovery 对应 I -> R 的流量
    recovery = gamma * I

    # 三个桶的净变化速度
    dS_dt = -infection
    dI_dt = infection - recovery
    dR_dt = recovery
    return [dS_dt, dI_dt, dR_dt]


def simulate(beta, gamma, t_eval, y0):
    # 这一步就是“给定参数,正向解出曲线”
    sol = solve_ivp(
        lambda t, y: sir_rhs(t, y, beta, gamma),
        (t_eval[0], t_eval[-1]),
        y0,
        t_eval=t_eval,
        method="RK45",
        rtol=1e-8,
        atol=1e-11,
    )
    if not sol.success:
        raise RuntimeError(sol.message)
    return sol.y


def residual(params, t_eval, y0, i_obs, r_obs, sigma_i, sigma_r):
    # params = [beta, gamma]
    beta, gamma = params
    s_pred, i_pred, r_pred = simulate(beta, gamma, t_eval, y0)

    # 残差向量:观测值和预测值的差
    r_i = (i_pred - i_obs) / sigma_i
    r_r = (r_pred - r_obs) / sigma_r
    return np.concatenate([r_i, r_r])
这里有两个很重要的小地方:
-
simulate()负责“前向算曲线” -
residual()负责“把差距交给优化器”
也就是说,solve_ivp 还是那个正向求解器,least_squares 负责反向找参数。
这一节的 takeaway:参数识别就是把“正向模拟器”包进“反向搜索器”里。
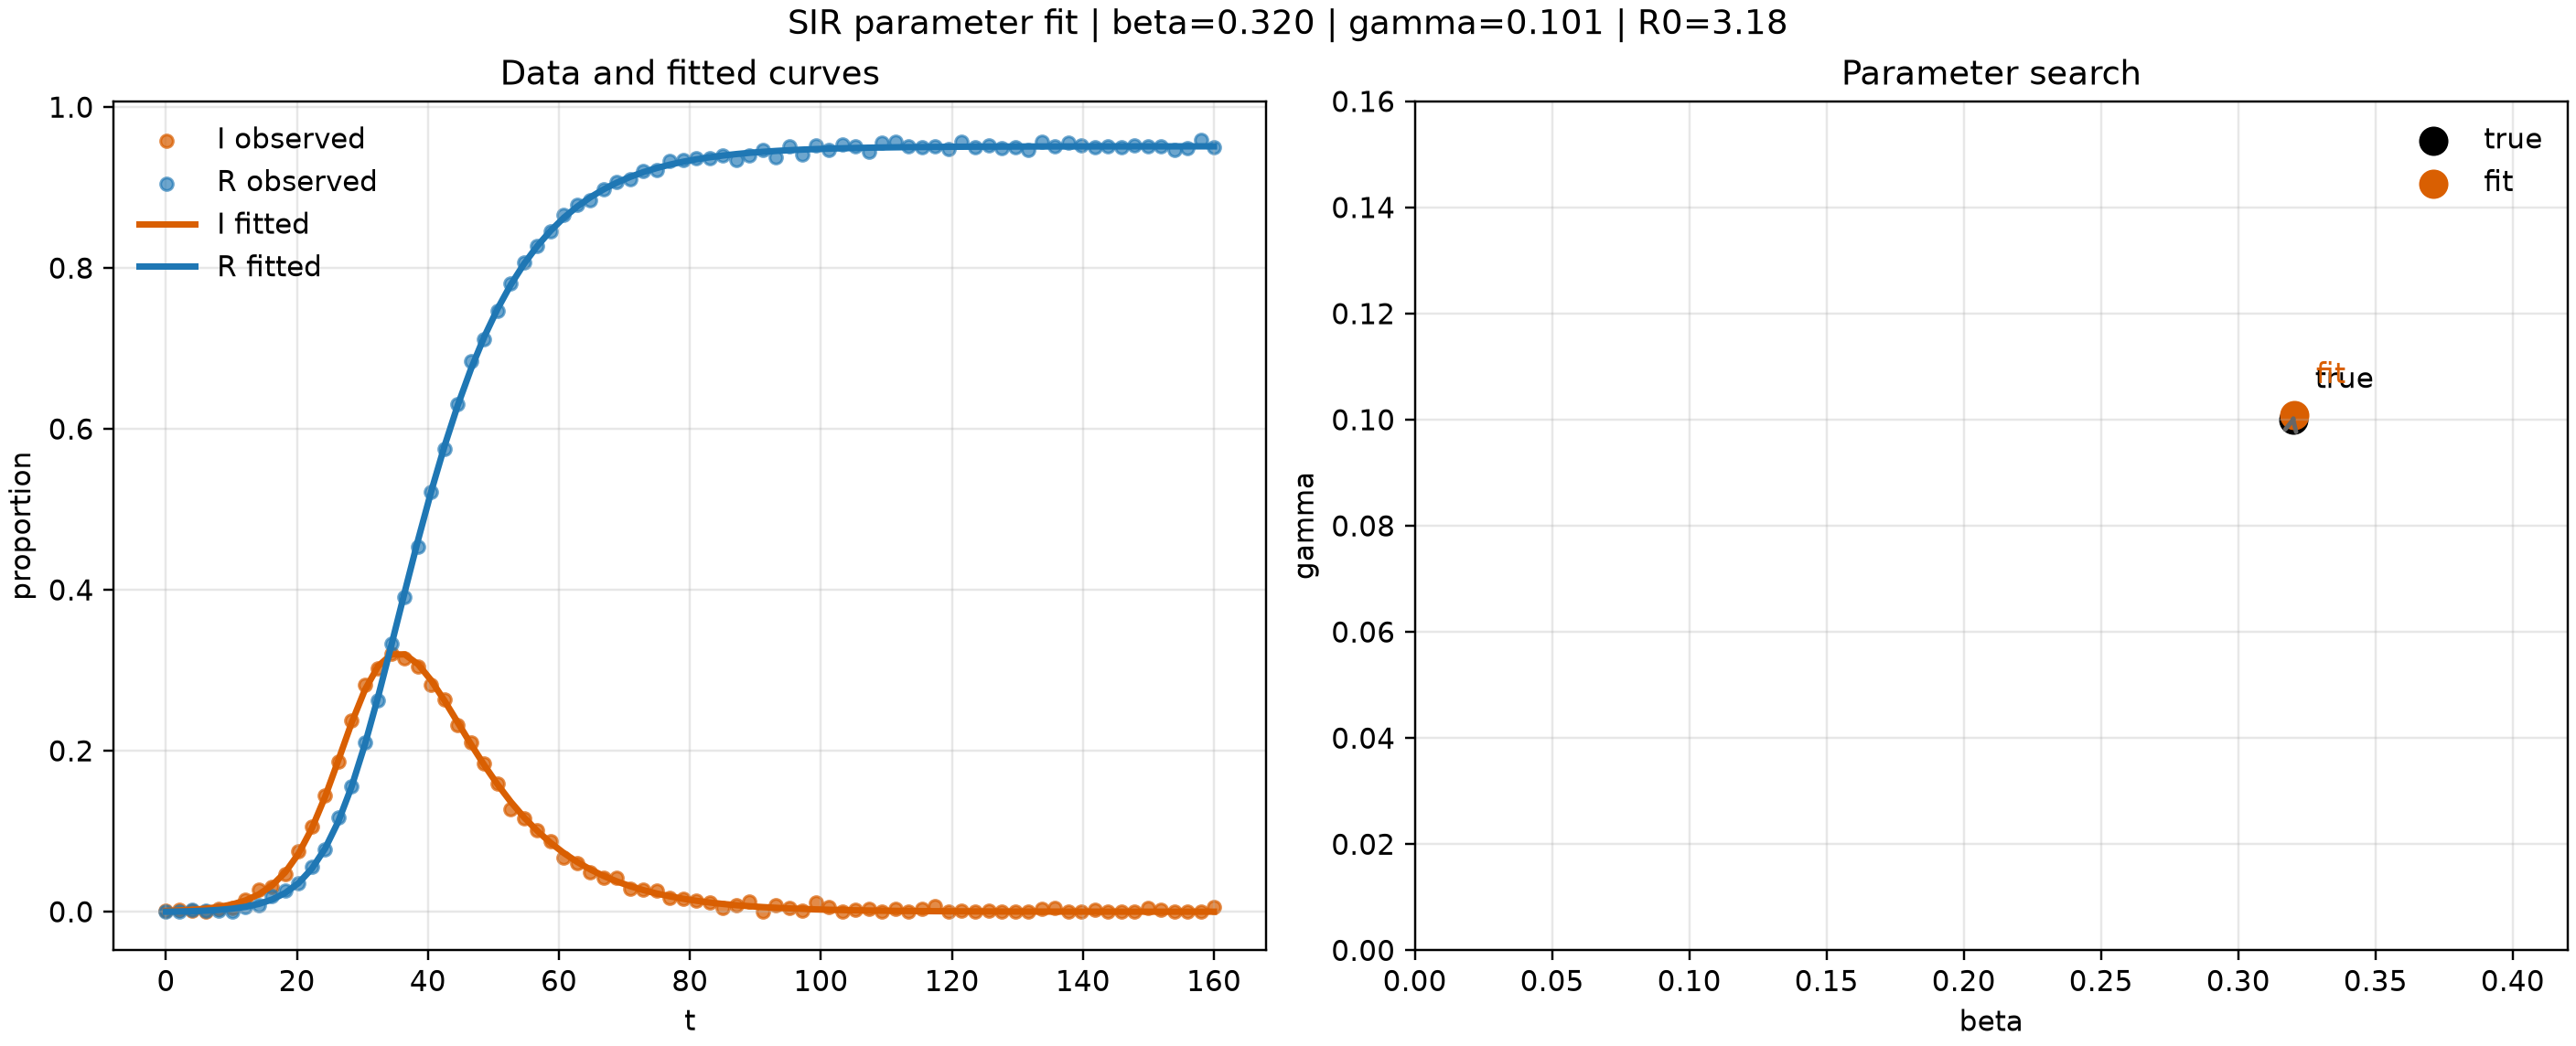
6. 结果怎么看
拟合完成后,最值得看的不是“参数是不是精确到小数点后很多位”,而是三件事:
- 拟合曲线有没有压住数据点
- 拟合出来的参数是不是还讲得通
- 残差是不是还有明显结构
如果曲线看上去贴得很紧,但参数已经离谱,那往往说明:
你的模型写得太简单,或者数据本身不够支撑这些参数。
如果残差不是随机散开的,而是有系统偏差,那说明:
模型缺了东西。
这一节的 takeaway:拟合好不好,不只看图像贴不贴,还要看参数和残差有没有讲得通。
7. 一个很现实的提醒
只拟合一条曲线,常常不够。
这是因为不同参数有时会“互相顶替”:
-
beta大一点 -
gamma也大一点 - 结果曲线还是差不多
所以真实建模里,最好同时利用更多信息:
- 多个观测量
- 不同时间段的数据
- 边界条件或先验经验
这不是在“增加麻烦”,而是在给参数更多约束。
这一节的 takeaway:数据越少,参数越容易互相替代;数据越完整,拟合越稳。
8. 小结
这一篇压成一句话就是:
微分方程不只是拿来往前算的,它也可以拿来反推参数;做法就是用 solve_ivp 生成预测,再用 least_squares 把预测和观测之间的残差压下去。
如果只记五句话,就记这五句:
-
SIR是Susceptible-Infectious-Recovered -
beta和gamma是速率,不是概率 - 参数和状态变量不是一回事
-
solve_ivp负责正向模拟,least_squares负责反向找参数 - 拟合不能只看曲线,还要看残差和参数是否合理
下一篇我们换到 FiPy,看污染物为什么会一边走一边散。