
20260817第四篇已更新:
- wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀
- wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践
- 强化学习小白理解GRPO(四):从 Advantage 加权到分布重塑,SFT、RL 和OPD原来是一家人
最近Deepseek-R1-Zero和Deepseek-R1的发布让全世界的开发者都沸腾了,大家第一次见到ChatGPT-o1级别的开源模型,实际体验下来大家也都十分满意,纷纷开始退订20刀乐(x)。
如何评价 DeepSeek 新发布的 R1 与 R1-Zero 模型?
DeepSeek-R1 模型发布,性能对标 OpenAI o1 正式版,大家怎么看?
机器之心:Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释
而Deepseek R1取得成功的方法其实早已发布,那就是LLM强化学习算法Group Relative Policy Optimization(GRPO)。我们知道,现在互联网的高质量数据基本训练完了,后面基本都得靠RL和大模型自我进化了。而且R1 Zero确实让人看到了一些Alpha Zero的影子,只通过RL训练便能够“涌现”在深度推理回答的长度和反思的能力。
但是对于之前没有接触过这个领域的初学者来说,对于强化学习算法入门,往往教程一上来就policy, ppo, reward, advantage, actor, critic一大堆新的专有名词出现,看的两眼一黑(没错就是在下。。。)那么有没有一个通俗易懂的说法能让人先从直觉上理解强化学习呢?本文尝试给出一个自己的直觉理解,希望小白看完也有原来如此的感受,希望大佬们多多指正。
首先知乎上有不少文章其实讲的不错了,我这里推荐两篇入门我感觉写的很好的文章。第一篇是李宏毅老师强化学习课程的笔记,讲述了强化学习的基本概念;第二篇是强化学习在LLM上的实践。
入门必看第一篇:飞多多:强化学习之PPO算法
入门必看第二篇:为什么需要RLHF?SFT不够吗?
大概看了以上两篇文章后我们对LLM RLHF有了一个基本的理解,接下来我们从三步逐步推进对GRPO核心公式的理解:
一、最简单来理解
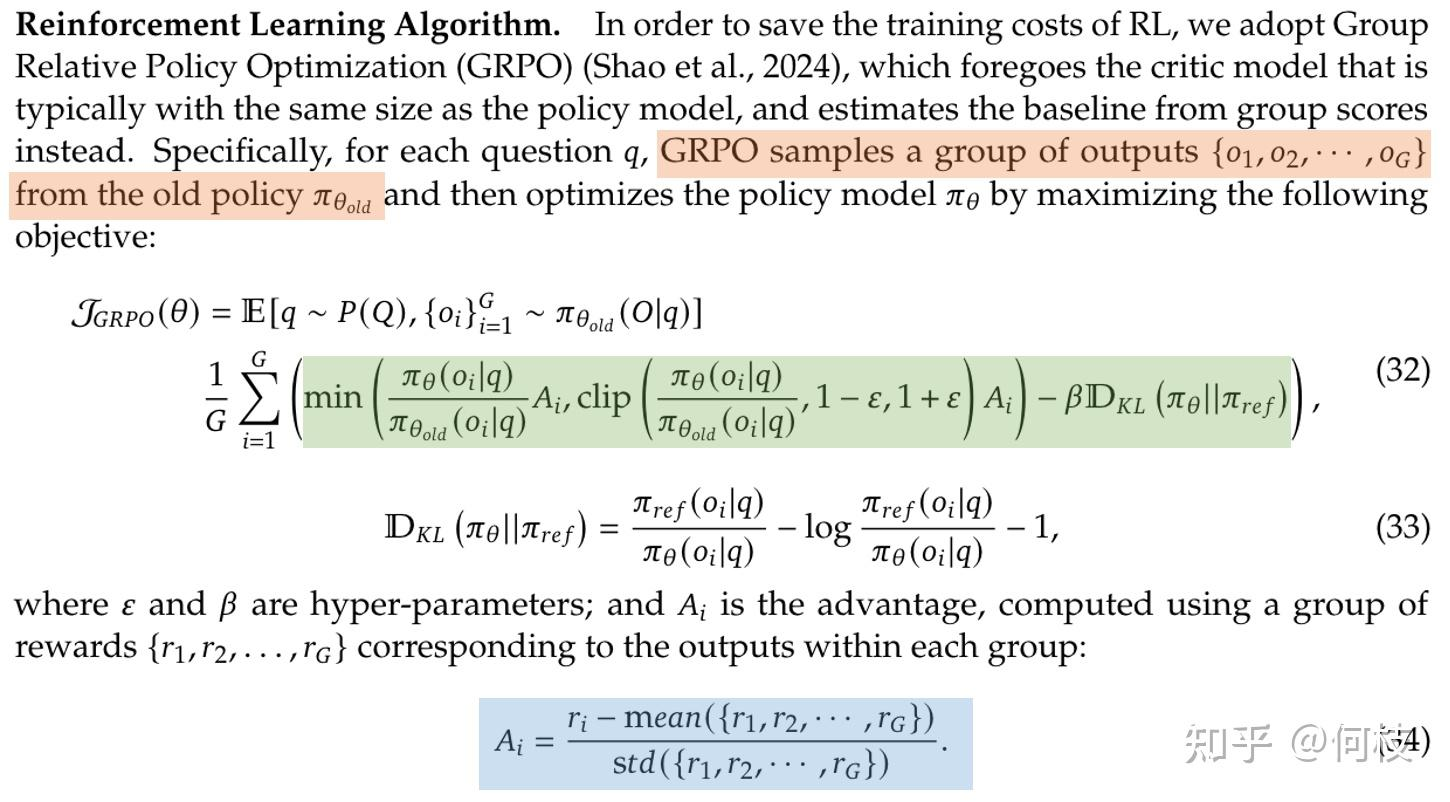
首先整个训练的目标就是最大化这一整坨公式实在是让人有点打退堂鼓有点 ,但是不怕整个公式其实最核心的就是看
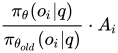 这部分就行。
clip括号里那一坨我们先不看,那个就是裁剪用的而已;
那么核心第一个是就是概率比  ,也就是新模型输出(o1, o2, ..., oi)的概率, 除以老模型的概率;
然后乘以Ai就是Advantage(其实就是标准化下reward,看公式34) , 简单理解也就是给上面的概率比乘了一个系数, 越好的oi, 肯定reward ri就大,Ai就大, 从而训练模型去输出更好的output。
这样就没了?没错就是这样就够了!通过上一步的自己输出oi,基于规则给出oi的反馈奖励信号reward(比如数学题就是看最终的答案正不正确),然后就可以愉快的不断训练自身  了,这个过程甚至不需要人类的参与!
二、这个概率比其实就是第一篇文章中提到的重要性采样!
概率比 其实是重要性采样!!!
为什么说GRPO中的概率比是重要性采样?
1. 重要性采样的基本概念:
重要性采样是一种通过调整样本权重,用旧分布(旧策略)的样本来估计新分布(新策略)期望值的方法。其核心公式为:
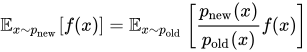
其中  是重要性权重,用于修正新旧分布之间的差异。
2. GRPO中的重要性采样应用:
GRPO的目标函数中,  的作用与重要性权重完全一致:
- 旧策略生成样本:GRPO从旧策略  中采样一组输出
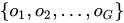 。
- 新策略的期望优化:通过重要性权重  ,将旧策略样本的奖励(或优势
 )调整到新策略的期望下。
- 最大化调整后的目标:优化目标是让新策略在旧策略的样本上,尽可能多地保留高奖励的输出(即最大化  )。
3. 与经典策略梯度方法的对比:
传统策略梯度(如第一篇文章提到的Policy Gradient)直接通过蒙特卡洛采样估计梯度,但需要大量新策略的样本。而GRPO通过重要性采样,复用旧策略的样本来估计新策略的改进方向,显著降低了训练成本。
三、Advantage, Dkl, Clip等其他部分介绍
1. Advantage优势函数: 是优势函数,它通过标准化奖励来计算。优势函数的作用是衡量某个输出  相对于平均输出的优劣。如果某个输出的奖励
 高于平均值,那么 会为正,反之则为负。这样,策略模型会更倾向于生成那些具有较高奖励的输出。
2. KL散度:公式中的 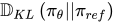 是KL散度,用于衡量新策略 和参考策略也就是我们sft之后已经具有指令遵循功能的那个模型
 之间的差异。KL散度的引入是为了防止新策略偏离参考策略太远,从而保持一定的稳定性。
3. 裁剪(Clip):前面提到可以先不看裁剪部分,但它实际上是为了防止策略更新过大,从而避免训练不稳定。裁剪操作通过限制概率比 的范围来确保策略更新在一个合理的范围内。
4. 目标函数:整体目标函数 结合了概率比(重要性采样)、优势函数和KL散度,旨在通过最大化这个目标函数来优化策略模型。
四、总结:GRPO与PPO的关联与区别
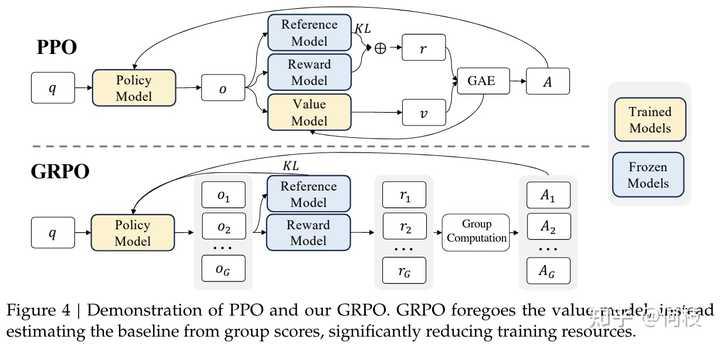
GRPO的灵感来源于PPO(Proximal Policy Optimization),但有以下关键差异:
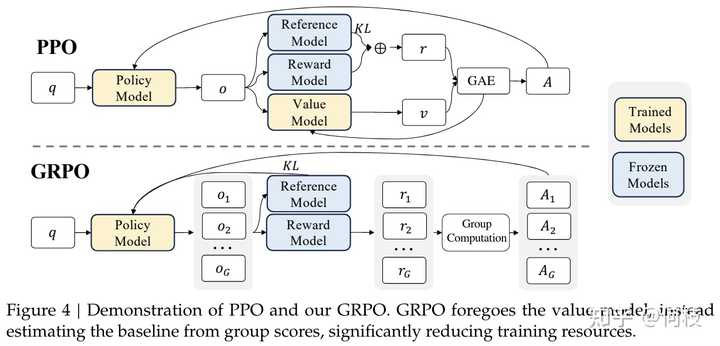
- PPO通常依赖一个独立的价值模型(Critic)来估计优势 ,需要额外训练一个模型。
- GRPO的创新点:直接使用组内样本的奖励计算基线(如 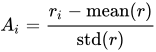 ),无需Critic模型,降低了计算成本。
总结一下:
- 重要性采样是GRPO的核心机制:通过复用旧策略的样本,用重要性权重 调整新策略的优化方向。
- 优势函数的作用:标准化后的奖励 帮助策略区分高价值样本和低价值样本,引导模型优先提升高奖励输出的概率。
- GRPO的工程优势:省去Critic模型,仅依赖组内奖励统计量,适合资源受限的场景。
最后,这篇文章只是给GRPO最核心的公式( 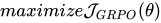 )一个直觉上的解释,肯定还有很多不严谨的地方,希望各位大佬批评指正。
talk is cheap, show me the code. 接下里我们结合代码讲解,整个过程将会更加清楚。