
最近一篇文章 SFT, RL, and On-Policy Distillation Through a Distributional Lens 很火。它试图用一个统一的“分布视角”,解释监督微调(Supervised Fine-Tuning,SFT)、强化学习(Reinforcement Learning,RL)和策略内蒸馏(On-Policy Distillation,OPD)到底在做什么,以及为什么 RL 和 OPD 往往比 SFT 更不容易遗忘。
我读完的第一反应是:这和我们这个系列其实同出一个思想。
在系列第一篇里,我没有从一整套传统强化学习术语讲起,而是把 GRPO 的核心直觉压缩成一句话:模型自己生成一组 rollout,再用 Advantage 给这些 rollout 加上有正有负的权重;好的答案提高概率,差的答案降低概率。
这篇新文章把同一个直觉往前推了一步:不要只看某一个答案的概率,而要把大语言模型看成一个对所有可能回答的概率分布。SFT、RL 和 OPD 的区别,就是它们用不同的数据来源和反馈信号,重新搬运这个分布里的概率质量。
本文配图均来自上述原博客。
一、先给一句人话答案
假设模型面对一道题,可以生成成千上万种回答。训练的目的并不是把某个神秘的“推理模块”塞进模型,而是改变这些回答的概率:让好回答更容易被采样到,让坏回答更难出现。
三种方法可以先粗暴地理解成:
- SFT:老师先写好标准答案,模型照着抄。
- RL:模型先自己答题,再根据成绩调整每种答法的概率。
- OPD:学生先按自己的习惯往下写,老师再在学生真正走到的每一步上,告诉它下一个 Token 应该怎么分配概率。
它们表面上分别叫监督学习、强化学习和蒸馏,底层却都在做同一类事情:通过 log probability 的梯度,重塑模型的输出分布。
当然,这不代表三个算法完全相同。真正关键的区别有两个:
- 训练样本从哪里来;
- 每个样本或 Token 的权重由谁决定。
后面所有差异,基本都是从这两点长出来的。
二、共同的地基:交叉熵、最大似然和概率分布
先从所有深度学习同学都熟悉的交叉熵开始。
语言模型对一段回答 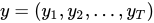 的概率是:
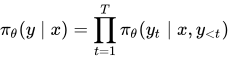
取对数以后,乘法变成加法:
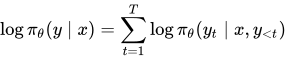
SFT 最常见的 loss 就是负对数似然:
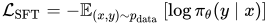
所以:
最小化交叉熵 loss,就是最大化训练数据在模型下的似然。
从信息论看,同一件事还可以写成:
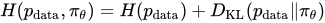
数据分布  固定时,它自己的熵
 是常数。因此,最小化交叉熵等价于最小化数据分布到模型分布的 forward KL,也等价于最大似然估计。
这就是统一视角的地基:训练大模型,本质上一直在改变模型给不同序列分配的概率。
三、SFT:在外部数据上做“等权最大似然”
SFT 的训练数据在训练前就已经存在。它可能由人类标注,也可能由一个更强的模型生成,但对当前模型来说,它都是一个外部分布。
假设标准答案里出现了:
因此,答案是 5。
SFT 会逐 Token 提高这句话的概率。“因此”要提高,“答案”要提高,“是”要提高,“5”也要提高。loss 并不知道哪个 Token 决定了任务正确性,哪个只是老师的写作习惯;默认情况下,每个目标 Token 都得到密集监督。
这当然非常有用。模型还不会遵循指令、不会输出规定格式,或者我们就是希望它学会某种明确风格时,SFT 往往是最快的冷启动方法。
但从分布上看,它也有一个天然风险:外部数据分布可能离当前模型很远。 模型会被直接拉向示范答案,而训练目标本身并不关心这条路会不会破坏原有能力。
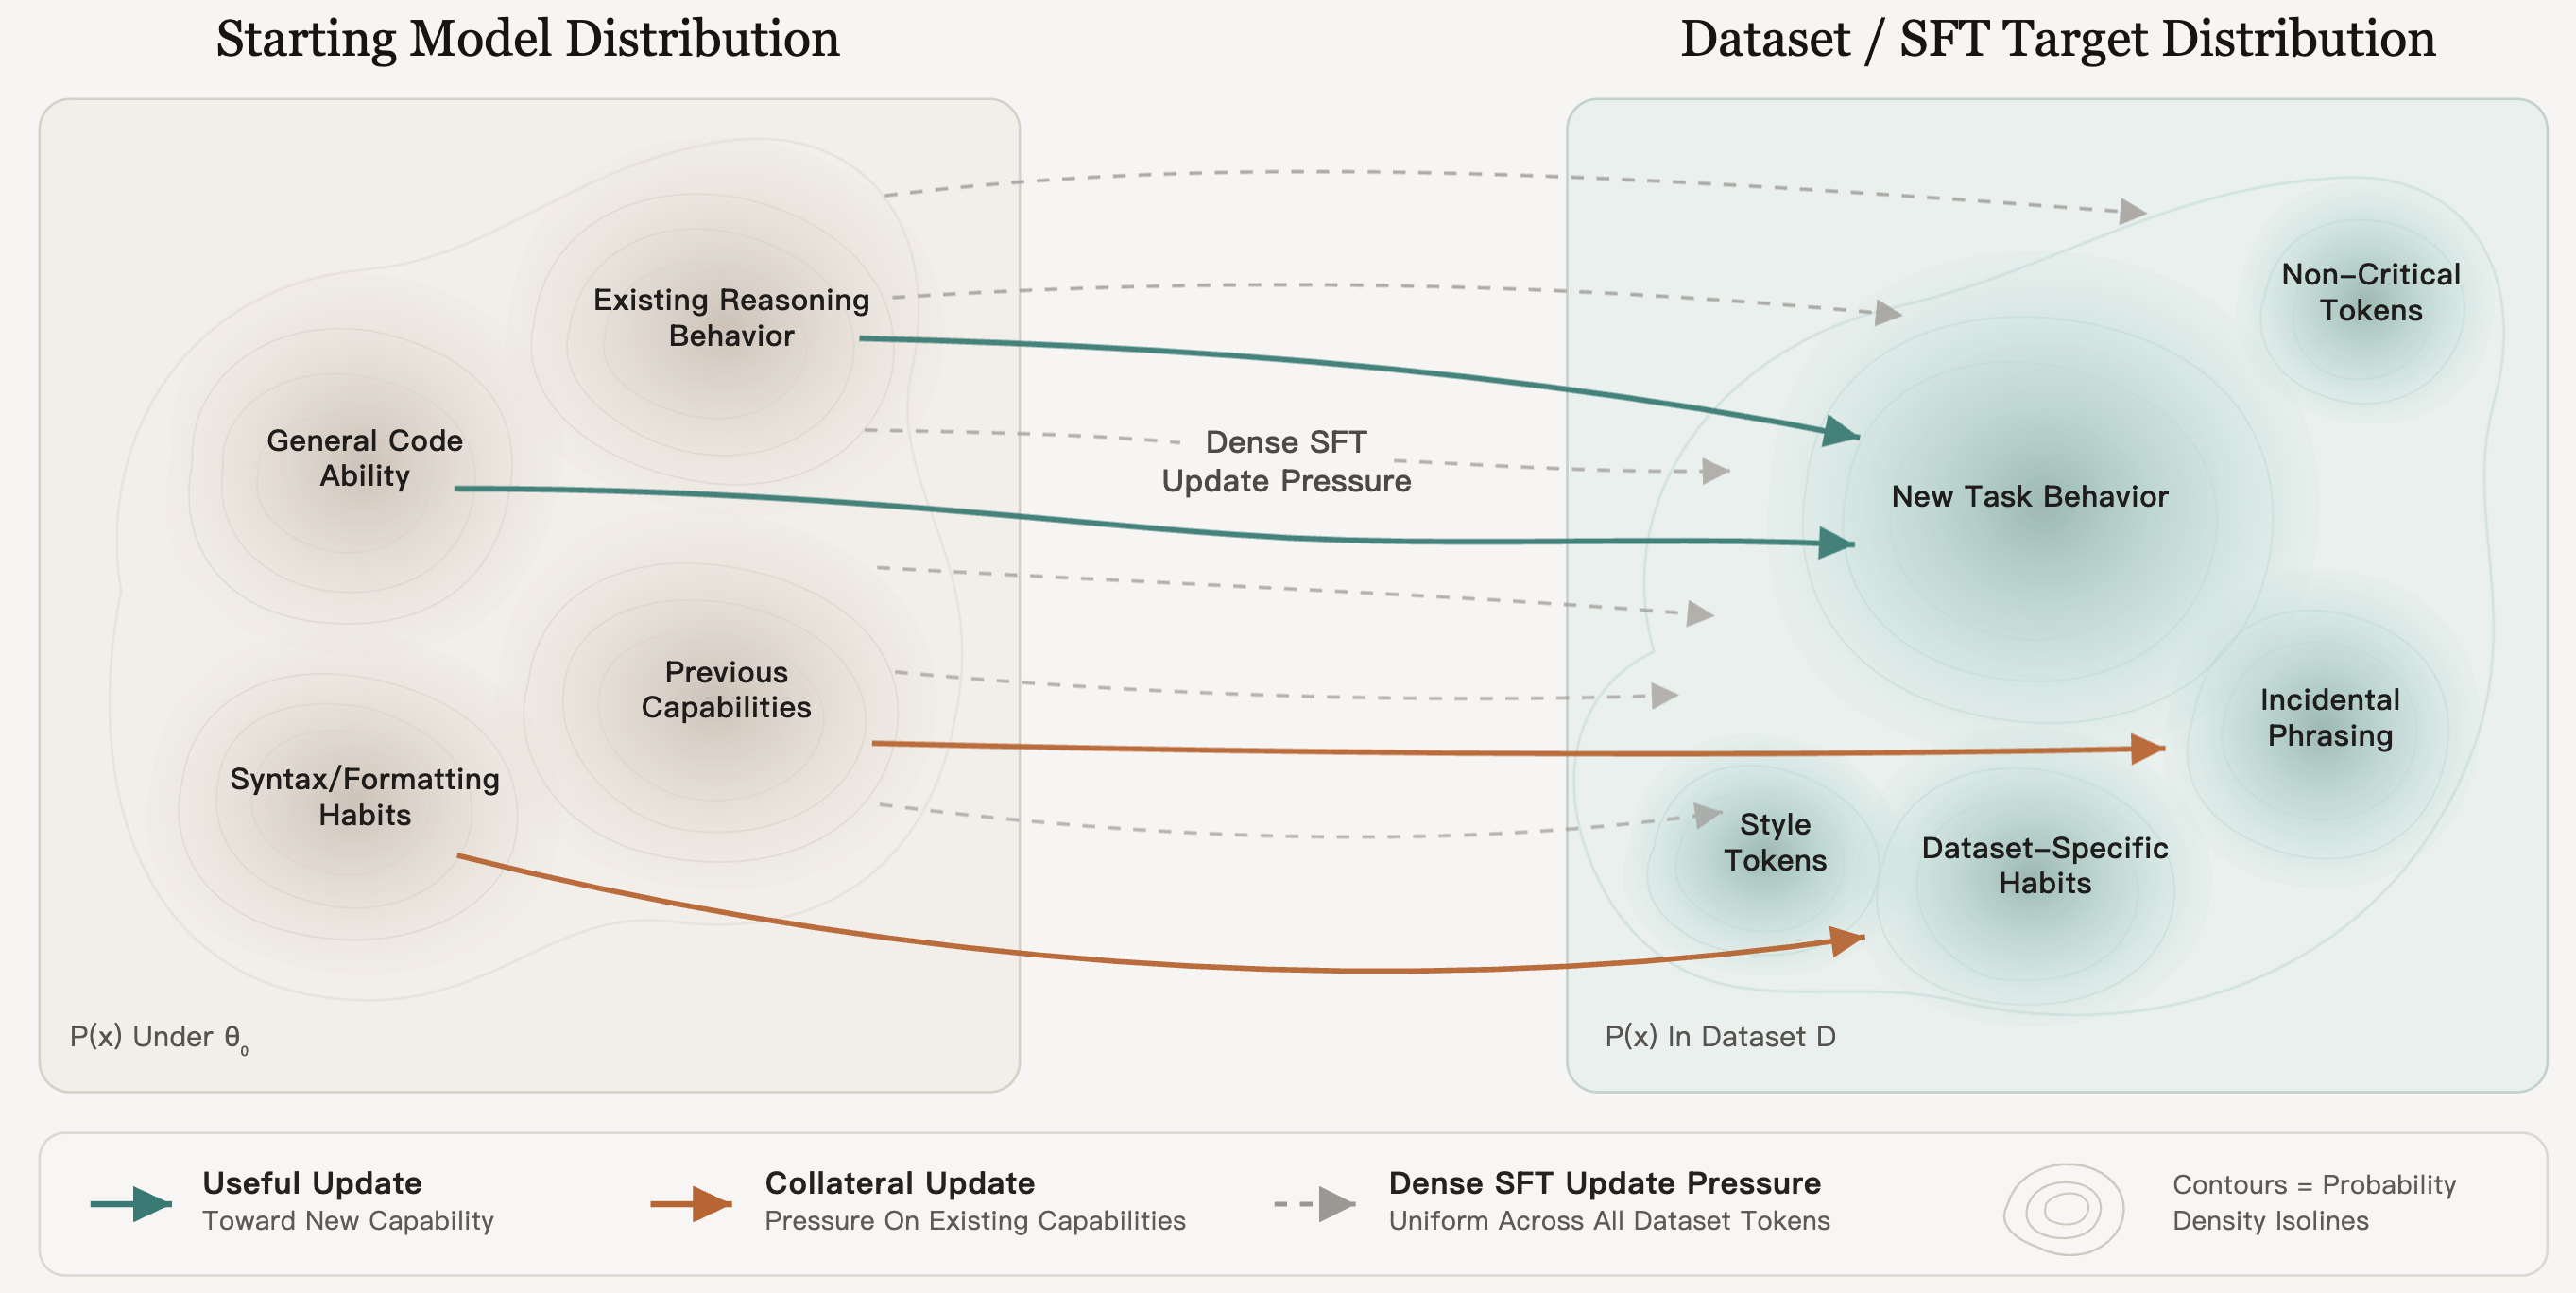
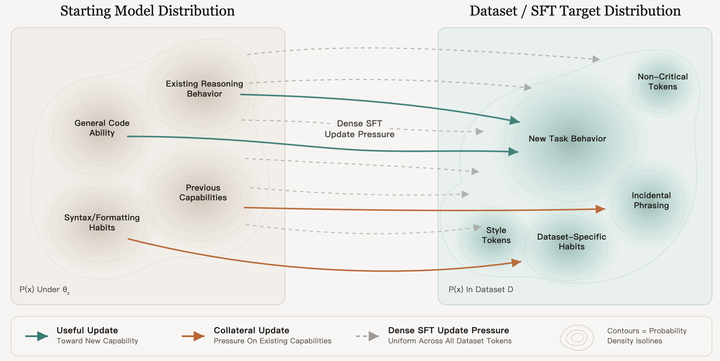
原博客这张图画得很直观:SFT 的梯度压力来自外部数据中的每一个 Token。真正与新任务有关的更新、示范数据的偶然写法,以及可能伤害旧能力的附带更新,全都混在一起。
所以 SFT 可以理解为:
在一个外部固定分布上,对示范序列做等权的最大似然。
四、RL/GRPO:在自己的 rollout 上做 Advantage 加权
再看 RL。
这次没有唯一的标准答案。模型先根据当前策略生成多个 rollout,然后奖励函数给这些 rollout 打分。GRPO 再通过组内比较得到 Advantage。
拿一个最小例子来说,同一道题生成了三个答案:
- 回答 A:正确而简洁,
 ;
- 回答 B:答案正确但过程绕,
 ,不过可能更小;
- 回答 C:答案错误,
 。
忽略裁剪、KL 正则等工程细节,策略梯度最核心的形状是:
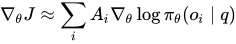
这个式子对有深度学习背景的人其实非常友好:它仍然是一个 log probability 梯度,只不过每个 rollout 前面多了一个有正有负的样本权重  。
-
 :提高这个 rollout 的概率;
-
 :降低这个 rollout 的概率;
-
 :基本不动。
所以更准确地说,RL 不是简单地“模仿所有高分数据”,而是在当前模型已经生成出来的回答之间,按相对好坏重新分配概率质量。
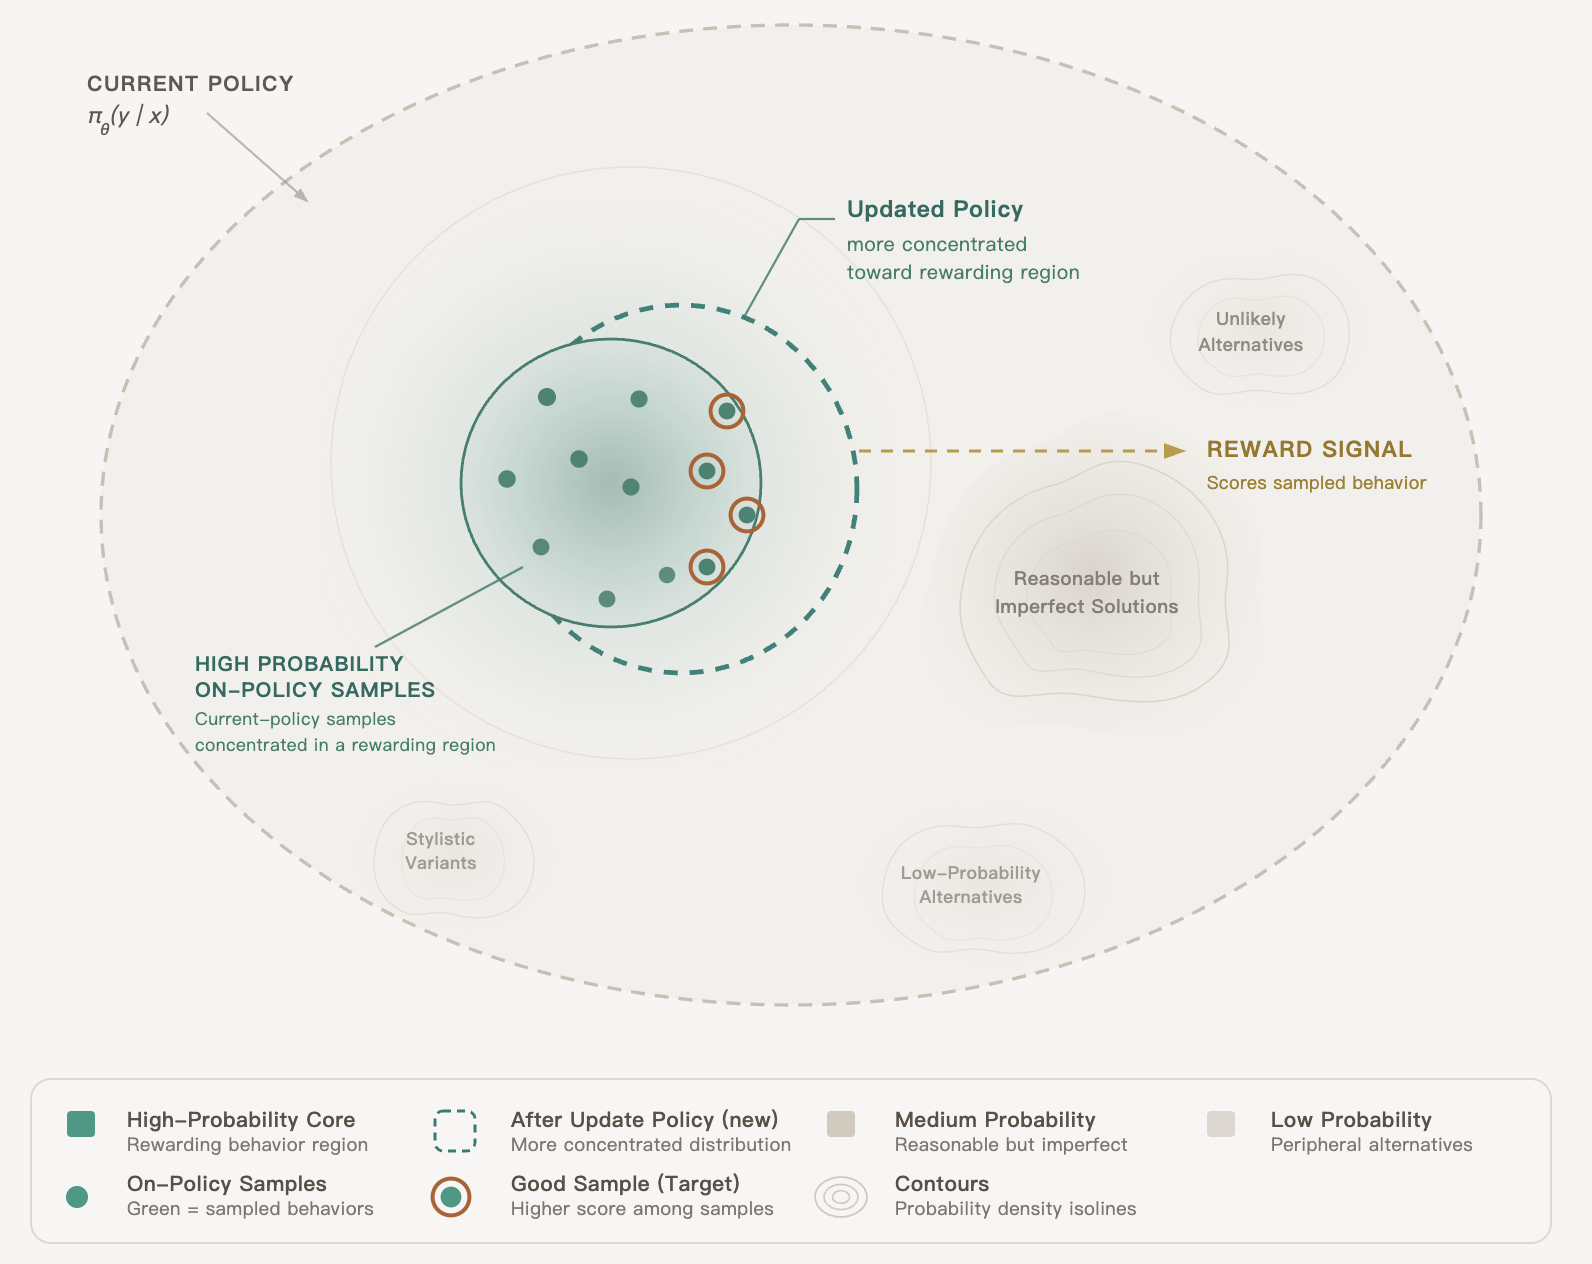
这也正好把系列第一篇的直觉再校准得更清楚一点。GRPO 完整目标里的新旧策略概率比:

确实承担了重要性采样的作用,让我们能够用旧策略采到的 rollout 估计新策略的更新,并配合 clip 控制更新幅度。但真正决定一个 rollout 应该被提高还是压低的,是 Advantage 的正负和大小。在接近 on-policy 的局部更新下,最值得记住的骨架仍然是:
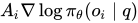
因此,从最大似然的语言来理解:
SFT 是外部样本上的等权最大似然;RL/GRPO 则很像当前策略样本上的 Advantage 加权最大似然。
这里的“很像”很重要。RL 优化的是期望奖励,并不等于在一个固定标注数据集上做普通交叉熵;但二者落到梯度层面,都通过  改变序列概率。这正是统一视角成立的地方。
五、OPD:学生自己出题,老师逐 Token 给方向
策略内蒸馏 OPD 恰好站在 SFT 和 RL 中间。
它像 SFT,因为有一个教师模型提供目标分布;它又像 RL,因为训练时的数据状态不是老师生成的,而是学生从当前策略中自己采样出来的。
设学生为  ,教师为
 。学生先生成自己的前缀
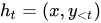 ,然后在学生真正访问到的这些前缀上,让学生的下一个 Token 分布靠近教师(学生policy的logits和教师policy的logits就可以逐token计算KL Divergency):
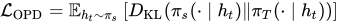
不同 OPD 实现对 KL 方向、采样和裁剪会有不同设计,但最重要的直觉不变:
状态来自学生,方向来自老师。
这比传统“把老师生成的答案存下来,再拿去 SFT”多了一层很关键的闭环。老师不是只在自己熟悉的轨迹上展示正确答案,而是在学生实际犯错、犹豫和偏航的位置上现场指导。
如果说 GRPO 用一个序列级 Advantage 告诉整段 rollout“总体上应该升还是降”,那么 OPD 可以在每个 Token 上提供更稠密的分布信号。这也解释了它为什么有吸引力:它既保留了 on-policy 数据,又比结果奖励提供了更多 credit assignment 信息。
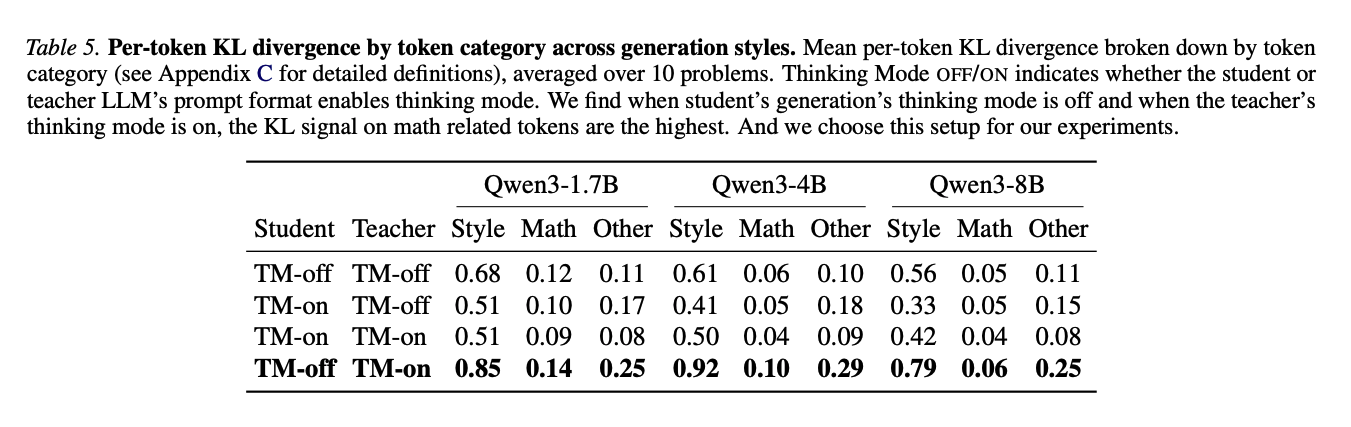
但稠密不代表天然正确。原博客讨论的 On-Policy Self-Distillation(OPSD)实验发现,“wait”“alright”一类风格或转折 Token 的 KL,甚至可能高于真正重要的数学 Token。如果把高 KL 直接当成高价值信号,模型就可能过度学习风格差异,所以仍然需要逐 Token 裁剪等机制。
换句话说:
- RL 的结果奖励往往更接近任务目标,但信号稀疏;
- OPD 的教师 logits 信号非常稠密,但可能混入教师风格和偏差。
一个是“信息少但相对干净”,另一个是“信息多但不一定都重要”。
六、把三种方法摆到同一张表里
| 方法 | 训练状态/样本从哪里来 | 谁提供学习信号 | 最直观的概率解释 |
|---|---|---|---|
| SFT | 外部固定数据集 | 标准答案 Token | 提高示范序列的概率 |
| RL/GRPO | 当前策略的 rollout | Reward / Advantage | 提高正 Advantage rollout,压低负 Advantage rollout |
| OPD | 当前学生策略访问的前缀 | 教师的 Token 分布 | 在学生自己的状态上靠近教师 |
如果一定要写一个统一的示意式,可以写成:
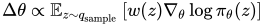
这不是三个算法都能原封不动代入的严格目标函数,而是一张帮助理解的地图:
-
 决定模型在哪里接受训练;
-
 或目标分布决定这些概率往哪个方向移动。
SFT、RL 和 OPD 的亲缘关系,就藏在这两个量里。
七、为什么 RL 往往更不容易遗忘?关键可能不是“RL”三个字
原博客最有意思的观点,是把 RL 不容易遗忘的关键归到 on-policy 数据,而不只是归到 KL 正则、稀疏梯度或某个具体强化学习算法。
1. SFT 可能把模型拉向很远的外部分布
SFT 数据由别人预先写好。无论当前模型会不会这样回答,它都要逐 Token 拟合这套示范。
如果数据风格、任务形式和模型原来的分布相差很远,参数更新就可能非常“横”:为了复现外部答案,顺便改变大量原有行为。交叉熵本身不会自动区分“任务真正需要的 Token”和“数据集作者碰巧喜欢的表达”。
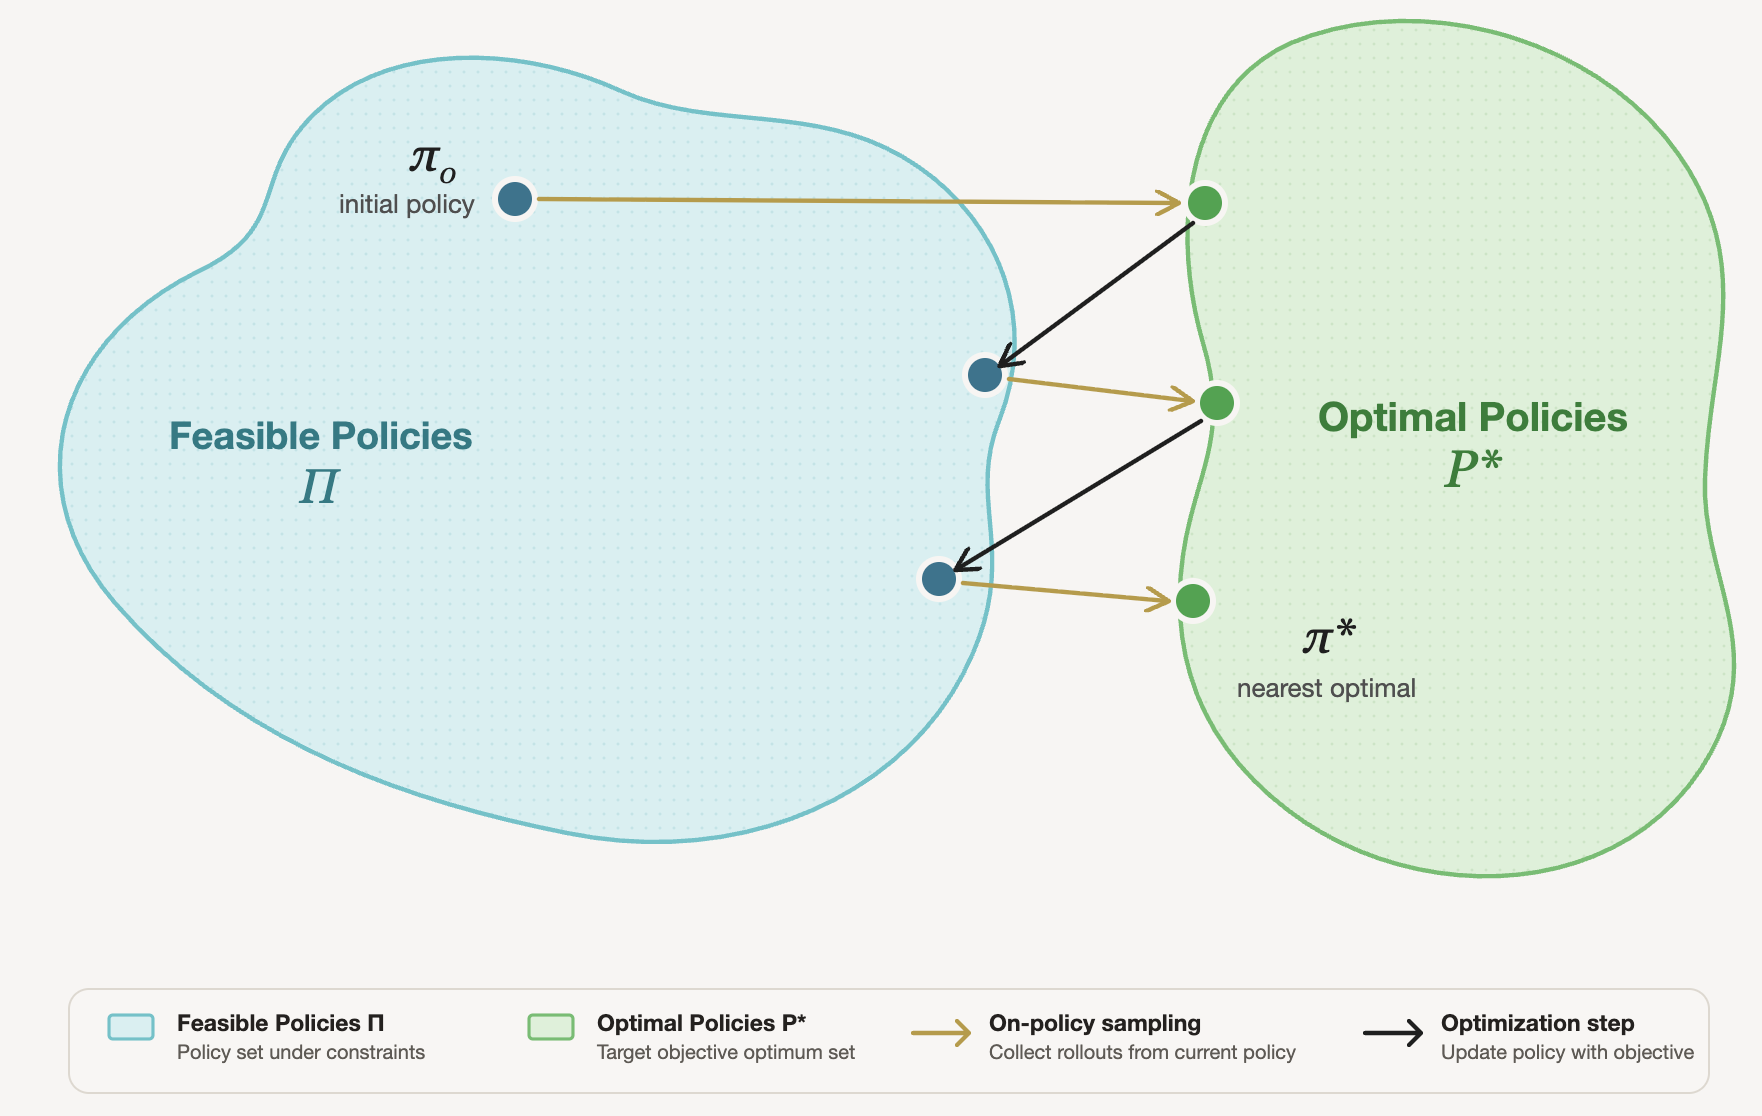
2. RL 主要在模型当前能访问的区域里更新
RL 的 rollout 来自当前策略。模型压根到不了的状态,不会凭空进入这一步训练;模型已经经常访问的区域,才会根据奖励重新分配概率。
这让 RL 的更新带有一种局部性:不是把模型硬拽到任意一个外部分布,而是从它现在会做的事情出发,寻找奖励更高的邻近行为。
如果能完成任务的最优策略不止一个,on-policy 训练往往更容易走向其中离当前策略较近、当前模型可达的那个。原博客把它概括为:学习离当前模型最近的 task-solving policy。
3. OPD 也继承了这种局部性
OPD 的教师虽然是外部的,但教师给建议的位置由学生决定。学生走到哪里,教师就在哪里纠正。于是,教师负责方向,学生自己的状态分布负责限制更新发生在哪里。
这也解释了一个看似反直觉的现象:即使教师本身因为 SFT 发生了一些遗忘,使用这个教师做 OPD 的学生,也不一定会把教师的遗忘完整复制过来。
不过这里一定要加一句边界条件:这是一种非常有用的 mental model,不是“用了 on-policy 就绝不遗忘”的数学定理。
- 神经网络参数是共享的,局部状态上的梯度仍可能影响其他能力;
- 当前策略如果从不访问正确行为,on-policy 也可能原地踏步;
- Reward 或教师信号如果有偏,模型仍可能 reward hacking 或学错方向;
- 更新过猛时,RL 和 OPD 同样可能分布坍缩。
所以更准确的说法是:on-policy 数据给训练加入了一种隐式的邻近约束,让它通常比任意外部数据的直接拉动更温和,而不是提供绝对保证。
八、博客里最有说服力的实验:数据来源可能比教师更重要
原作者设计了一个“最小代码编辑”任务:给模型一段有 bug 的函数,要求只修 bug,不要重写其他部分。这个任务同时测试两件事:模型有没有学会最小修改,以及训练后通用代码能力有没有发生遗忘。
作者先分别训练了 SFT 教师和 RL 教师,再让同一个起点的学生分别向两个教师做 OPD。结果如下:
| 模型 | Pass@1 ↑ | Norm. Levenshtein ↓ | Added CC ↓ | LiveCodeBench v6 ↑ |
|---|---|---|---|---|
| SFT 教师 | 0.775 | 0.450 | 0.450 | 0.286 |
| RL 教师 | 0.792 | 0.063 | 0.206 | 0.320 |
| OPD / SFT 教师 | 0.800 | 0.059 | 0.206 | 0.297 |
| OPD / RL 教师 | 0.787 | 0.055 | 0.228 | 0.314 |
Levenshtein Distance 即编辑距离:把一段代码变成另一段代码,至少需要多少次插入、删除或替换。↓表示这个指标越低越好。
这里的 CC 不是 Cyclomatic Complexity,而是 Cognitive Complexity,认知复杂度,衡量代码对人来说有多难理解。
LiveCodeBench v6 是独立的通用代码生成基准,主要用程序测试用例评估模型解决编程题的能力。这里用来测试为了让模型学会最小修改,我们有没有把它原来的通用编程能力训坏?
这里最值得看的不是某一列的零点零几,而是整体结构:
Pass@1 看修没修对,Levenshtein 看有没有乱改,Added CC 看有没有改复杂,LiveCodeBench 看有没有为了新能力忘掉旧能力。
原作者的理想模型是四项同时满足:修得对、改得少、不添复杂度、原有编程能力不下降。
- 两个 OPD 学生的结果非常接近,教师是 SFT 还是 RL,并没有造成想象中那么大的差距;
- SFT 教师在通用代码能力上退化更明显(LiveCodeBench),但由它指导的 OPD 学生只表现出轻微遗忘;
- 两个 OPD 学生在“最小修改”行为上都远比 SFT 教师更好,并接近 RL 教师。
如果“教师分布决定一切”,那么 SFT 教师的学生应该继承更多 SFT 教师的遗忘,但实验没有出现这个结果。一个自然解释是:教师告诉学生往哪走,但学生自己的 on-policy 数据决定了从哪里出发、在哪些地方接受纠正。后者可能比我们以前想象得更重要。
这个结果也给工程实践一个很有意思的启发:我们也许可以先用比较激进的方法训练一个专长很强的专家,再通过 OPD 把能力传给基础模型,同时尽量保住基础模型原来的能力。老师可以“偏科”,学生不一定要把老师的副作用一起继承。这也是目前OPD为什么流行的最大原因。
九、为什么最近大家开始重视 OPD?
大模型后训练正在逐渐从一条简单的“预训练 → SFT → RL”流水线,变成更像:
这里每一步解决的问题不同:
- SFT 负责冷启动、指令遵循和格式;
- RL 在数学、代码等可验证任务上寻找高奖励行为;RL 专家通过可验证奖励不断探索:例如分别训练数学 RL 专家;代码 RL 专家;Agent RL 专家。这些专家可能已经偏科,甚至牺牲了一部分通用能力,但在各自领域形成了比基础模型更强的策略。
- OPD 用稠密的教师信号,把专家能力迁回最终模型或合并多个专家。OPD 在这里更像“能力合并与收尾”,而不是能力探索。这样最终模型自己不一定需要经历每一种激进的 RL 更新,而是在自己的 on-policy 状态上接受不同专家指导,尽量同时保留通用能力。
原博客提到,近期一些模型已经把 OPD 放到后训练的最后阶段。这个趋势背后的直觉并不神秘:RL 擅长“探索出能力”,OPD 擅长“在学生自己的分布上把能力教回来”。
但 OPD 也不是银弹。数学和代码有可验证奖励,RL 的信号通常更可靠;创作和知识类任务很难写出低偏差 Reward,教师蒸馏反而可能更实用。真正理想的方法,大概需要同时拥有:
- 蒸馏那样稠密的 Token 级信号;
- RLVR 那样尽量贴近真实任务目标的低偏差信号;
- RL 和 OPD 共有的 on-policy 数据。
这也是原博客最后留下的问题:我们已经更清楚理想算法应该具备什么形状,但具体应该长什么样,还没有标准答案。
十、回到 GRPO:我们最开始抓住的其实就是“分布重塑”
现在再回看这个系列第一篇,GRPO 的核心直觉其实没有变,只是可以说得更精确:
- 模型不是在记住一个答案,而是在维护一个回答分布;
- rollout 来自模型自己,因此更新发生在当前策略能访问的区域;
- Advantage 是有正有负的样本权重,决定哪些回答提高概率、哪些回答降低概率;
- 新旧策略概率比负责把旧策略样本校正到新策略的优化中,clip 等机制负责限制步幅;
- 整个训练最终仍通过 搬运概率质量。
因此,对于有深度学习背景、但没有传统强化学习背景的人,完全可以先从下面这条线理解大模型 RL:
交叉熵最小化 = 最大似然;
SFT = 外部数据上的等权最大似然;
GRPO = 当前 rollout 上的 Advantage 加权 log-likelihood 更新;
OPD = 当前学生状态上的教师分布匹配。
它们不是完全相同的优化目标,却共享“改变概率分布”这副骨架。
SFT 决定模仿谁,RL 决定奖励谁,OPD 决定让谁在自己的路上听老师指点。用深度学习、概率和信息论的语言把它们放到一起以后,所谓大模型强化学习就没有那么玄学了。
它仍然是在训练一个概率模型。
只不过这一次,数据由模型自己产生,权重由 Advantage 决定,学习发生在模型真正走过的地方。