
- LeaderBoard: TB-MathModel Leaderboard
- Github: https://github.com/wxj630/terminal-bench-math-modeling
由于agent时代token花费如流水,快速且性能不俗的Flash模型隐隐有成为agent主力的趋势! 接下来我们测评下国模三大Flash模型,
- 当红炸子鸡“牛来”的GLM-5.3-Flash(刚想测评那天ox-alpha限免结束了只能自掏腰包测评),
- 号称下一代架构的Qwen-3.8-Flash,
- 对上老牌性价比之王Deepseek-V4-Falsh-0731!还
- 有在我们TB-MathModel评测上令人惊喜的本地部署之王Qwen-3.8-27B!
当然,这里的评测主要是数学建模和计算代码求解领域;这份榜单主要用于自己测试和观察各大模型的性价比,方便后续挑选使用,不能代表各家模型的综合能力。若还有其他模型想一起测,也欢迎私信补充测评对象。
每个任务我们给足4个小时的agent执行时间。
一、省流版
如果只看 TB-MathModel 这 18 道题,三家 Flash 的结论其实很清楚:
- DeepSeek-v4-Flash-0731 最稳,O-Eval 最高,成本也最低。
- GLM-5.3-Flash 最会追分,Robust BO-Eval 最高,说明它在 baseline 弱项上追回得更猛。
- Qwen3.8-Flash(百炼)这轮最吃亏,总分最低,成本最高,而且还有两个最终超时失败。
一句话说完就是:
如果只选一个主力,先选 DeepSeek-v4-Flash;如果更想看谁会在弱项上狠狠干一把,GLM-5.3-Flash 更有故事;Qwen3.8-Flash 这轮不太适合当主力。
我觉得可能某种意义上Qwen3.8-Flash总参数量最少、激活参数量也最少可能拖累了他的性能:
- DeepSeek-V4-Flash:284B 总参数,13B 激活参数。(huggingface.co)
- GLM-5.3-Flash:320B 总参数,18B 激活参数。(docs.z.ai)
- Qwen3.8-Flash-Next:125B 主模型参数,外加 51B n-gram embedding;每 token 激活 6B。如果把 embedding 也算进总量,可以记成约 176B / 6B。(huggingface.co)
我们到底怎么比
TB-MathModel 不是在比谁会写一篇看起来最像论文的报告,而是在比:给完整赛题、附件、终端环境之后,模型最后能不能把关键数值真的做出来。
所以我们用了两把尺子:
O-Eval = direction-aware raw / O raw它看的是绝对能力,回答的是“离优秀论文复现答案有多近”。
Robust BO-Eval 则看相对 v4 flash baseline 的稳健增益:
-
O raw - flash raw >= 0.10时,用追回比例,但截到[-100%, +100%] - 分母太小的时候,不再硬算比例,改成 clipped B-Eval,也就是把
model raw - flash raw截到[-10pp, +10pp] - trial 最后没有产出可评分结果时,直接记
-100%
所以这两个指标本来就不是一回事:
- O-Eval 看的是绝对分
- Robust BO-Eval 看的是相对追赶
v4 flash 在这里是基线,不参与追赶,所以它的 Robust 值天然是 0。
三家 Flash 的成绩单
| 模型 | Artifacts | O-Eval | Robust BO-Eval | tokens input/cache/output | 估算成本 | 结果状态 |
|---|---|---|---|---|---|---|
| DeepSeek-v4-Flash-0731 | 18⁄18 | 71.98% | 0.00% | 28,690,539 / 27,294,080 / 1,368,452 | ¥5.21 | baseline |
| GLM-5.3-Flash | 18⁄18 | 65.59% | 9.48% | 107,726,029 / 101,466,688 / 3,683,366 | ¥19.62 | 17 valid + 1 timeout |
| Qwen3.8-Flash(百炼) | 18⁄18 | 56.49% | -5.50% | 299,616,972 / 293,563,264 / 6,814,374 | ¥59.34 | 16 valid + 2 timeout |
这个表一眼就能看出来三件事:
- DeepSeek-v4-Flash 最划算
- GLM-5.3-Flash 更会追 baseline
- Qwen3.8-Flash 最费 token,也最不稳
二、三个Flash模型主要表现
1. DeepSeek-v4-Flash-0731
这轮里它是最像“默认主力”的那个。
它的 O-Eval 最高,说明它和优秀论文复现答案的贴合度最好;同时它的成本也是最低的。对于 agent 场景来说,这一点很关键,因为真正烧钱的不是一次回答,而是读题、写代码、跑求解器、调参、重试、补结果的一整串动作。
能在最便宜的前提下把绝对分做到最高,这个模型就很适合做首选基线。
2. GLM-5.3-Flash
GLM-5.3-Flash 的故事更像“追分型选手”。
它的 O-Eval 比 DeepSeek-v4-Flash 低一点,但 Robust BO-Eval 反而更高,说明它在一些 baseline 弱项上追得更猛。换句话说,它不是最贴近 O 的那个,但它更擅长在某些题上把 flash baseline 甩开。
这就是为什么它在 Robust 图里会显得特别亮眼。
如果关心的是“相对便宜 baseline 到底能不能被狠狠干掉”,GLM-5.3-Flash 很值得看; 但如果关心的是“谁最接近 O 奖答案”,它就不是第一。
3. Qwen3.8-Flash(百炼)
Qwen3.8-Flash 这轮最大的问题不是“没跑完”,而是“跑完了也不够稳”。
它确实覆盖了 18 题,但只有 16 个有效完成,另外 2 个是最终超时失败。更关键的是,它在 MCM 上明显弱一些,Robust 还是负的。
再加上它的 token footprint 很大,输入、缓存、输出三项都重,所以最后就会显得特别贵。
所以这轮给人的直观感受就是:
花得最多,分却不是最漂亮。
为什么 O-Eval 和 Robust 会“看起来打架”
它们本来就是两把不同的尺子。
O-Eval 问的是:你离优秀论文复现答案有多近?
Robust BO-Eval 问的是:你比便宜 baseline 多追回了多少?
所以很自然会出现这种情况:
- 有些模型绝对分更高,但相对追赶没那么猛
- 有些模型在 baseline 弱项上追得很凶,但绝对贴合度还是不如另一个模型
这不是矛盾,是互补。
论文主榜应以 O-Eval 为主; 分析图则更适合保留 Robust,用来解释“为什么某些模型在某些题上特别会追分”。
最后怎么选
如果只给一句最实用的建议:
- 默认主力:DeepSeek-v4-Flash-0731
- 看相对追分能力:GLM-5.3-Flash
- 这轮不建议作为主力:Qwen3.8-Flash(百炼)
下一篇将把这三家在 18 题里的具体题目、轨迹和可行解拆开讲,看看它们到底是在哪些题上赢、在哪些题上翻车。
不过这件事也不用等下一篇了,既然大家最关心的是“到底哪几题赢、哪几题翻车”,我们就直接在这篇拆完。
三、结果可视化
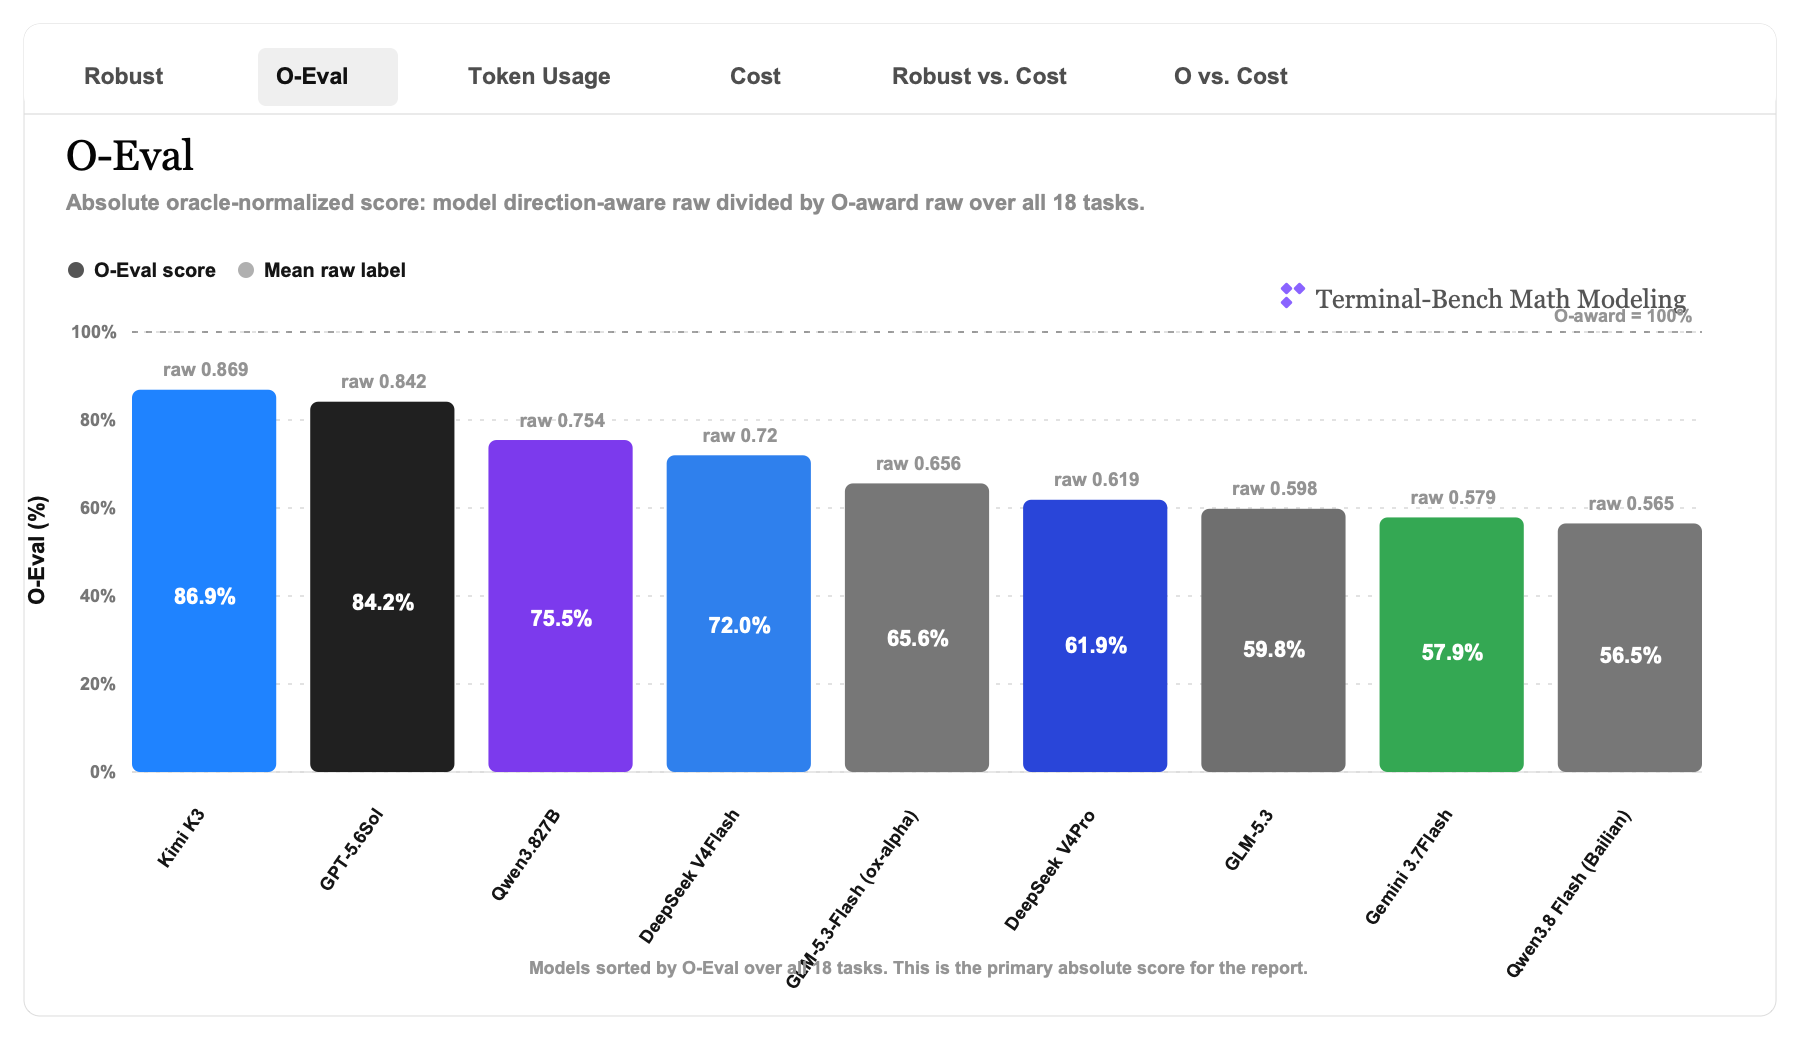
先放主指标。这里的 O-Eval 是这篇文章最建议看的主榜:它把每个模型的结果和 O 奖复现答案对齐,问的是“平均离人类优秀解有多近”。这张图最直接的结论是,Qwen3.8-27B-FP8 thinking 把总分抬到最高;如果只看 Flash,则 DeepSeek-v4-Flash 最强,GLM-5.3-Flash 次之,Qwen3.8-Flash 最弱。也就是说,这一轮的绝对效果上限和性价比主力并不是同一个模型。
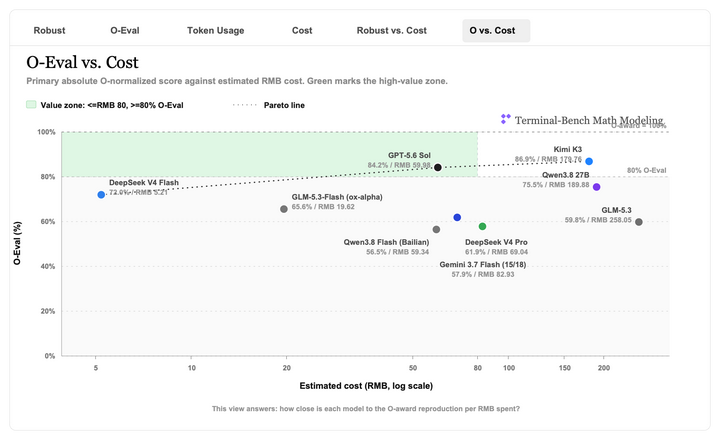
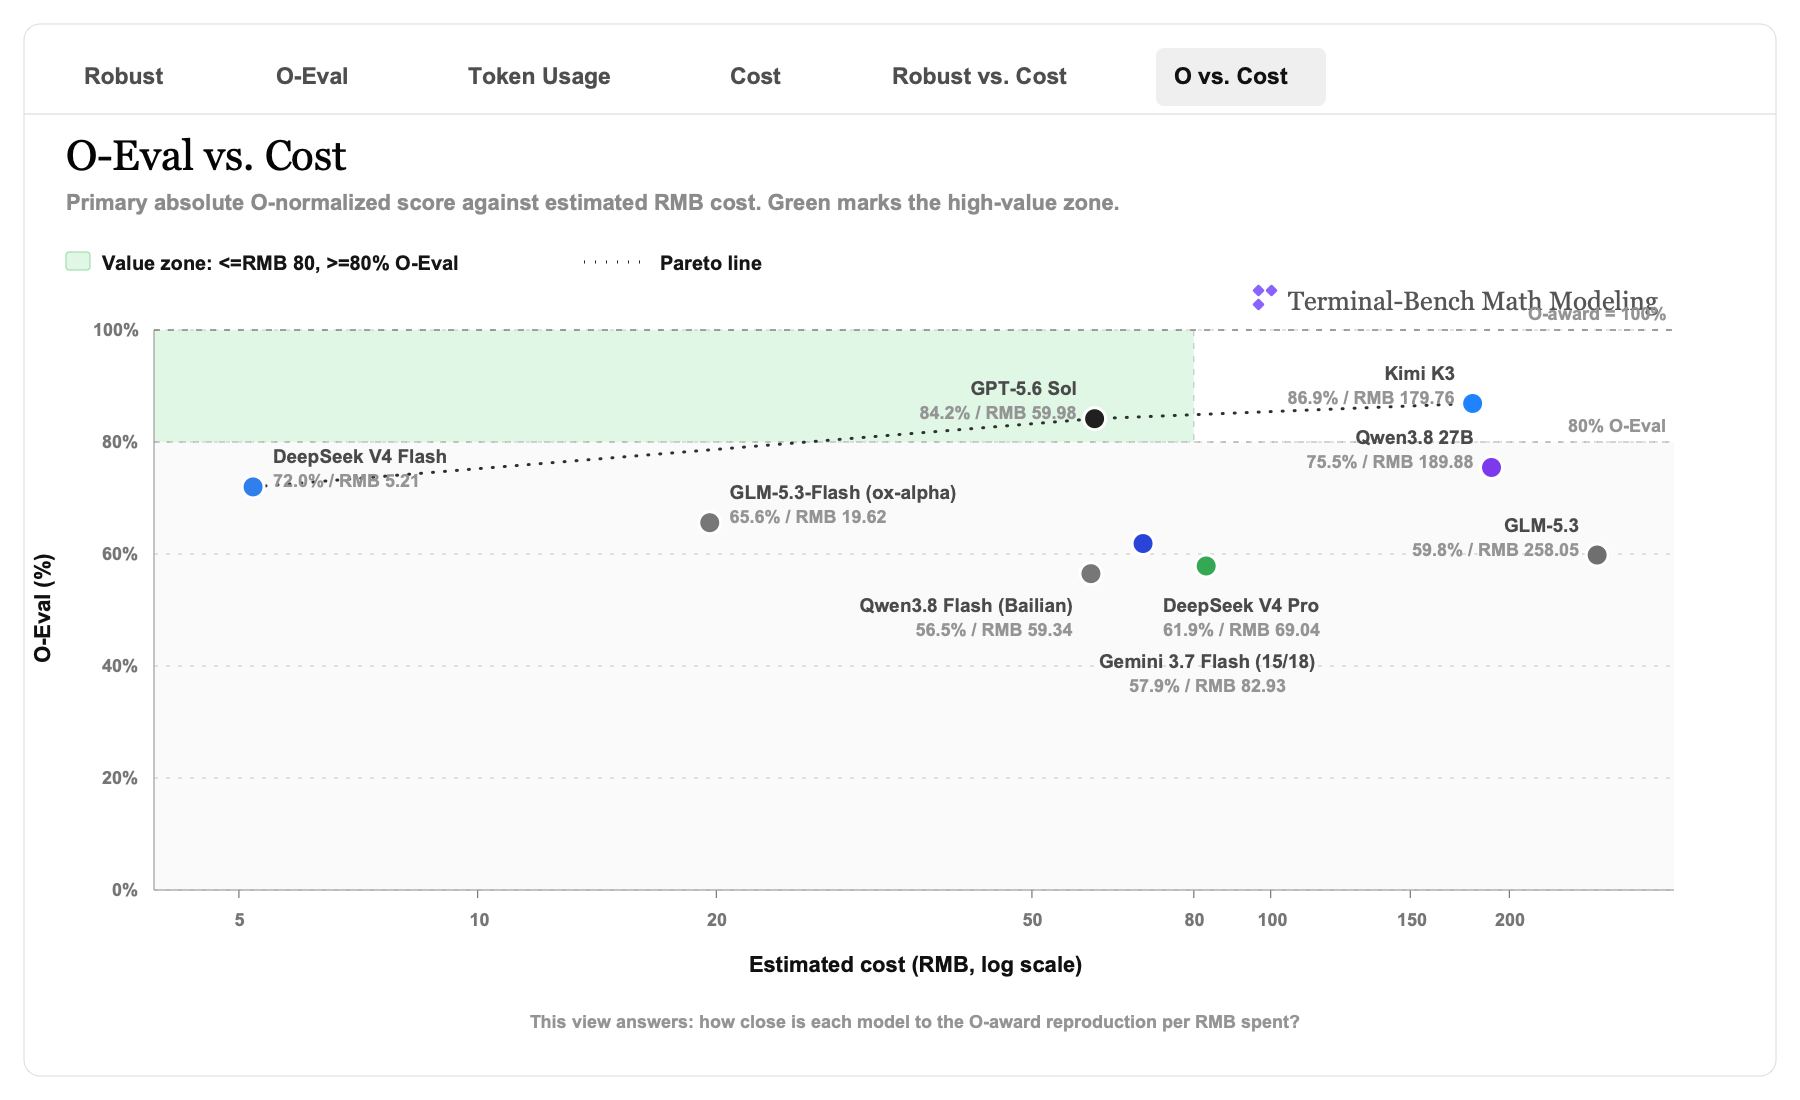
再看 O-Eval 和成本。横轴是估算人民币成本,纵轴是 O-Eval,越靠左上越好。这个图最有意义的地方,不是单看谁分更高,而是直接告诉读者“谁更值”:DeepSeek-v4-Flash 同时把高分和低成本都做到了,落在最理想的左上角;GLM-5.3-Flash 的分数不差,但成本明显更高;Qwen3.8-Flash 又贵又低分,性价比最差;Qwen3.8-27B-FP8 thinking 则把分数继续往上抬了一档,但代价是成本也大幅上升,所以它更像效果上限,不像便宜主力。
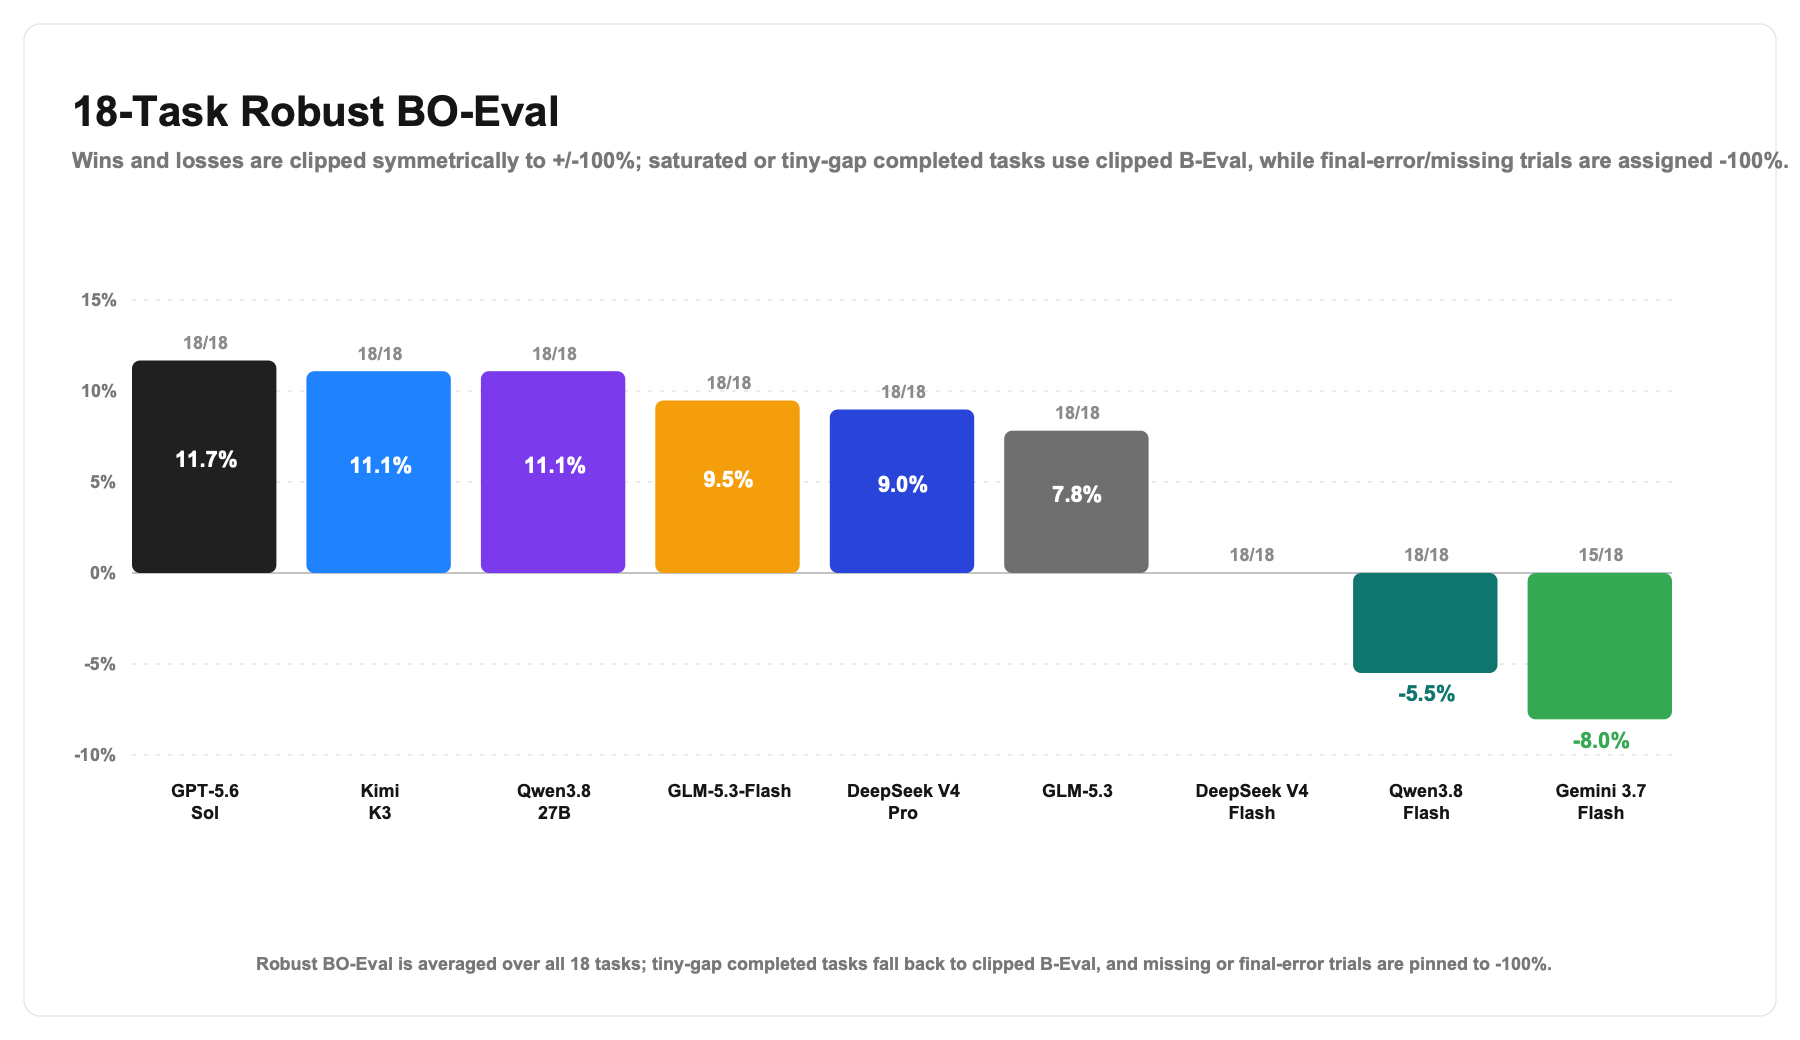
然后是 Robust BO-Eval。它不是主榜,而是辅助图:它回答的是“相对 DeepSeek-v4-Flash baseline,这个模型在 baseline 弱的地方多追回了多少”。这张图最有用的地方,是把“追分型模型”和“绝对分高但不一定最会追分的模型”分开:GLM-5.3-Flash 和 Qwen3.8-27B-FP8 thinking 都属于追分能力比较强的一档,而 Qwen3.8-Flash 则整体偏负,说明它没有把 baseline 的优势真正转化成更强的可验证结果。
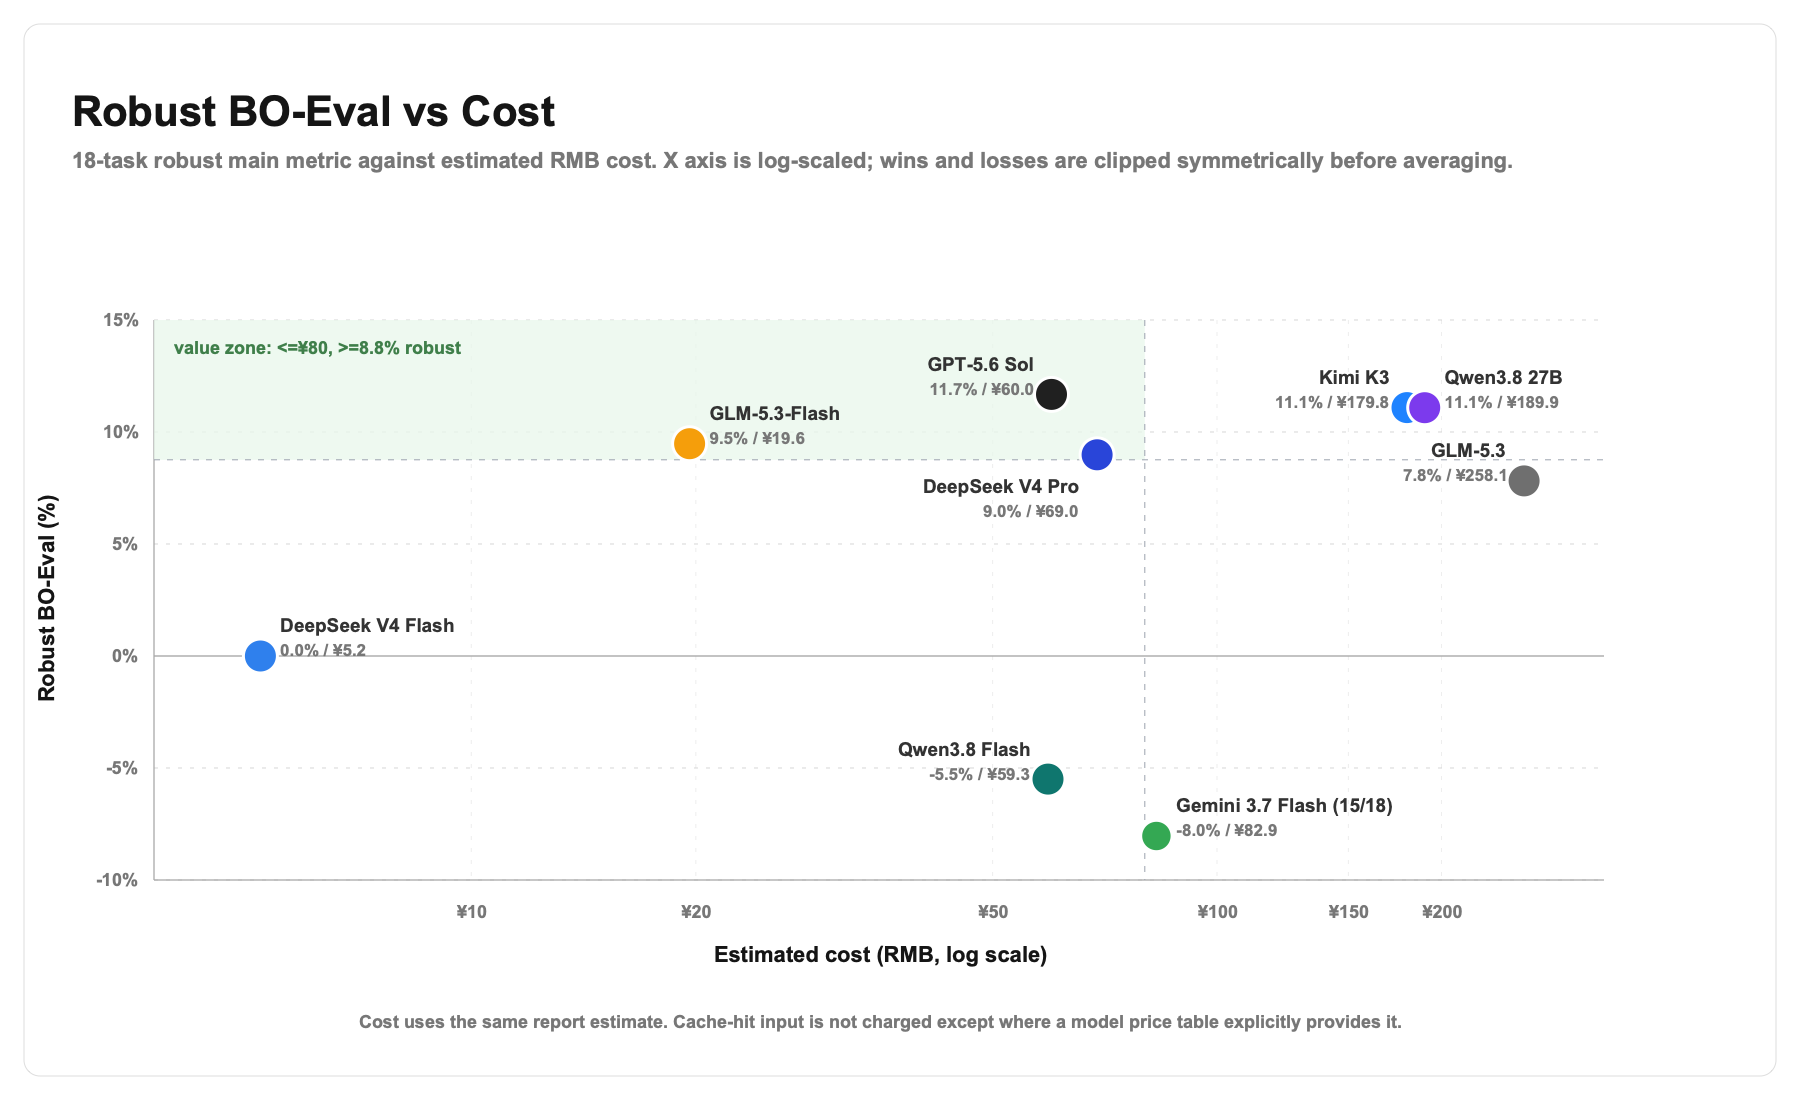
把 Robust 和成本放在一起后,图就进一步说明了“追分值不值钱”:GLM-5.3-Flash 在 Flash 里是最亮眼的追分型选手,Qwen3.8-27B-FP8 thinking 则把追分上限继续往上抬,但代价更高;Qwen3.8-Flash 既没有便宜多少,也没有换来同等强度的追分回报。
再把年份、赛制、token、成本也放出来。这里不再放 Raw effect,也不再汇报 BO-only,因为绝对 raw 没有跨题可比性,BO-only 又太容易被小分母离群点带偏。
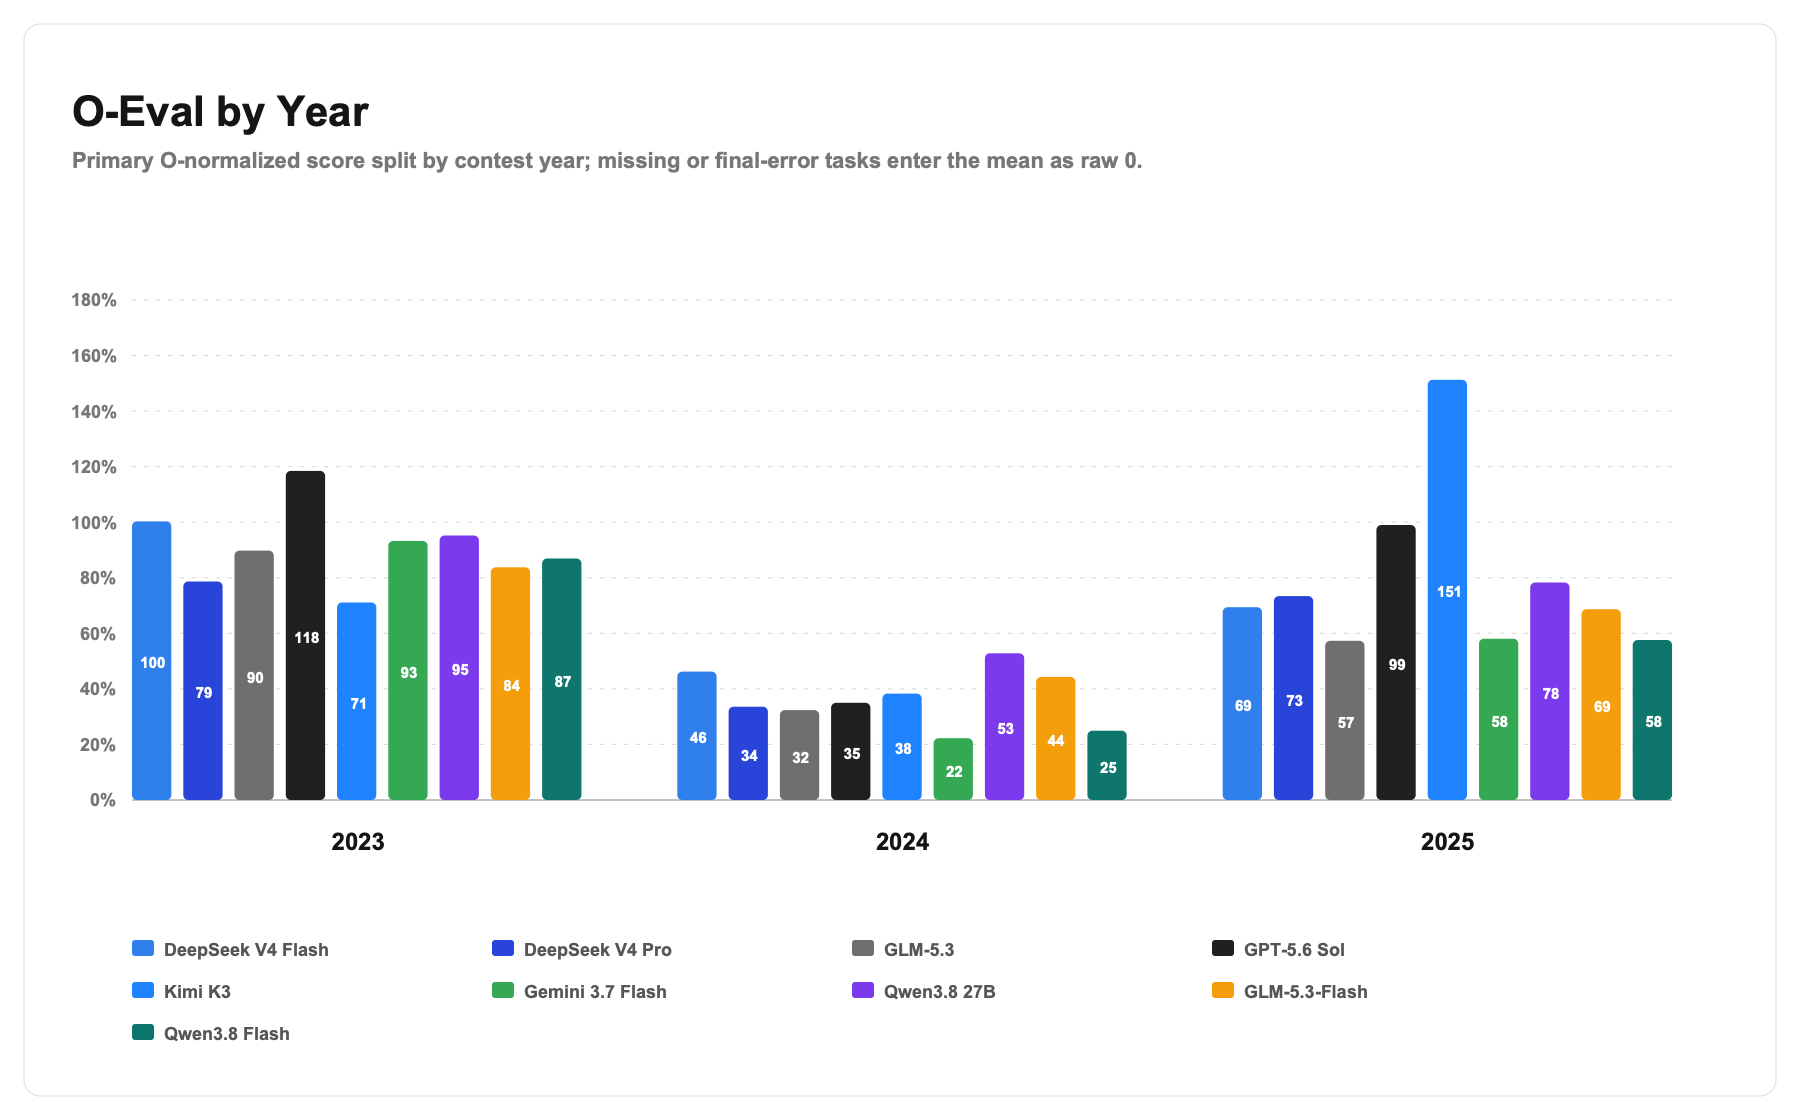
年份拆分告诉读者,模型波动很大一部分来自题目年份而不是模型名称本身。最明显的是 2024:几乎所有模型在 2024 都明显低于 2023 和 2025,说明这一年题目对长程建模、约束处理和可执行求解更不友好。三家 Flash 里,DeepSeek-v4-Flash 在 2023 领先、2025 和 GLM-5.3-Flash 很接近;GLM-5.3-Flash 在 2024 没有被明显甩开,但整体 O-Eval 仍低于 DeepSeek;Qwen3.8-Flash 则在 2024 掉得最明显。Qwen3.8-27B-FP8 thinking 的作用更像“大模型上限参照”:它在 2024 仍能拿到这组里最高的 52.82%,但没有把所有年份都碾开
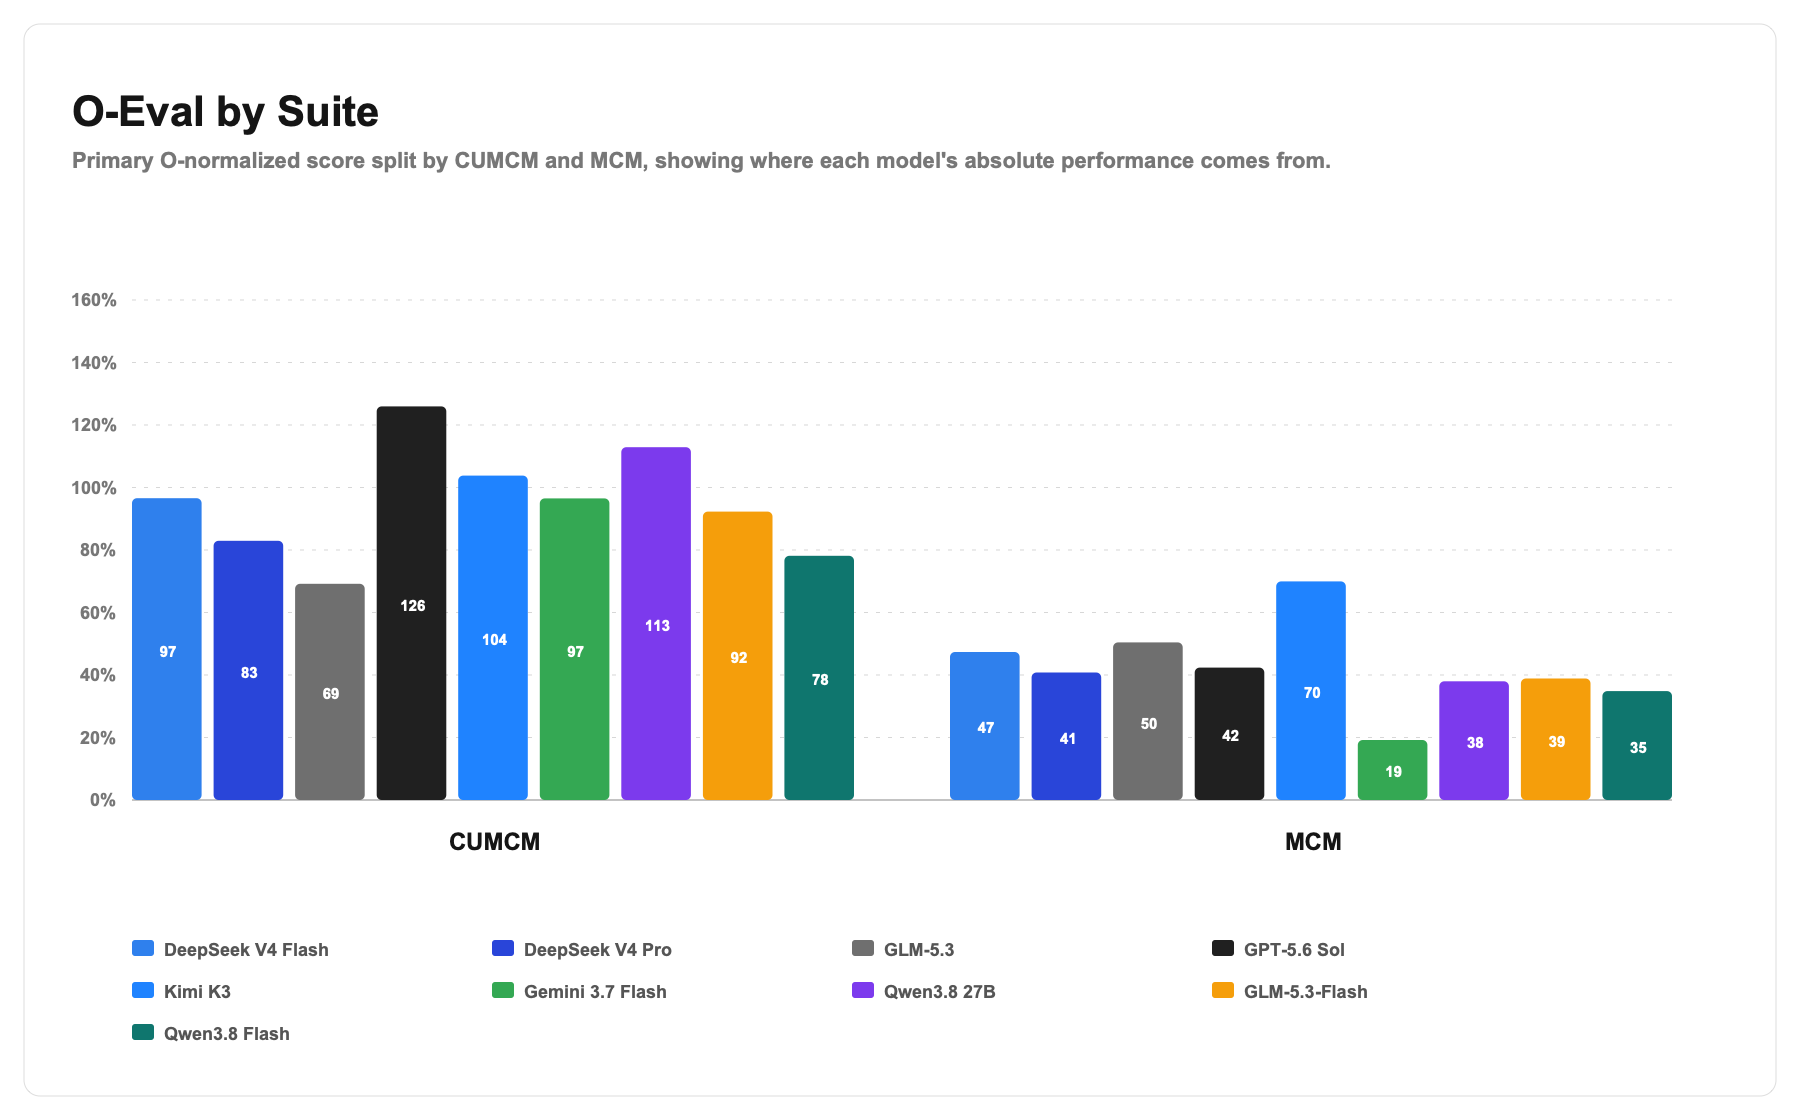
赛制拆分更直接:CUMCM 整体比 MCM 更适合这批模型,几乎所有模型在 CUMCM 上都明显高于 MCM。DeepSeek-v4-Flash 是 96.59% vs 47.38%,GLM-5.3-Flash 是 92.30% vs 38.88%,Qwen3.8-Flash 是 78.14% vs 34.84%;Qwen3.8-27B-FP8 thinking 的差距更大,CUMCM 到 112.91%,MCM 只有 37.98%。这说明 TB-MathModel 不是只在测“会不会写代码”,MCM 题里更强的开放假设、英文题面理解、长报告组织和软约束权衡,会把模型真实短板暴露出来。可能是因为这几个模型都是国模所以更擅长国赛吧hhhh
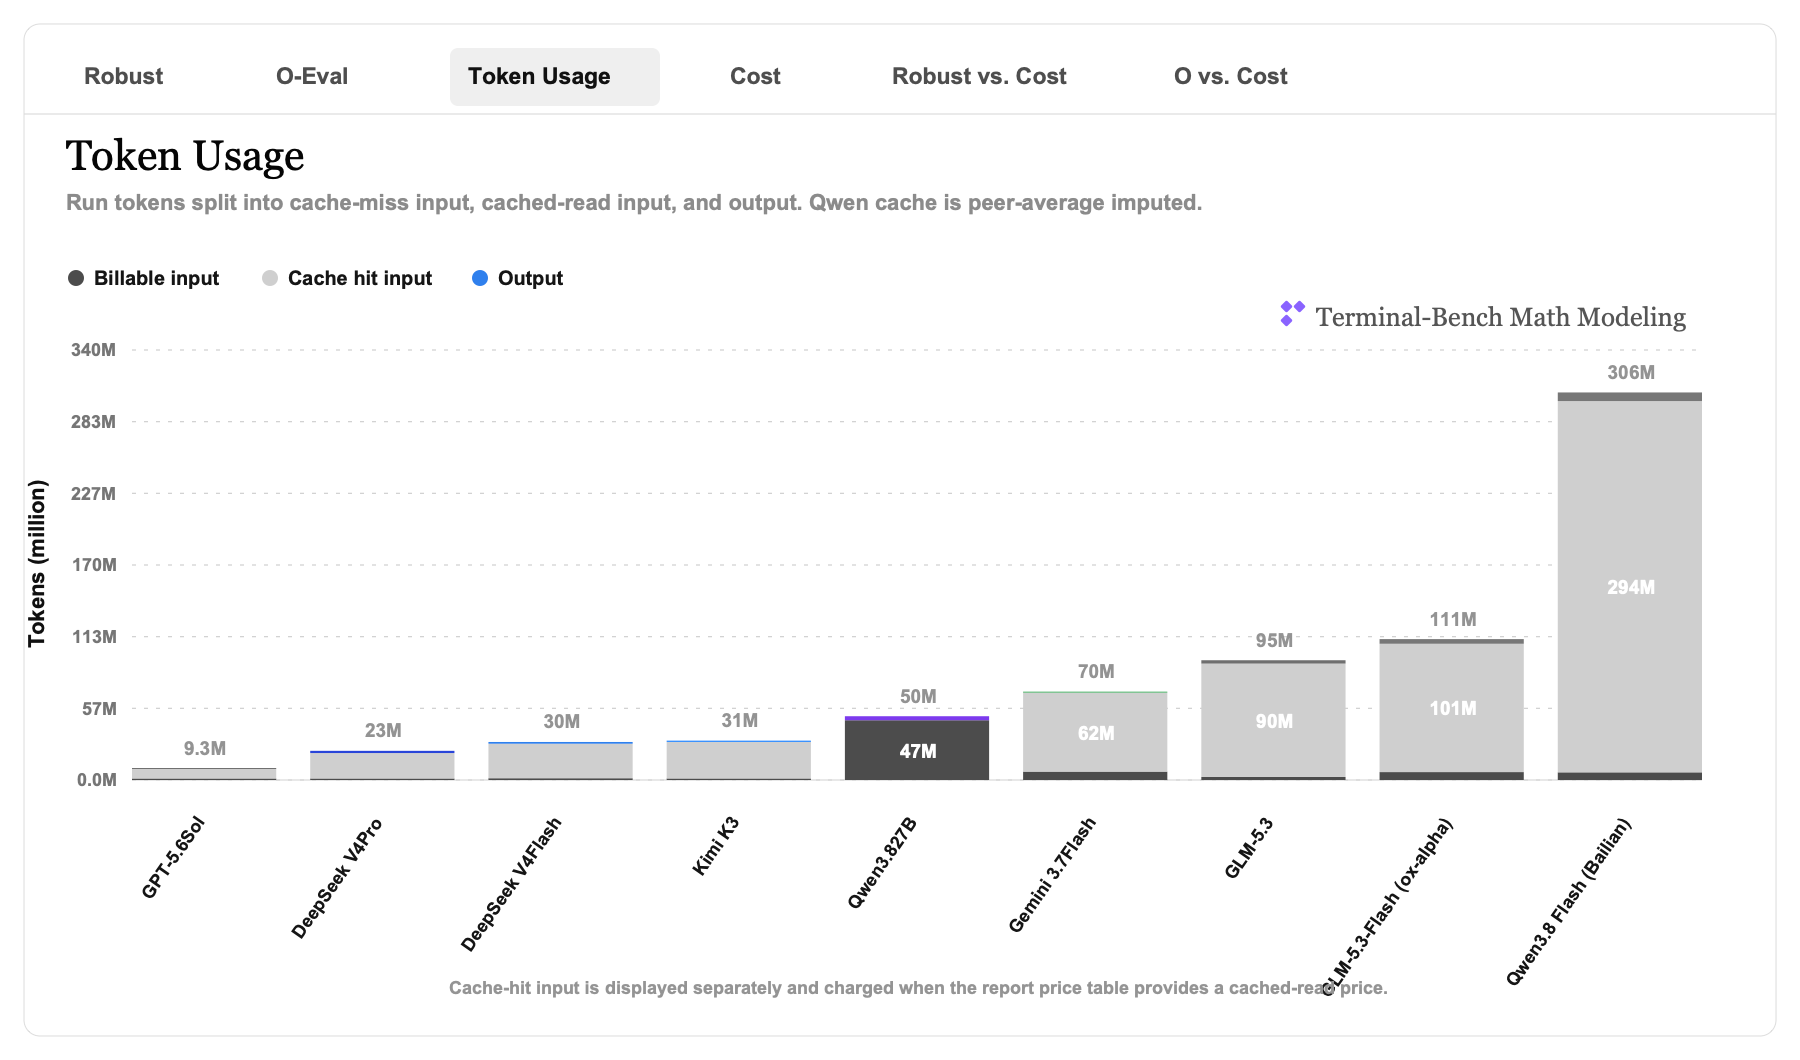
Token 图说明,“说得多”不等于“做得好”。Qwen3.8-Flash 的 token footprint 最大,却没有把这些 token 转成更高主分;Qwen3.8-27B-FP8 thinking 的 token 数不算最高,但由于单价更高,所以最终仍然很贵。
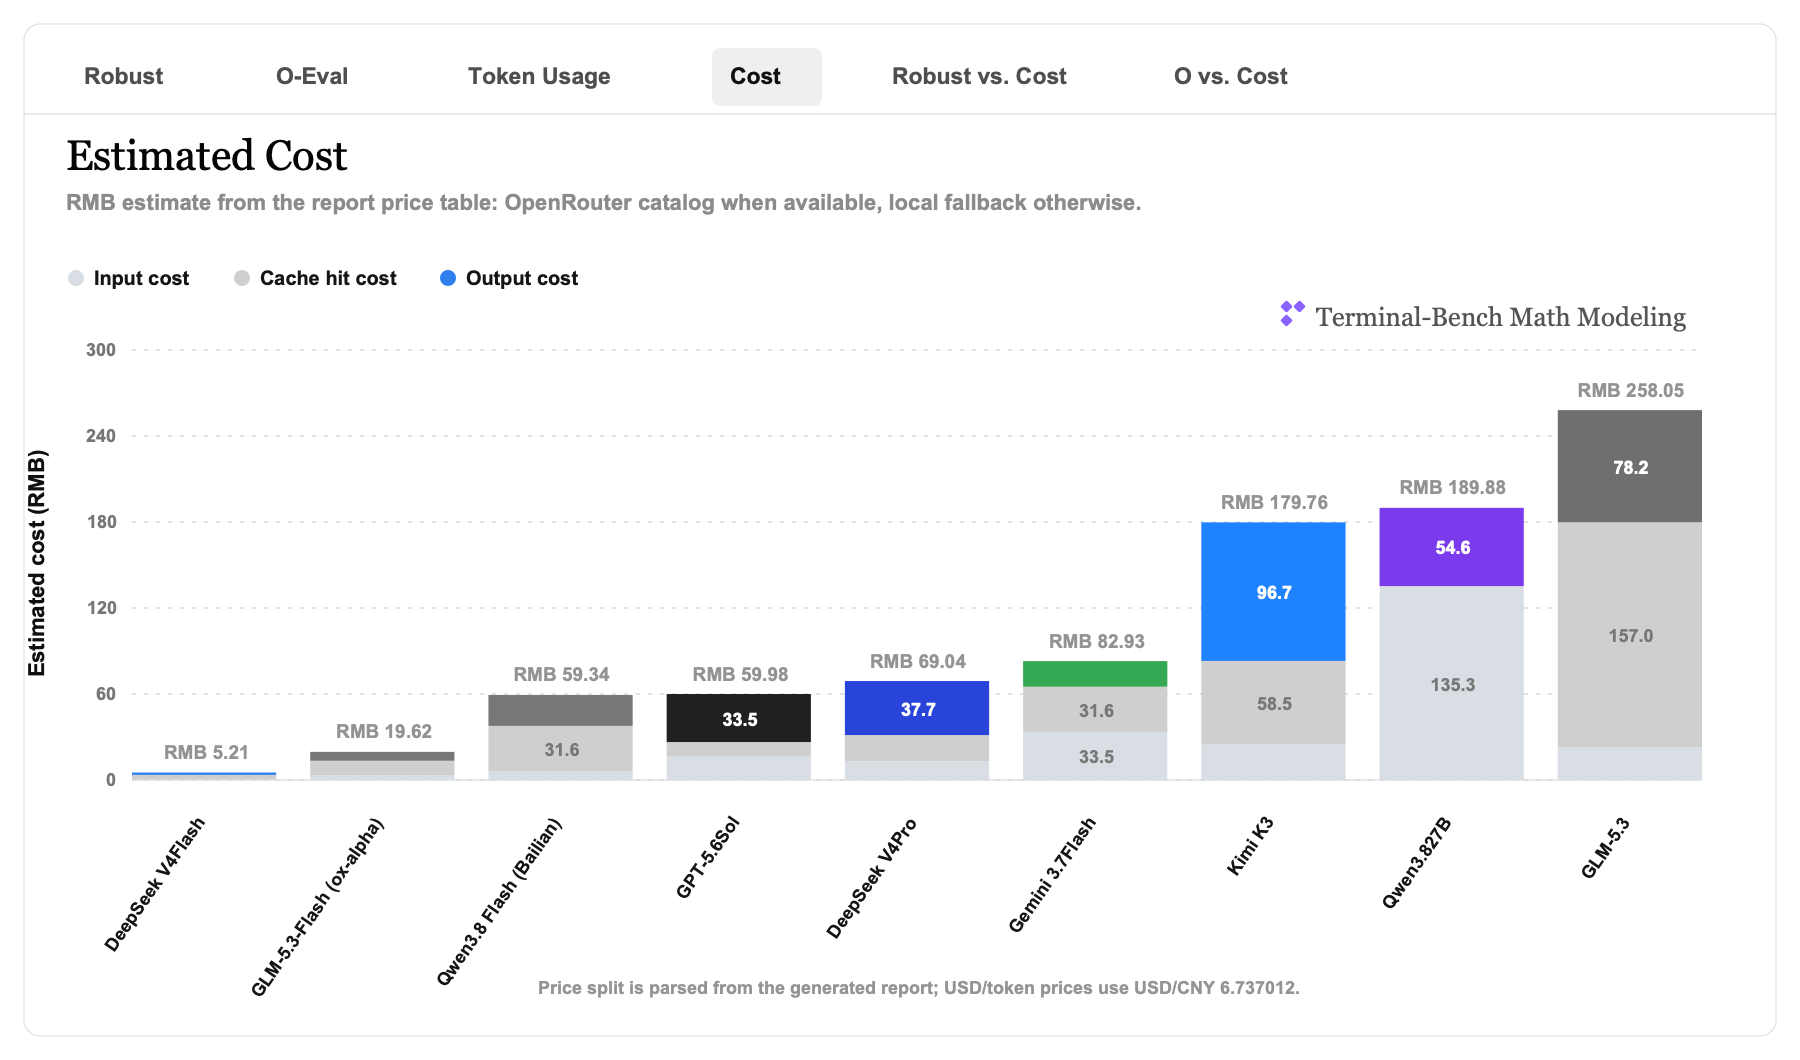
成本图把上面的 token 差异直接翻成真金白银:DeepSeek-v4-Flash 仍然最省,GLM-5.3-Flash 和 Qwen3.8-Flash 明显更贵,而 Qwen3.8-27B-FP8 thinking 虽然 token 不算最多,却因为单位价格更高,最终花费最高。
四、三家 Flash 逐题总表
下面这张表只看三家 Flash:DeepSeek-v4-Flash-0731、GLM-5.3-Flash、Qwen3.8-Flash。每个单元格写成:
O-Eval / Robust BO-Eval其中 O-Eval 是主分,Robust BO-Eval 是辅分。失败、超时、没有可评分 artifact 的题,O-Eval 按 0 进平均,Robust BO-Eval 按 -100% 进平均。
| 题目 | DeepSeek-v4-Flash | GLM-5.3-Flash | Qwen3.8-Flash | 一句话读法 |
|---|---|---|---|---|
| CUMCM 2023 A 太阳镜场 | 96.70% / 0.00% | 0.00% / -100.00% | 145.59% / 10.00% | Qwen Flash 数值最高,GLM 本题超时失败;但这题 O 和 baseline 很近,所以 Robust 只给 Qwen 封顶 10%。 |
| CUMCM 2023 B 多波束测线 | 134.51% / 0.00% | 150.06% / 10.00% | 154.27% / 10.00% | 三家都超过 O 锚点,Qwen Flash 略高;Robust 用小分母截断,避免爆表。 |
| CUMCM 2023 C 蔬菜定价 | 213.50% / 0.00% | 170.76% / -10.00% | 175.50% / -10.00% | DeepSeek baseline 本来就很高,GLM/Qwen 绝对分也高,但相对 baseline 是退步。 |
| CUMCM 2024 A 舞龙路径 | 0.00% / 0.00% | 20.35% / 20.35% | 20.35% / 20.35% | DeepSeek 没拿到可用分,GLM/Qwen 都做出了一部分几何/运动结果。 |
| CUMCM 2024 B 生产决策 | 137.88% / 0.00% | 39.02% / -10.00% | 0.00% / -100.00% | DeepSeek 这题很强;Qwen Flash 超时失败,是它总分被拉低的重要原因。 |
| CUMCM 2024 C 农作物种植 | 47.55% / 0.00% | 56.96% / 17.94% | 44.83% / -5.19% | GLM 更像写出了可用的优化模型;Qwen 接近 baseline 但略弱。 |
| CUMCM 2025 A 烟幕遮蔽 | 72.79% / 0.00% | 255.27% / 100.00% | 0.00% / -100.00% | GLM 是这题的大赢家;Qwen Flash 超时失败。这里也最能体现 Robust 封顶的必要性。 |
| CUMCM 2025 B 碳化硅厚度 | 14.32% / 0.00% | 30.95% / 19.41% | 33.94% / 22.90% | 三家都不算高,但 Qwen Flash 在物理反演/曲线拟合上略领先。 |
| CUMCM 2025 C NIPT | 152.03% / 0.00% | 107.31% / -10.00% | 128.77% / -10.00% | DeepSeek baseline 已经很强,GLM/Qwen 绝对分不错,但相对 baseline 仍是退步。 |
| MCM 2023 A 植物群落 | 154.10% / 0.00% | 116.34% / -10.00% | 37.32% / -10.00% | DeepSeek 的生态动力学数值更贴近评测器方向;Qwen 明显偏弱。 |
| MCM 2023 B 马赛马拉 | 3.04% / 0.00% | 8.86% / 6.00% | 2.32% / -0.73% | 三家都很低,GLM 只是低分区里相对多做对一点。 |
| MCM 2023 C Wordle | 0.00% / 0.00% | 56.58% / 56.58% | 6.54% / 6.54% | GLM 在数据建模/词频预测上追回很多,DeepSeek baseline 没拿分。 |
| MCM 2024 A 七鳃鳗 | 23.53% / 0.00% | 8.96% / -19.05% | 10.81% / -16.63% | 三家都偏低,DeepSeek 相对最好。 |
| MCM 2024 B 潜水器搜索 | 17.60% / 0.00% | 63.24% / 55.38% | 27.29% / 11.75% | GLM 明显追回 gap,Qwen 有提升但不多。 |
| MCM 2024 C 网球动量 | 50.72% / 0.00% | 77.33% / 54.00% | 46.46% / -8.63% | GLM 在统计检测/势头识别上很强;Qwen 稍低于 baseline。 |
| MCM 2025 A 楼梯磨损 | 0.00% / 0.00% | 0.00% / 0.00% | 0.00% / 0.00% | 三家 Flash 都没拿到有效分,这题仍然是硬骨头。 |
| MCM 2025 B 朱诺旅游 | 0.00% / 0.00% | 0.00% / 0.00% | 90.71% / 90.71% | Qwen Flash 这题反而很亮眼,做出了可评分的系统动力学/政策优化结果。 |
| MCM 2025 C 奥运奖牌 | 177.39% / 0.00% | 18.61% / -10.00% | 92.09% / -10.00% | DeepSeek baseline 太强,GLM/Qwen 绝对结果不算完全不能看,但相对 baseline 都吃亏。 |
如果只看这张逐题表,三家模型的性格就很清楚了:
- DeepSeek-v4-Flash:不是每题都赢,但强题很多,而且便宜。尤其 CUMCM 2023 C、CUMCM 2024 B、CUMCM 2025 C、MCM 2023 A、MCM 2025 C,这些题把它的 O-Eval 主分托得很稳。
- GLM-5.3-Flash:最有“追分感”。它在 CUMCM 2025 A、MCM 2023 C、MCM 2024 B、MCM 2024 C 这几题上明显赢过 baseline,所以 Robust BO-Eval 很高。
- Qwen3.8-Flash:波动最大。有 CUMCM 2023 A、CUMCM 2023 B、CUMCM 2025 B、MCM 2025 B 这种好题,也有 CUMCM 2024 B、CUMCM 2025 A 这种超时失败题,再加上 token 太多,所以整体不适合当这轮的默认主力。
为什么 GLM 的 Robust 高,但 O-Eval 没赢 DeepSeek
这个问题很容易让人误会:是不是两个指标互相矛盾?
不是。
O-Eval 是看离 O 奖复现答案有多近。
Robust BO-Eval 是看比 DeepSeek-v4-Flash baseline 多追回多少。
GLM-5.3-Flash 的 O-Eval 是 65.59%,低于 DeepSeek-v4-Flash 的 71.98%。这说明从“平均接近 O 奖复现答案”这个角度,DeepSeek 仍然更好。
但 GLM 的 Robust BO-Eval 是 9.48%,高于 baseline 的 0%。这是因为 GLM 正好在一些 baseline 弱项上追得非常明显:
- MCM 2023 C:DeepSeek 0%,GLM 56.58%
- MCM 2024 B:DeepSeek 17.60%,GLM 63.24%
- MCM 2024 C:DeepSeek 50.72%,GLM 77.33%
- CUMCM 2025 A:DeepSeek 72.79%,GLM 255.27%
- CUMCM 2025 B:DeepSeek 14.32%,GLM 30.95%
这些题会把 GLM 的 Robust 拉上去。
但反过来,DeepSeek 在另一些题上的绝对成绩更强:
- CUMCM 2023 C:DeepSeek 213.50%,GLM 170.76%
- CUMCM 2024 B:DeepSeek 137.88%,GLM 39.02%
- CUMCM 2025 C:DeepSeek 152.03%,GLM 107.31%
- MCM 2023 A:DeepSeek 154.10%,GLM 116.34%
- MCM 2025 C:DeepSeek 177.39%,GLM 18.61%
所以结论应该这样读:
O-Eval 负责主排名,Robust BO-Eval 负责解释相对 baseline 的局部追赶。
如果要在论文里放一个主榜,O-Eval 应放在最前;如果要讲模型能力差异,Robust 更适合作为旁边的诊断图。它不是来推翻主榜的,而是告诉读者:有些模型不是平均最强,但在某些题型上真的有自己的杀招。
轨迹和可行解到底怎么看
TB-MathModel 和“看报告打分”的 benchmark 不一样。这里不是让模型只写一篇漂亮论文,而是给它赛题、附件、终端环境,让它自己读数据、写代码、跑求解、导出结果,最后由 verifier 检查关键字段。
所以看一个模型答案时,主要看三层:
-
有没有 artifact:有没有最后写出
/root/results/*_result.json这种可评分结果。 - 有没有关键数值:结果 JSON 里的字段是否能被评测器读到,单位和方向是否合理。
- 轨迹是否像真的求解:trajectory 里是不是有读题、读附件、写 Python、调用数值库/优化库、跑出中间结果、再汇总结果的过程。
注意,这里的“可行解”不是说它一定已经达到人类论文的所有严谨性。它更准确的意思是:
在统一环境里,模型给出了能被程序化 verifier 检查的关键数值答案。
这比纯文本报告评分强很多,因为它至少逼模型真的跑代码、真的交结构化结果;但它也不是万能的。比如某些题的 O-Eval 超过 100%,可能是模型在某些指标上比 O 奖复现答案更激进,也可能是评测指标没有覆盖所有隐含约束。所以看到 145%、255% 这种分数时,不能简单理解成“模型真实世界里吊打人类”,而应该理解成:
在当前可验证指标上,它交出了比 O 锚点更优的若干关键数值。
这也是我们为什么要引入 Robust BO-Eval:小分母、过度优化、局部超分都不能让它无限爆炸,赢很多和输很多都一起截断。
四、Qwen3.8-27B-FP8 thinking:和三家 Flash 放一起看
如果把 Qwen3.8-27B-FP8 thinking 和这三家 Flash 摆在同一张桌上,它的位置其实非常清楚:
它是这组结果里绝对分最高的那个,但也是最贵的那个。
这是因为他是一个Dense模型,其实是激活参数量反而比3个Flash模型多,但是他的优势是总参数量小,本地部署比较方便。对比下:
-
DeepSeek-V4-Flash:284B总参数,13B激活参数。(huggingface.co) -
GLM-5.3-Flash:320B总参数,18B激活参数。(docs.z.ai) -
Qwen3.8-Flash-Next:125B主模型参数,外加51Bn-gram embedding;每 token 激活6B。如果把 embedding 也算进总量,可以记成约176B / 6B。(huggingface.co)
| 模型 | O-Eval | Robust BO-Eval | tokens input/cache/output | 估算成本 | 一句话读法 |
|---|---|---|---|---|---|
| DeepSeek-v4-Flash-0731 | 71.98% | 0.00% | 28,690,539 / 27,294,080 / 1,368,452 | ¥5.21 | 最稳、最便宜 |
| GLM-5.3-Flash | 65.59% | 9.48% | 107,726,029 / 101,466,688 / 3,683,366 | ¥19.62 | 最会追分 |
| Qwen3.8-Flash(百炼) | 56.49% | -5.50% | 299,616,972 / 293,563,264 / 6,814,374 | ¥59.34 | 最费 token、波动最大 |
| Qwen3.8-27B-FP8 thinking | 75.45% | 11.09% | 47,245,909 / 0 / 3,178,409 | ¥189.88 | 绝对上限更高,但票价也最高 |
这张表一眼就能说明为什么 Qwen3.8-27B 看起来“效果这么好、cost 也这么高”:
- 绝对分确实更高。 它的 O-Eval 是 75.45%,比 DeepSeek-v4-Flash 高 3.47 个百分点,比 GLM-5.3-Flash 高 9.86 个百分点,比 Qwen3.8-Flash 高 18.96 个百分点。
- 代价也确实更高。 它的估算成本是 ¥189.88,约是 DeepSeek-v4-Flash 的 36 倍、GLM-5.3-Flash 的 9.7 倍、Qwen3.8-Flash 的 3.2 倍。 也就是说,Qwen27B 不是“白捡来的高分”,而是用更重的模型体量和更长的思考过程换来的。
- 它更像“绝对上限”,不是“性价比冠军”。 Flash 三家里,DeepSeek 是最稳最省的,GLM 是最会追分的,Qwen Flash 是最费 token 的;而 Qwen27B 则是在这个价格带上把绝对效果再往上抬一档。
如果再看年均和赛制拆分,这个结论会更清楚:
- 2023 / 2024 / 2025 年均 O-Eval:95.23% / 52.82% / 78.29%
- CUMCM / MCM 平均 O-Eval:112.91% / 37.98%
这说明它特别强在 CUMCM 这类几何、物理、优化混合题上,尤其是:
- CUMCM 2023 A / B
- CUMCM 2024 B
- CUMCM 2025 A / C
这些题上它经常能把 Flash 三家都压过去。 但它也不是全能:像一些生态、社会数据、预测类 MCM 题,Flash 里偶尔会有人反超,尤其 Qwen3.8-Flash 在个别题上会非常亮。
所以如果把这四个模型合在一起看,最准确的说法不是“谁绝对碾压谁”,而是:
- DeepSeek-v4-Flash:默认主力,便宜、稳、总分高
- GLM-5.3-Flash:追分型选手,特别擅长在 baseline 弱题上拉开差距
- Qwen3.8-Flash:波动大,个别题能爆,但整体性价比不漂亮
- Qwen3.8-27B-FP8 thinking:绝对上限更高,适合看“再往上还能抬多少”,但不适合当便宜主力
换句话说,Flash 这三家更像是性价比战场;Qwen27B 更像是效果天花板。
五、三家 Flash 的最终判断
如果把 18 题的轨迹和结果放在一起看,我的判断比只看总表更坚定:
DeepSeek-v4-Flash-0731 是这轮最适合当默认主力的 Flash。 它不是每题都赢,但 O-Eval 最高、成本最低,强题覆盖面也够大。
GLM-5.3-Flash 是最值得单独观察的追分型 Flash。 它在一些 baseline 弱项上确实有惊喜,尤其烟幕、Wordle、潜水器搜索、网球动量。但它也有 CUMCM 2023 A 超时和若干强 baseline 题掉队的问题,所以不应该用 Robust 辅分替代 O-Eval 主榜。
Qwen3.8-Flash 这轮不适合作为默认主力。 它有亮点,尤其定日镜、多波束、朱诺旅游;但两个超时失败加上极高 token 消耗,让它的综合性价比很难看。
所以这篇的最终结论还是那句话:
主榜看 O-Eval:DeepSeek-v4-Flash 更强、更稳、更便宜。 辅榜看 Robust BO-Eval:GLM-5.3-Flash 在 baseline 弱项上更会追分。 Qwen3.8-Flash 不是没亮点,而是这轮波动和成本都太大。
后面我们出一篇专门讲 Qwen3.8-27B-FP8 thinking。它是另一个故事:27B、本地 H800、thinking-on,却在 TB-MathModel 上打出了非常不符合直觉的强效果,值得单独开一篇慢慢拆。
附录、18 道题逐题拆解
CUMCM 2023 A:定日镜场设计
这题是解析几何、物理仿真和运筹优化的组合题。模型要处理太阳高度角、DNI 辐照、镜面反射、遮挡、截断效率、镜场面积和镜子数量。
三家 Flash 里 Qwen3.8-Flash 最高,O-Eval 145.59%;DeepSeek-v4-Flash 也很稳,96.70%;GLM-5.3-Flash 没跑出可评分结果。本题最重要的坑是:O raw 和 baseline raw 太近,O - B 只有约 0.033,所以旧 BO-Eval 会把 37 对 32 这种差距放大成 841% 这种离群点。现在 Robust 只给 Qwen 封顶 10%。
从轨迹看,这类好答案一般会走“太阳位置采样 + 几何光学效率 + 镜场布局参数搜索”的路线,主要靠 numpy、pandas、openpyxl,复杂一点会用 scipy 做局部优化。Qwen Flash 的数值是可评分的,但高于 O 的部分需要理解成“关键指标更优”,不是完整物理可行性的最终证明。
CUMCM 2023 B:多波束测线布设
这题是海底测线规划,本质是解析几何加运筹优化:根据海深坡度计算声呐覆盖宽度,再设计测线,让总长度、漏测率、重叠率都合适。
三家都很高:DeepSeek 134.51%,GLM 150.06%,Qwen 154.27%。这里不是 Qwen 一枝独秀,而是这题很多 agent 都能用几何公式和贪心搜索跑出超过 O 锚点的数值。Robust 统一截到 10%,避免大家在 O 已经被超过时继续靠小分母互相吹飞。
轨迹上,常见路线是用 numpy/scipy 建坡面和覆盖区间,再用贪心或局部搜索生成测线。可行性主要看漏测和重叠约束是否在 verifier 读取的字段里成立。
CUMCM 2023 C:蔬菜定价
这题属于数据建模和优化决策:先预测蔬菜销量/价格/损耗,再给出补货量和定价策略。
DeepSeek-v4-Flash 是三家里最强的,O-Eval 213.50%;GLM 和 Qwen 也分别有 170.76%、175.50%,但 Robust 都是 -10%。原因很简单:baseline 已经超过 O 很多,GLM/Qwen 虽然绝对值不低,但相对 baseline 是退步。
轨迹上通常会出现 pandas 做数据清洗,statsmodels/scikit-learn 做预测,scipy 或自写搜索做定价优化。可行性主要看输出的补货、定价、收益等字段能不能和历史数据、约束逻辑对上。
CUMCM 2024 A:板凳龙/舞龙路径
这题是几何运动学和轨迹规划。模型要把长队伍的运动路径转成位置、速度、碰撞/间距等可计算约束。
DeepSeek 本题是 0,GLM 和 Qwen 都是 20.35%。这说明三家 Flash 在这题都没有完整攻下来,但 GLM/Qwen 至少交出了一部分可评分的几何运动结果。
轨迹上这题常见做法是参数化螺线或分段路径,再逐时刻计算各节位置。真正难点是约束细节多,单位和索引容易错,所以看起来会写代码不代表一定能拿高分。
CUMCM 2024 B:生产过程决策
这题是统计推断加运筹优化。模型要根据抽检、次品率、拆解/返工/报废成本,设计决策策略。
DeepSeek 这题非常强,137.88%;GLM 只有 39.02%;Qwen 超时失败,按 0 和 -100% 处理。这道题是 Qwen3.8-Flash 总分被拉低的重要原因之一。
轨迹上,靠谱方案会把贝叶斯估计、期望成本、动态规划或枚举决策结合起来。失败常见原因不是完全不会建模,而是分支太多、仿真太慢、最后没有在时间内写出结果 JSON。
CUMCM 2024 C:农作物种植
这题是典型运筹优化题:多地块、多作物、多季节、多约束,核心是线性规划、整数规划或启发式搜索。
GLM 表现最好,56.96%,Robust 17.94%;DeepSeek 47.55%;Qwen 44.83%。这题能看出 GLM 在约束规划类任务上比较有手感。
轨迹上,较好的解会用 pandas 读附件,用 scipy 或 MILP 思路建目标函数和约束,再输出每个地块每季作物面积。可行性重点是面积、轮作、销售量、成本收益这些约束是否真的落到表里。
CUMCM 2025 A:烟幕遮蔽
这题是物理几何仿真加优化,涉及无人机、导弹、烟幕弹、遮蔽时间窗口等动态几何关系。
GLM-5.3-Flash 这题非常突出,O-Eval 255.27%,Robust 封顶 100%;DeepSeek 是 72.79%;Qwen 超时失败。这也是 GLM Robust 高的核心来源之一。
但这类题的高分一定要谨慎读:模型可能在可验证字段上找到了更长遮蔽时间,但评测器不会像人工论文评审那样审完整推导。它是可评分结果,不等于物理可行性已经被完全证明。
CUMCM 2025 B:碳化硅外延层厚度
这题是物理反演和非线性拟合:根据红外干涉数据,估计外延层厚度,还要处理多光束干涉和噪声。
三家分数都不高,但 Qwen Flash 最高,33.94%;GLM 30.95%;DeepSeek 14.32%。这里 Qwen 的轨迹通常会更像“先建物理公式,再拟合参数”的路线。
主要库一般是 numpy、pandas、scipy、matplotlib。可行性看拟合曲线、厚度估计和误差字段是否自洽。
CUMCM 2025 C:NIPT 检测时点
这题是数据建模、统计推断和风险决策:根据孕妇 BMI、孕周、Y 染色体浓度等数据,判断最佳检测时点和分组策略。
DeepSeek 152.03%,Qwen 128.77%,GLM 107.31%。三家都不差,但 DeepSeek baseline 已经很强,所以 GLM/Qwen 在 Robust 里都是 -10%。
轨迹上常见做法是 pandas 清洗数据,statsmodels 做回归或混合模型,scikit-learn 做分组/验证,再用阈值规则输出风险时点。可行性看分组、预测浓度、时间点是否能被 verifier 检查。
MCM 2023 A:植物群落
这题是生态系统动力学,常用微分方程、差分方程或基于物种参数的动态仿真。
DeepSeek 154.10%,GLM 116.34%,Qwen 37.32%。Qwen 在这题明显偏弱,说明它没有把生态动态和评测关键指标很好地对上。
轨迹上,较好方案会用 ODE/RK4 或离散递推模拟生物量、干旱记忆、物种相互作用,再输出长期稳定性和恢复能力。库通常是 numpy、scipy、matplotlib。
MCM 2023 B:Maasai Mara 保护区
这题是空间规划、生态旅游和多目标决策的综合题。它既要考虑保护、旅游、经济,也要考虑区域功能分区。
三家都低:DeepSeek 3.04%,GLM 8.86%,Qwen 2.32%。GLM 只是相对多抓住了一点指标,但离 O 还远。
轨迹上,这题很多 agent 会写多目标评分、网格分区、离散动态系统,但难点是题意开放、可验证字段有限,稍微偏离 expected result 就很难得分。
MCM 2023 C:Wordle
这题是数据建模和预测题:根据历史 Wordle 结果做难度、分布、未来词表现等预测。
GLM 56.58%,Qwen 6.54%,DeepSeek 0。GLM 这题明显更好,是它 Robust 分数的重要来源。
轨迹上,靠谱做法会用 pandas 清洗词频和日期数据,用时间序列、回归、分类模型或特征工程预测分布。库一般是 pandas、numpy、scikit-learn、statsmodels、scipy。
MCM 2024 A:七鳃鳗生态影响
这题是生态动力学和参数仿真,通常需要构建食物网、繁殖、性别比例、捕食压力等机制模型。
DeepSeek 23.53%,Qwen 10.81%,GLM 8.96%。三家都低,只能说 DeepSeek 在可验证指标上略好。
轨迹上,常见路线还是 ODE 或离散时间模型。但这题如果参数假设和 expected result 不一致,很容易写了很多仿真却得不到高分。
MCM 2024 B:潜水器搜索
这题是贝叶斯搜索、随机仿真和路径规划。模型要根据事故位置不确定性、洋流漂移、搜索资源,规划搜索区域和策略。
GLM 63.24%,Qwen 27.29%,DeepSeek 17.60%。这题 GLM 非常明显地追上来了,Robust 55.38%。
轨迹上,好的答案通常会做 Monte Carlo 粒子模拟、概率热力图、搜索区域优先级和资源分配。库一般是 numpy、pandas、matplotlib,复杂一点会有 scipy 优化。
MCM 2024 C:网球比赛动量
这题是体育数据建模、时间序列和统计检验。模型要判断“momentum”是否存在、如何量化、能否预测比赛走势。
GLM 77.33%,DeepSeek 50.72%,Qwen 46.46%。GLM 这题的优势比较清楚,说明它在统计特征和事件序列建模上抓得更好。
轨迹上,较好的方案会做发球胜率基准、破发点、EWMA 残差、游程检验、Ljung-Box 检验等。可行性看输出的 momentum 指标、预测准确率、关键事件解释是否被 verifier 接住。
MCM 2025 A:楼梯磨损
这题是物理反演和数据估计:根据楼梯磨损形态反推使用人数、峰值流量和材料/时间因素。
三家 Flash 都是 0。这说明这题在当前 verifier 口径下没有拿到可评分关键结果。这里就不应该安慰性给分,失败就是失败。
轨迹上,模型可能会写磨损模型、曲面拟合、流量估计,但最后如果关键字段缺失、单位不对或结果不在评测器接受范围内,就进入 0 分。
MCM 2025 B:朱诺旅游
这题是系统动力学、旅游承载力和多目标优化。模型要平衡游客数量、环境压力、居民满意度、税收和政策控制。
Qwen Flash 90.71%,DeepSeek 0,GLM 0。这是 Qwen3.8-Flash 少数非常漂亮的题,说明它并不是整体不会建模,而是波动太大。
轨迹上,常见路线是建立游客-环境-居民-财政的耦合系统,再用动态规划或情景仿真找政策参数。可行性看政策变量、预测指标和目标函数输出是否完整。
MCM 2025 C:奥运奖牌预测
这题是数据建模、机器学习和 Monte Carlo 仿真:根据历史奖牌、项目、主场、国家特征,预测 2028 奖牌榜和潜在首金国家。
DeepSeek 177.39%,Qwen 92.09%,GLM 18.61%。DeepSeek 这题很强,Qwen 虽然没有赢 baseline,但绝对分不算差;GLM 明显偏弱。
轨迹上,较好方案会用随机森林、回归、国家/项目特征工程和 Monte Carlo 置信区间。可行性看最终奖牌表、首金概率、区间估计是否结构化输出。