
上一篇《高质量 Agent 训练数据,正在怎么被合成?》,里面讲到一个趋势:
Agent 训练数据正在从“问答样本”变成“可执行环境 + 任务指令 + verifier + 轨迹 + reward”。
这句话听起来有点抽象。
如果你只是训练一个 Chat 模型,一条数据可能是:
user question -> assistant answer
但如果你想训练一个能在终端、代码仓库、Docker 环境里工作的 Agent,普通问答数据就不够了。Agent 真正需要学习的是:
- 如何读任务;
- 如何探索文件系统;
- 如何写代码或脚本;
- 如何运行测试;
- 如何从报错里恢复;
- 如何在 verifier 约束下交付一个真的能跑通的结果。
所以这次 DataArc-SynData-Toolkit 的更新,最重要的不是“多了几种 prompt”,而是补上了一条完整的 Agentic Data 合成链路:
A Scalable and Verified Environment Synthesis Framework for Agent RL Training
更直白一点说:
它不再只是合成 instruction / CoT,而是在合成“可执行、可验证、可评测、可产出轨迹”的 Agent 训练环境。
本文对应的代码实现已经放在 DataArc-SynData-Toolkit 的 SynAgenticData 分支。代码和运行细节大家可以直接看仓库,本文重点讲方法:怎么通过 prompting 引导大模型合成一整个可验证任务环境,而不是只改写一道题面。
https://github.com/DataArcTech/DataArc-SynData-Toolkit/tree/SynAgenticData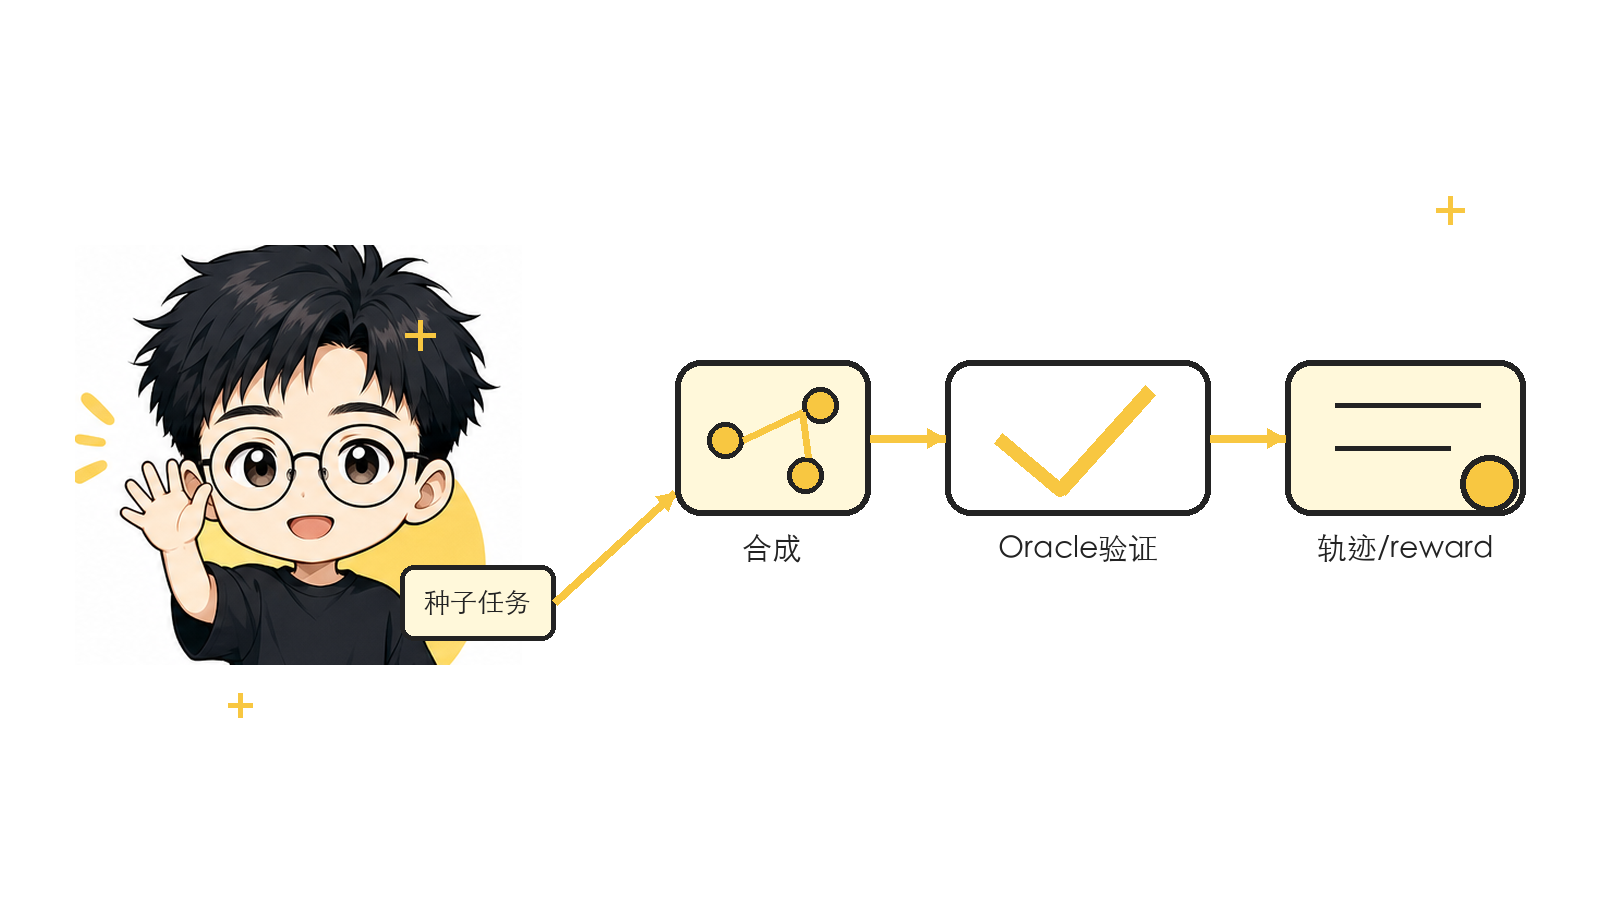
</ol><p data-pid="V_4eSfDP">这对普通 SFT 很有用,但对 Agent RL 来说有一个根本问题:答案说得像,不代表任务做得成。</p><p data-pid="_5eThywS">例如一个 terminal-bench 风格任务,用户可能要求:</p><blockquote data-pid="qsgCGswB"> 修复一个并发 Bash 脚本,使它在多进程同时运行时仍然能原子地更新日志汇总文件。
</blockquote><p data-pid="bU2Li0qH">这时候只生成一段“看似合理”的解法没有意义。我们真正关心的是:</p><ul>
</ul><p data-pid="sZliXJ1a">换句话说,Agentic Data 的单位不是一条文本,而是一个任务环境。</p><h2>二、一个 verified env 到底包含什么?</h2><p data-pid="CoajCvVz">这次我们把 terminal-bench 风格任务当作核心目标。一个合成样本不再只是 input/output,而是一整个任务目录。</p><p data-pid="dSh1VmnL">核心 artifact 至少包括:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="V-1O0BP2">这里有一个很容易犯错的点:</p><blockquote data-pid="ItOMNTyA"> 不能只改 instruction 和输入数据。
</blockquote><p data-pid="h8nqQKMY">如果任务描述变了,oracle solution 和 tests/verifier 也必须同步变化。否则就会出现非常糟糕的数据污染:</p><ul>
</ul><p data-pid="DuHkLZlV">所以正确的心智模型是一个“一致性闭包”:</p><div class="highlight"><pre>instruction + input data + solution + tests + environment
</pre></div><p data-pid="E286XzU8">任何一处变了,其他几处都要重新检查。最终能不能进训练集,不看模型自称正确,而看 oracle solution 在新 tests 下跑出来的 reward。</p><h2>三、方法流程:让模型合成完整 env,而不是一条题面</h2><p data-pid="0J2qjoPR">这次的核心,不是多写几个脚本,而是把大模型的输出空间从“生成一段回答”约束成“生成一个可执行任务环境”。</p><p data-pid="LfWZndG9">整体流程是:</p><div class="highlight"><pre>seed terminal task
-> method-specific synthesis prompt
-> full task artifact JSON
-> static validation
-> materialize terminal-bench directory
-> Harbor oracle/gold solution validation
-> repair if failed
-> accepted verified task
-> Terminus-2 rollout
-> trajectory + reward
</pre></div><p data-pid="B_XA844H">其中最关键的是两级验证。</p><p data-pid="VQ7P_8wp">第一级是静态验证,比如:</p><ul>
:latest;tests/test.sh 是否一定会写 /logs/verifier/reward.txt;</ul><p data-pid="JCU9pbNh">第二级是 gold solution 验证:</p><blockquote data-pid="iIuzwDyh"> 把生成出来的任务真的物化成 terminal-bench 目录,然后用 Harbor 跑 oracle solution,只有 reward=1 才算 accepted。
</blockquote><p data-pid="QaX2vNxP">这也是我认为这次更新最有价值的地方:它把“数据生成”从 prompt 工程,推进到了 verifier-backed environment synthesis。</p><h2>四、四种合成方法:不只是换题面</h2><p data-pid="wt3HEJoD">这次我们扩展了Dataarc-Syndata-Toolkit的四种数据合成方法到Agentic任务/环境合成:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table>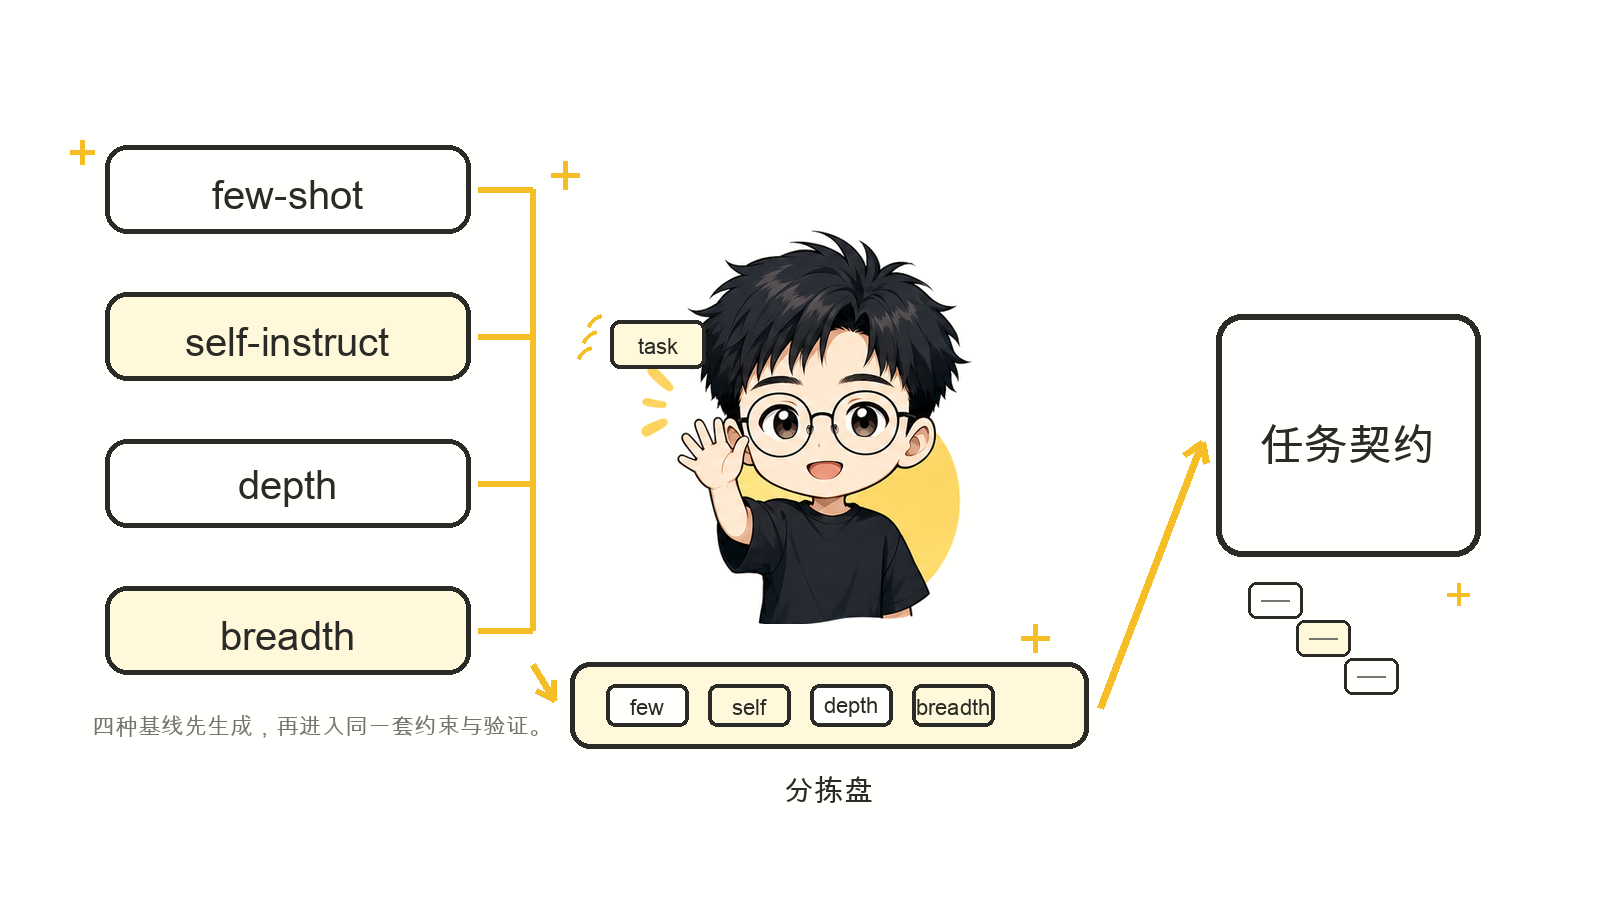
</ul><p data-pid="ocZCjcrV">区别只在于“怎么变”:</p><ul>
few_shot 更像 close variant;self_instruct 更像同域自举;depth 更像难度加深;breadth 更像任务族扩展。</ul><h2>五、从 100 条 seed 到 400 条 verified synthetic tasks</h2><p data-pid="DWZB0Mdp">这次实验使用的是 OpenThoughts-TBLite 的 100 个 terminal-bench 风格任务。目标是:</p><blockquote data-pid="_kbVv-B7"> 四种方法各生成 100 条 verified task,总计 400 条 synthetic verified envs。
</blockquote><p data-pid="4vTK8PGh">模型使用 deepseek-v4-flash 做合成。验证阶段使用 Harbor / terminal-bench 风格的 gold solution validation。</p><p data-pid="ONVJFd_6">最后统计如下:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="XoKnu0bc">这里有两个概念容易混:</p><p data-pid="ypiyuMh2">records 是最终记账条目,一次合成尝试最终留下一个 record,可能成功也可能失败。</p><p data-pid="EIGZMMh6">task dirs / 物化次数 是真实落盘并跑过验证的候选任务目录数量。它包含初稿、repair 中间稿、最终稿和失败稿。</p><p data-pid="4KeGZBYL">举个例子:</p><div class="highlight"><pre>初稿任务 A -> 验证失败
repair-1 -> 验证失败
repair-2 -> 验证通过
</pre></div><p data-pid="TMr8CRIF">这在 records 里最终可能只算 1 条 accepted record,但在 task dirs 里算 3 次物化,因为系统真的生成并验证过 3 个任务目录。</p><p data-pid="zvz30dnY">所以 records 更像业务结果数,task dirs 更像真实消耗。</p><p data-pid="ex4fr2HC">从这个角度看,evol_instruct_in_breadth 的合成成本最低:107 条 final records、174 次物化拿到 100 条 verified。few_shot 和 evol-depth 的 repair 成本更高一些。</p><h2>六、verified 不等于 easy:还要让 Agent 真跑</h2><p data-pid="PC92Dl6H">生成任务通过 oracle verification 只能说明一件事:</p><blockquote data-pid="rvD2VHCt"> 这个任务是自洽的,有可执行参考解,tests 能验证正确答案。
</blockquote><p data-pid="qI11qQBS">但这还不等于下游 Agent 能做出来。</p><p data-pid="eLD9mVSo">所以我们继续用 Terminus-2 在五组任务上跑评测:</p><ol>
few_shot 100 条 verified synthetic tasks;self_instruct 100 条 verified synthetic tasks;evol-depth 100 条 verified synthetic tasks;evol-breadth 100 条 verified synthetic tasks。</ol><p data-pid="w-p3SuIM">结果大致如下:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="WJfgQd2y">这个结果很有意思。</p><p data-pid="5m5GU6bc">few_shot 的 pass 率最高,这符合直觉:它更贴近原始任务结构,变化比较可控。</p><p data-pid="OnIPJPEn">evol-depth 和 evol-breadth 的 strict mean 接近原始任务,但失败更多,说明它们生成的任务对 downstream agent 仍然有挑战。</p><p data-pid="NoQBhcdc">这里的关键不是“哪种方法绝对最好”,而是:</p><blockquote data-pid="4ufoDtCT"> 同一批 seed,经过不同合成策略,可以得到不同难度、不同结构、不同失败模式的 agentic training environments。
</blockquote><p data-pid="b3FrGPBK">这对 RL training 很重要。因为 RL 不只需要成功轨迹,也需要有区分度的 reward、失败轨迹、困难任务族和可控 curriculum。</p><h2>七、一个成功例子:同一 seed 的四种变体</h2><p data-pid="SeBVepFq">我们拿 csv-json-jsonl-merger 这个 seed 举例。</p><p data-pid="n-ULwMNo">原始任务是:</p><blockquote data-pid="8m_9iUM9"> 给 /workspace/users.csv、records.jsonl、profiles.json 三份用户数据,写 /workspace/do_merge.py,输出 /workspace/merged_records.csv,字段是 email, phone, status,要求 union 所有唯一 email。
</blockquote><p data-pid="X5JATGMS">四种合成方法得到的任务分别是:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="23H6jMsD">这个例子很适合解释四种方法的区别:</p><ul>
few_shot 是“同模板换参数”;self_instruct 是“同领域另起一个相关任务”;depth 是“原任务加字段、加优先级、加边界”;breadth 是“保留数据领域,但换成邻近任务类型”。</ul><p data-pid="jjTcUd7U">更重要的是,这几条不是只改了题面。每条任务都同步改了 instruction、fixtures、solution 和 tests,并通过 oracle verification。</p><h2>八、一些真正难的任务:Agent 过不了,但训练价值很高</h2><p data-pid="qa4W6bur">如果只看成功案例,很容易产生一个错觉:合成任务是不是都偏简单?</p><p data-pid="qBR2zZot">实际上并不是。</p><p data-pid="nQwdRSUf">我们专门找了一些 Terminus-2 不怎么过的任务族:</p>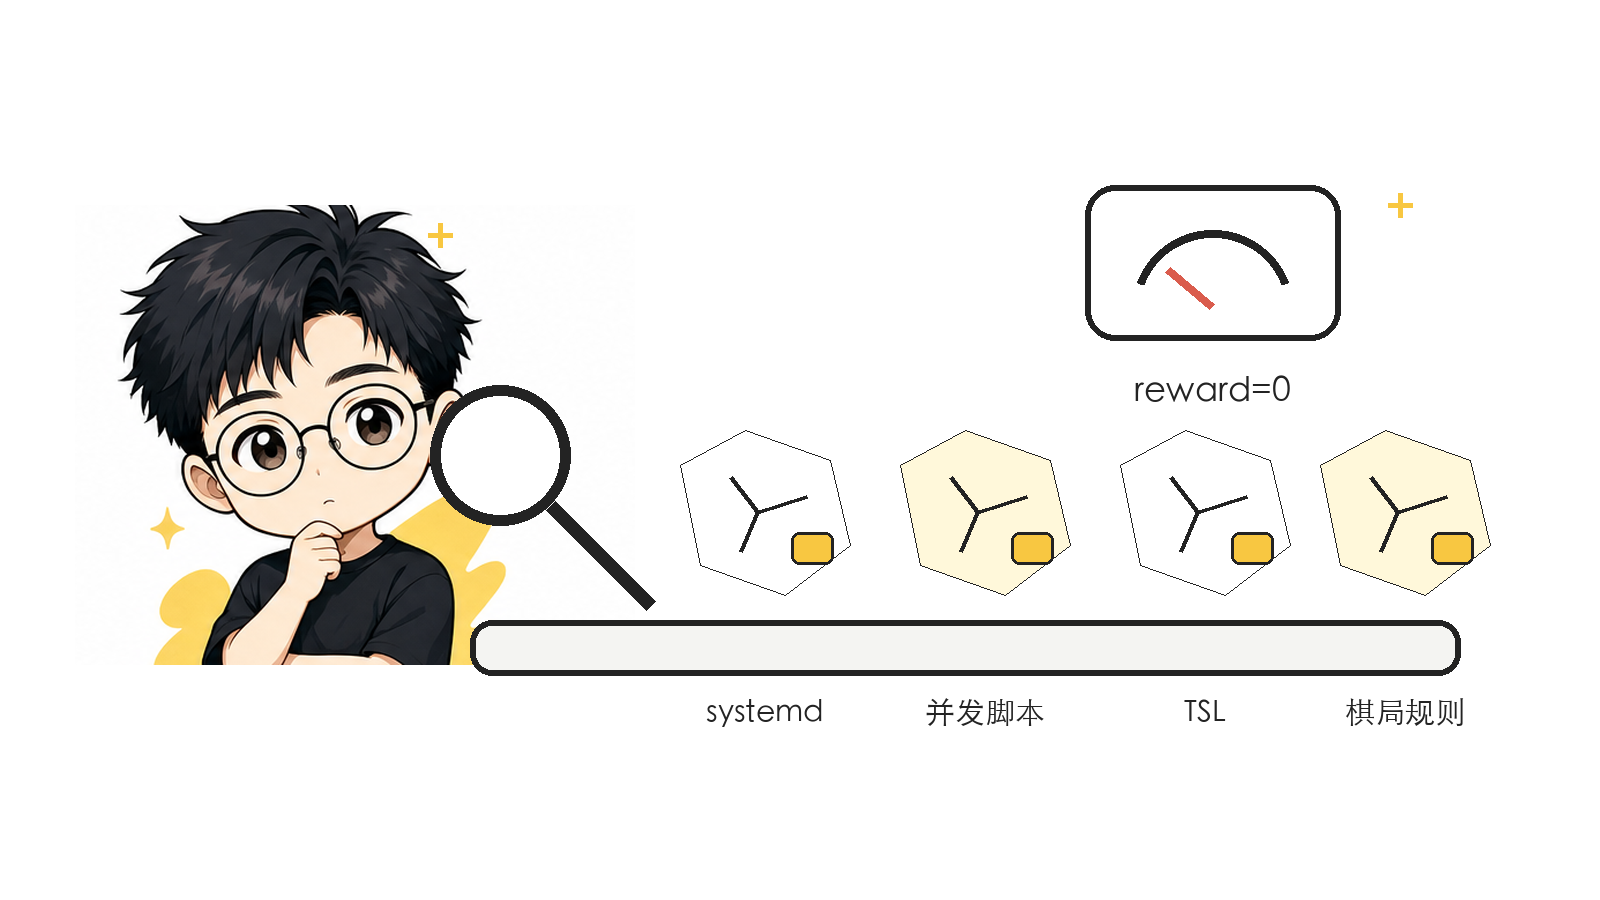
</tbody></table><p data-pid="stH5DMyN">这些任务本身都是 oracle/gold verified 的。也就是说,不是数据不自洽,而是 downstream agent 真没做出来。</p><h3>systemd-log-monitoring:系统配置任务太硬</h3><p data-pid="fVnUc_pD">原始任务要求部署 systemd service,让 Python app 输出 JSON logs,再经 journald / rsyslog 抽取到结构化日志,同时配置 logrotate 和监控脚本。</p><p data-pid="FlZE3drw">合成任务包括:</p><ul>
</ul><p data-pid="fZPBVaJX">结果是原始和四种合成都 reward=0。</p><p data-pid="WjIwFvf1">这说明 systemd、journald、rsyslog、logrotate 这类系统服务组合,对当前 Agent 非常硬。它不是某个 prompt 没写好,而是一个任务族都很容易卡住。</p><h3>TSL test-case-generation:抽象测试规格很难</h3><p data-pid="uQbXR2LJ">原始任务要求根据 TSL / Category-Partition Method 生成具体测试用例。</p><p data-pid="xXO7XJmQ">few_shot、self_instruct、depth 都保留了 TSL 测试生成这个本质,reward 都是 0。</p><p data-pid="T4GmQxRG">breadth 则横向变成了一个 MD5 hash 任务,reward=1。</p><p data-pid="1rFwuitw">这个例子很有意思:breadth 过了,但它其实也说明 breadth 可能“跳得太远”,把原始难点稀释掉了。后续如果要用 breadth 做 curriculum,就需要控制 task-distance,避免把 hard domain 变成 unrelated easy task。</p><h3>bash-log-processor-fix:并发脚本的坑很深</h3><p data-pid="QeRccpCS">原始任务是修复一个 Bash 脚本,递归处理 .log 文件,并发运行时不能漏文件,更新 processed.log 和 per-directory summary 要原子正确。原始 reward 只有 0.747。</p><p data-pid="UTPTU284">合成任务把 line count 改成 word count、把 .log 改成 .txt、增加幂等/并发约束、或者改成 ERROR extractor,但四种合成任务 Terminus-2 都是 0。</p><p data-pid="ekJKXFB5">这个任务族的难点在于:</p><ul>
</ul><p data-pid="gDIyxt8c">Agent 很容易写出一个“看起来能跑”的 Bash 脚本,但 verifier 一跑边界就暴露出来。</p><h3>PGN chess repair:规则推理 + 精确 JSON 输出</h3><p data-pid="cR80-q0D">原始任务要求修复 corrupted PGN、分析棋局、解 puzzles,reward 0.533。</p><p data-pid="yTfBudDj">合成任务里:</p><ul>
few_shot 简化成 chess validator,reward=1;self_instruct 简化成单局 corrupted game + 两个 puzzle,reward=0.7;depth 加 forced mate 的 mate_in 精确步数,reward=0;breadth 改成 FEN 是否被将军,reward=0。</ul><p data-pid="7D4tJeFO">这说明规则推理、结构化输出和领域知识叠在一起时,Agent 表现非常不稳定。尤其 mate_in 这种精确约束,一加就明显变难。</p><h2>九、为什么这对 Agent RL Training 重要?</h2><p data-pid="D8Y0ZcGu">我觉得这个框架真正有价值的地方,不只是“能生成 400 条任务”。</p><p data-pid="JvoNf6cp">更关键的是,它把 RL 需要的几个东西放到了一条链路里:</p><h3>1. 可执行任务环境</h3><p data-pid="jPrRHmnP">每条任务都是一个 terminal-bench 风格目录,而不是一段不可验证文本。</p><p data-pid="iFXXT1eC">这意味着它可以被 harness 调用,可以在 Docker 里跑,可以复现 reward。</p><h3>2. Oracle-backed verification</h3><p data-pid="zLKJx_Bx">生成任务不是靠模型自评,而是要用 oracle solution 通过 tests。</p><p data-pid="bAXhVrmv">这能过滤掉大量“题面和测试不一致”“任务无解”“环境跑不起来”的坏样本。</p><h3>3. Downstream agent trajectory</h3><p data-pid="qVxS28w2">Terminus-2 跑完后,每个 trial 都会生成 trajectory,包括多轮行动、命令输出、失败、恢复和最终 verifier reward。</p><p data-pid="bcfa2zTb">这类 trajectory 可以用于:</p><ul>
</ul><h3>4. 失败样本也有价值</h3><p data-pid="F39YLf4y">在普通 SFT 里,失败样本经常被丢掉。</p><p data-pid="eGf_IAaA">但在 Agent RL 里,失败很有价值。比如:</p><ul>
</ul><p data-pid="gg2_Y0tq">这些失败不是噪声,而是训练信号。</p><h2>十、怎么通过 Prompting 做任务/环境合成?</h2><p data-pid="pVDZu6jd">如果只给模型一句“帮我改写这个任务”,它大概率只会改 instruction。</p><p data-pid="1MHQzY4F">但 agentic env synthesis 不是改写题面。我们真正要 prompt 的,不是一个 answer generator,而是一个同时扮演四个角色的模型:</p><ol>
</ol><p data-pid="BqUj3Af2">所以 prompt 不能只描述“生成什么样的新任务”,还要描述“哪些 artifact 必须一起变化”。</p><p data-pid="gRvWGbaa">我现在更倾向于把这个 prompt 拆成三层。</p><h3>1. Seed Context:把原任务拆给模型看</h3><p data-pid="-C0uDXXL">第一层是 seed context。不要只给原始 instruction,而是把一个任务环境拆成模型能理解的结构:</p><ul>
</ul><p data-pid="RlWb2Wxd">这一步的作用是让模型知道:原任务不只是一段文字,而是一个由 instruction、data、solution、tests、environment 组成的闭包。</p><h3>2. Synthesis Action:明确这次到底怎么变</h3><p data-pid="1Yc_Zh7l">第二层是 synthesis action,也就是这次合成采用哪种“变化原语”。</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="VW-1lTvp">这里的关键是:四种方法不是四个“答案风格”,而是四种环境变换方式。</p><p data-pid="Oyd_S920">例如同样是 csv-json-jsonl-merger:</p><ul>
few_shot 可以换成大学薪资字段 merge;self_instruct 可以变成同领域的用户 summary 生成;depth 可以加嵌套 JSON、字段优先级、fallback、稳定排序;breadth 可以横向变成 top salary extractor。</ul><p data-pid="DS4EZfE0">它们共享一个要求:只要任务变了,fixtures、oracle solution、tests 也必须跟着变。</p><h3>3. Output Contract:让模型输出完整环境,而不是自然语言解释</h3><p data-pid="VnWqZ2Uh">第三层是 output contract。这里要非常硬。</p><p data-pid="xICXWs9Q">模型不能只输出“新任务描述”,而要输出一个完整的 environment spec:</p><div class="highlight"><pre>task_id
instruction
files / fixtures
oracle solution
tests / verifier
environment assumptions
metadata: source seed, synthesis method, changed skills
</pre></div><p data-pid="-0qN92yT">同时 prompt 里要加一些强约束:</p><ul>
</ul><p data-pid="7aFw-uCa">我觉得这就是 agentic data synthesis 和普通 instruction synthesis 最大的区别。</p><p data-pid="-HJwIebO">普通 instruction synthesis 的 prompt 目标是“生成一个问题”。
Agentic env synthesis 的 prompt 目标是“生成一个可执行问题系统”。</p><h3>4. Repair Prompt:验证失败后,不要让模型重写一切</h3><p data-pid="vuCb1GEf">还有一个很重要的技巧:repair prompt。</p><p data-pid="GMcNCQ-O">模型第一次生成的任务很容易出现小错,比如:</p><ul>
</ul><p data-pid="U6RkbHRF">这时候不要简单说“重新生成一个任务”。更好的方式是把失败日志、静态检查结果、gold solution reward 和相关 artifact 片段喂回模型,让它做定向修复:</p><blockquote data-pid="Gr74GPqU"> 保持任务意图不变,只修复导致 verification failure 的最小不一致。
</blockquote><p data-pid="T3pNH3mA">这会显著减少任务漂移。否则模型很容易在 repair 阶段把任务改成另一个东西,最后虽然通过了验证,但已经不是原本想合成的那类训练样本了。</p><p data-pid="08Ci8G8r">所以整套 prompting 的核心可以总结成一句话:</p><blockquote data-pid="vEVWsoCB"> 不是 prompt 模型“出一道题”,而是 prompt 模型生成一个 instruction、data、solution、tests、environment 彼此一致的可验证任务环境。
</blockquote><h2>十一、目前还有哪些限制?</h2><p data-pid="YPODy9pn">这个方向很有前景,但坑也不少。</p><h3>1. 生成任务必须严防不一致</h3><p data-pid="MIHrwXTt">最危险的问题永远是:</p><blockquote data-pid="vHakyNI-"> instruction 改了,但 solution/tests 没同步。
</blockquote><p data-pid="SNBraT3J">所以我更倾向于把这类系统叫 verified env synthesis,而不是简单叫 task augmentation。因为“验证”不是后处理小步骤,而是数据是否能用的核心定义。</p><h3>2. Docker / apt / pip / npm 网络问题是真实工程成本</h3><p data-pid="h2Gn9FQu">Agentic env 合成不是只跑 LLM API。</p><p data-pid="fqF4t0LD">它还要构建 Docker、安装依赖、跑 tests。国内网络下,apt、pip、npm、Docker base image 都可能成为不稳定因素。</p><p data-pid="OHLqDHTC">所以生成 prompt 和 Dockerfile static validation 里需要显式处理镜像源、禁止 runtime 下载外部安装脚本、避免 :latest、避免不稳定 bootstrap URL。</p><h3>3. breadth 可能变简单</h3><p data-pid="cIklCKcv">evol-breadth 的目标是扩展任务空间,但如果不控制距离,它可能把一个 hard domain 变成 unrelated easy task。</p><p data-pid="tiFfDzdS">比如 TSL 测试生成横向变成 MD5 hash,Agent 过了,但它对原始 TSL 难点的覆盖就弱了。</p><p data-pid="Xje7ioJs">后续需要引入 task-distance 或 skill taxonomy,控制 breadth 的跨度。</p><h3>4. downstream missing 也要单独分析</h3><p data-pid="ZiHHhri9">Terminus-2 的结果里有些任务是 missing,不是 verifier 明确 reward=0。这可能来自超时、网络、环境构建、API 调用等问题。</p><p data-pid="CCUWWSMS">在训练数据筛选时,missing、timeout、reward=0、partial reward 应该分开看。</p><h3>5. verifier 质量决定上限</h3><p data-pid="ABDOdayx">如果 tests 写得弱,任务很容易被“投机解”通过。</p><p data-pid="Jm-Mf4M2">如果 tests 写得太强但 instruction 没写清楚,Agent 又会被不公平地惩罚。</p><p data-pid="PDwv1V9S">因此 verifier synthesis 本身也是一个核心研究问题。</p><h2>十二、总结</h2><p data-pid="Ls9l_Z-c"> DataArc-SynData-Toolkit 这次更新的内容,可以概括为三句话。</p><p data-pid="IVwmf5K4">第一,数据合成的单位变了。</p><p data-pid="Jp3tLVm2">以前合成的是样本,现在合成的是环境。</p><p data-pid="Avg0Xjrg">第二,质量定义变了。</p><p data-pid="dd4bYBCK">以前看回答像不像,现在看 oracle solution 能不能在 Docker 环境里通过 verifier。</p><p data-pid="b2GNRym_">第三,训练信号变了。</p><p data-pid="SOcoAWo4">以前主要拿成功答案做 SFT,现在可以拿完整 trajectory、reward、failure mode 做 SFT、RL 和 curriculum。</p><p data-pid="rAD1p51w">所以我更愿意把它叫做:</p><div class="highlight"><pre>Scalable and Verified Environment Synthesis Framework
</pre></div><p data-pid="Yxsw1p2P">它不是替代 terminal-bench、Harbor 或 Terminus-2,而是把这些能力串起来,让我们可以从一批 seed tasks 出发,规模化地产生 verified environments,再让下游 Agent 真实执行,收集轨迹和 reward。</p><p data-pid="nOkkv13_">这件事对 Agent RL Training 很关键。</p><p data-pid="Yy9tRki9">因为未来的 Agent 模型,不能只靠“看过正确答案”变强。</p><p data-pid="D8SsIn9V">它还需要在大量可执行环境里反复尝试、失败、被 verifier 惩罚、再从轨迹中学习。</p><p data-pid="Ob0zzjlF">而 verified env synthesis,就是给这个训练循环持续供给任务燃料的一套基础设施。</p><h2>第三篇预告:Envs-FORGE,下一条任务该合成谁?</h2><p data-pid="vrV4GrnT">这一篇主要讲的是工程闭环:怎么从 seed task 出发,规模化生成 verified environment,并把它接到 Harbor / Terminus-2 里跑出 trajectory 和 reward。</p><p data-pid="PyKyRuvn">但真正进入 Agent RL 训练之后,会立刻遇到一个更硬的问题:</p><blockquote data-pid="XHaugvki"> 如果我已经能合成很多任务,下一条到底应该合成什么?
</blockquote><p data-pid="0Lht26eM">不是所有 verified task 都同样有训练价值。太简单的任务,Agent 已经会了;太难的任务,Agent 可能完全学不到;真正有价值的,往往是卡在当前 Agent learning frontier 附近的任务:有挑战,但不是纯送死;会失败,但失败里有可学习的结构。</p><p data-pid="cYTSxcQ9">所以下一篇我会介绍我们正在做的 Envs-FORGE:Frontier-Optimized Reward-Grounded Environment Synthesis for Agent RL</p><blockquote data-pid="PEUUVv3w"> 把 Agent 环境合成从 prompt baseline,推进到 reward-grounded、frontier-optimized 的优化问题。
</blockquote><p data-pid="sQJHAYlo">它不是再多加一个 prompt 模板,而是尝试把“该合成什么”写成一个可求解的优化问题。</p><p data-pid="YGZFDmW0">建模上,我们会把一次环境合成拆成几个离散决策变量:选哪个 seed task、用哪种 synthesis action、覆盖哪些 skill subgraph。目标函数不是简单追求“越难越好”或“越像原题越好”,而是让合成后的任务尽量落在当前 Agent 的 learning frontier 附近,比如 reward 既不是接近 1 的已掌握任务,也不是接近 0 的不可学习任务,而是更接近 0.5 左右、有训练梯度的任务。约束则来自 verified env synthesis 本身:合成结果必须通过 oracle verification,同时还要满足方法覆盖、技能覆盖和生成预算等限制。</p><p data-pid="xIcHs4MU">一个非常简化的形式可以写成:</p><p>
</p><p data-pid="sKM4UN1_">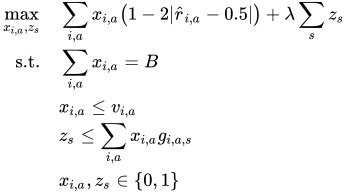 </p><p data-pid="DEK26D1V">这里
 是 seed task,
 是 synthesis action,
 表示是否选择“对 seed 使用 action ”这次合成,
 是对合成后任务 reward 的估计,
 表示这条候选是否满足 verified constraint,
 表示它是否覆盖 skill
 ,
 是合成预算。前一项把任务推向 learning frontier,后一项鼓励 skill coverage。</p><p data-pid="wuJR3LGp">这样一来,
few_shot、self_instruct、evol-depth、evol-breadth 不再只是四个并列 baseline,而可以看成这个优化问题里的不同 action choice;现有启发式方法是它的特例,Envs-FORGE 则进一步尝试用 reward estimate 和整数优化来选择更值得合成的任务。</p><p data-pid="G3Fhy22i">它会回答三个问题:</p><ol>
few_shot、self_instruct、evol-depth、evol-breadth 这些 baseline 统一进一个优化框架?</ol><p data-pid="3ZkhxStu">如果说这篇文章的关键词是:</p><div class="highlight"><pre>Scalable and Verified Env Synthesis
</pre></div><p data-pid="3HxIPNZo">那下一篇的关键词就是:</p><div class="highlight"><pre>Frontier-Optimized Env Synthesis
</pre></div><p data-pid="YyRqfkIE">也就是:不只让 Agent 有题可做,而是让它持续遇到“刚好值得学”的题。</p><p data-pid="aZOHdVXK">这会是这组文章里最接近方法论文的一篇:从经验驱动的数据合成,走向可建模、可估计、可优化的 Agent learning frontier。</p>