
前两篇我们都在用这一行:
sol = solve_ivp(...)
如果教程停在这里,读者会很容易产生一种感觉:
我把方程交给一个函数,它把曲线吐出来;至于中间发生了什么,我只能相信它。
这就是“概念墙”。
这一篇专门拆这堵墙。
我们不从数值分析术语开始,而从一个具体问题开始:
SIR 模型里,如果只知道今天的 S、I、R,电脑怎么一步步估计明天、后天、再后面的状态?
先给一句人话答案:
solve_ivp 会沿着时间轴试着往前走;每走一步都估计这一步准不准,准就接受,不准就把步子缩小重走。
这句话就是整篇文章的主线。
顺手把函数名也拆开:solve_ivp 里的 ivp 是 initial value problem,中文叫“初值问题”。
它解决的不是“所有微分方程”,而是这一类问题:
给我初始状态,再给我每个状态下的变化速度,我帮你把后面的轨迹算出来。
这一节的 takeaway:solve_ivp 不是魔法函数,它是在解“给定起点以后怎么往前走”的问题。
1. 先把问题摆到桌面上
我们继续用第二篇的 SIR 模型。
SIR 是 Susceptible-Infectious-Recovered 的缩写:
-
S:Susceptible,易感者,还没感染、但可能被感染的人 -
I:Infectious,感染者,正在感染、也可能传给别人的人 -
R:Recovered,康复者,已经离开传播过程的人
为了让数字更干净,下面用“人口比例”而不是“人数”:
-
S = 0.999表示 99.9% 的人还易感 -
I = 0.001表示 0.1% 的人正在感染 -
R = 0.0表示暂时还没人康复 -
S + I + R = 1表示总人口比例为 1
时间单位取“天”。
参数也按“每天”理解:
-
beta = 0.32:感染强度,越大表示感染者越容易把易感者拉进感染桶 -
gamma = 0.10:康复强度,越大表示感染者越快离开感染桶
现在的问题不是“曲线长什么样”,而是更小的一步:
今天是 S=0.999, I=0.001, R=0,明天大概会变成什么?
这一节的 takeaway:建模先要把变量、单位、初始状态说清楚;否则求解器算得再快,也不知道在算什么。
2. 微分方程给的不是未来,而是“此刻速度”
SIR 方程是:
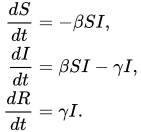
这三行不要先当成形式化定义背。
先把它翻译成人话:
-
beta * S * I:每天有多少易感者被感染者“拉进感染桶” -
-beta * S * I:这些人从S桶离开,所以S减少 -
+beta * S * I:同一批人进入I桶,所以I增加 -
gamma * I:每天有多少感染者康复 -
-gamma * I:这些人从I桶离开,所以I减少 -
+gamma * I:同一批人进入R桶,所以R增加
所以 dS_dt、dI_dt、dR_dt 不是明天的 S、I、R。
它们只是“现在这一刻三个桶变化得有多快”。
代码里就是这个函数:
def sir_rhs(t, y, beta, gamma):
    """给定当前时刻和当前状态,返回 S、I、R 的当前变化速度。"""
    # y 是当前状态,不是完整曲线。
    S, I, R = y

    # 感染流:S 桶流向 I 桶。
    infection = beta * S * I

    # 康复流:I 桶流向 R 桶。
    recovery = gamma * I

    # 三个导数就是三个桶的净流入速度。
    dS_dt = -infection
    dI_dt = infection - recovery
    dR_dt = recovery

    return [dS_dt, dI_dt, dR_dt]
这里 rhs 是 right-hand side 的缩写,意思是“方程右边”。
这个名字听起来像术语,但它在代码里只做一件事:
输入当前状态,输出当前变化速度。
这一节的 takeaway:微分方程不直接给未来曲线,它只告诉你“站在当前点,下一瞬间往哪儿走”。
3. 先手算一天,看看电脑到底在重复什么
用第二篇同一组参数:
beta = 0.32
gamma = 0.10
S = 0.999
I = 0.001
R = 0.0
先算感染流:
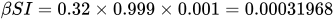
再算康复流:
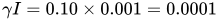
所以当前三个变化速度是:
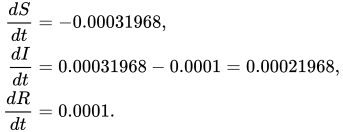
这说明在第一天刚开始的时候:
-
S正在减少 -
I正在增加 -
R正在增加
如果先用最朴素的“一天后约等于今天加一天的变化量”,就得到:
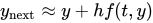
这里:
-
y是当前状态[S, I, R] -
f(t, y)是当前变化速度 -
h是这一步走多长时间
取 h = 1 天:
import numpy as np

beta = 0.32
gamma = 0.10
y = np.array([0.999, 0.001, 0.0])
h = 1.0

S, I, R = y
dy = np.array([
    -beta * S * I,
    beta * S * I - gamma * I,
    gamma * I,
])

y_next = y + h * dy
print(y_next)
大概是:
[0.99868032 0.00121968 0.0001 ]
这一小段就是数值求解的第一性原理:
看当前速度,往前挪一小步。
这一节的 takeaway:电脑算微分方程并不是一次看穿未来,而是反复做“看当前速度,往前走一点”。
4. 为什么不能一直用这个最朴素方法
上面这个方法通常叫欧拉法。
欧拉法的一句话解释是:
只看起点斜率,然后用这条直线近似下一小段曲线。
它的优点是直观。
它的问题也很直观:
如果一步太大,曲线中间已经弯了,你还拿起点斜率一路冲过去,误差就会变大。
SIR 曲线尤其容易出现这个问题。
在疫情初期,I(t) 增长越来越快;到达峰值附近以后,I(t) 又开始转弯往下。
这些地方曲线不是一条直线。
所以真正的求解器需要回答两个问题:
- 这一步能不能走得更准一点?
- 这一步到底该走多大?
solve_ivp 默认使用的 RK45,就是围绕这两个问题设计的。
这一节的 takeaway:欧拉法给了直觉,但真实求解器还要处理“曲线会弯”和“步子该多大”这两个问题。
5. RK45 不是新墙,它只是“多看几个斜率”
RK45 里的 RK 是 Runge-Kutta。
不要先背人名。先记住它解决的问题:
一步里面只看起点斜率太粗,那就多看几个中间斜率。
你可以把一次试步想成这样:
起点斜率       k1 = f(t, y)
往前探一点     k2 = f(t + 一小段, y + 用 k1 估出来的中间状态)
再往前探一点   k3 = f(t + 另一小段, y + 用前面斜率估出来的中间状态)
继续探         ...
综合这些斜率   y_new = y + h * 加权平均斜率
这里的 k1, k2, k3, ... 仍然只是变化速度。
区别是:欧拉法只问一次“现在往哪儿走”,Runge-Kutta 方法会在一步内部多问几次“如果走到中间,方向会不会变”。
这样它对弯曲的轨迹更敏感。
RK45 里的 45 表示它在同一次试步里会构造两个答案:
- 一个四阶精度的答案
- 一个五阶精度的答案
“阶”这个词也可以先用人话理解:
步长变小时,高阶方法的误差下降得更快。
这里不需要展开完整系数表。
对建模使用者来说,最重要的是:
RK45 一边尝试前进一步,一边顺手得到了一个误差估计。
如果你去看 SciPy 文档,会看到 Dormand-Prince 这个名字。
它不是新概念墙,可以先把它理解成:RK45 具体使用的一张固定系数表,规定每个中间斜率在哪里算、最后怎么加权。
这一节的 takeaway:RK45 的核心不是名字,而是“多看几个斜率,并在同一步里估计误差”。
6. 它怎么知道这一步准不准
假设 RK45 从 t 试着走到 t + h。
它会在同一步里得到两个候选结果:

可以先把它们理解成:
-
y4:保守一点的估计 -
y5:更高阶一点的估计
如果 y4 和 y5 很接近,说明这一段曲线比较容易估,这一步大概率可信。
如果 y4 和 y5 差很多,说明这一步太冒进了,应该缩小步长重算。
这就是误差估计的来源:
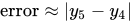
注意,这个误差不是“和真实答案的差”。
真实答案我们本来就不知道。
它是用两个不同精度的近似结果互相校验。
这一节的 takeaway:数值求解器不是知道真实答案,而是用两个近似答案的差来判断这一步靠不靠谱。
7. rtol 和 atol 是误差预算
有了误差估计,还需要一个判断标准:
差多少算可以接受?
SciPy 对每个变量大致用这个尺度:
两个名字展开一下:
-
atol:absolute tolerance,绝对容差 -
rtol:relative tolerance,相对容差
人话解释:
-
atol管变量很小时的最低精度要求 -
rtol管变量变大以后的相对精度要求
为什么要两个?
看 SIR 里的 I(t) 就知道了。
疫情刚开始时,I = 0.001 很小。
如果只用相对误差,分母太小,判断会变得很敏感;atol 可以兜底。
疫情中期,I 可能涨到 0.3 左右。
这时绝对误差 1e-9 已经太小了,主要由 rtol * |I| 来决定“相对上够不够准”。
所以容差不是代码装饰。
它直接影响求解器敢不敢迈大步。
这一节的 takeaway:rtol 和 atol 是你给求解器的误差预算;预算越小,求解器通常走得越谨慎。
8. 步长为什么会自己变
现在把一次内部试步写成伪代码:
给定当前 t、当前 y、当前步长 h

试着用 RK45 从 t 走到 t + h
得到 y5 和 y4
用 |y5 - y4| 估计误差
把误差和 atol + rtol * |y| 比较

如果误差在预算内:
    接受这一步
    t 变成 t + h
    y 变成 y5
    如果误差很小,下一步可以把 h 调大

如果误差超预算:
    拒绝这一步
    把 h 调小
    重新试
这就是“自适应步长”。
这个词如果直接扔出来会像概念墙,但它的人话解释很简单:
路平就大步走,路弯就小步走;走错了就退回来换小步。
在 SIR 里,步长变化也有现实含义:
- 刚开始
I很小,但指数增长迹象开始出现,求解器会谨慎起步 - 传播中期曲线变化快,步长不能太粗
- 后期
I逐渐接近 0,曲线变平,求解器可以走大步
这一节的 takeaway:步长不是你随便指定一个固定值,而是求解器根据误差预算动态选择的。
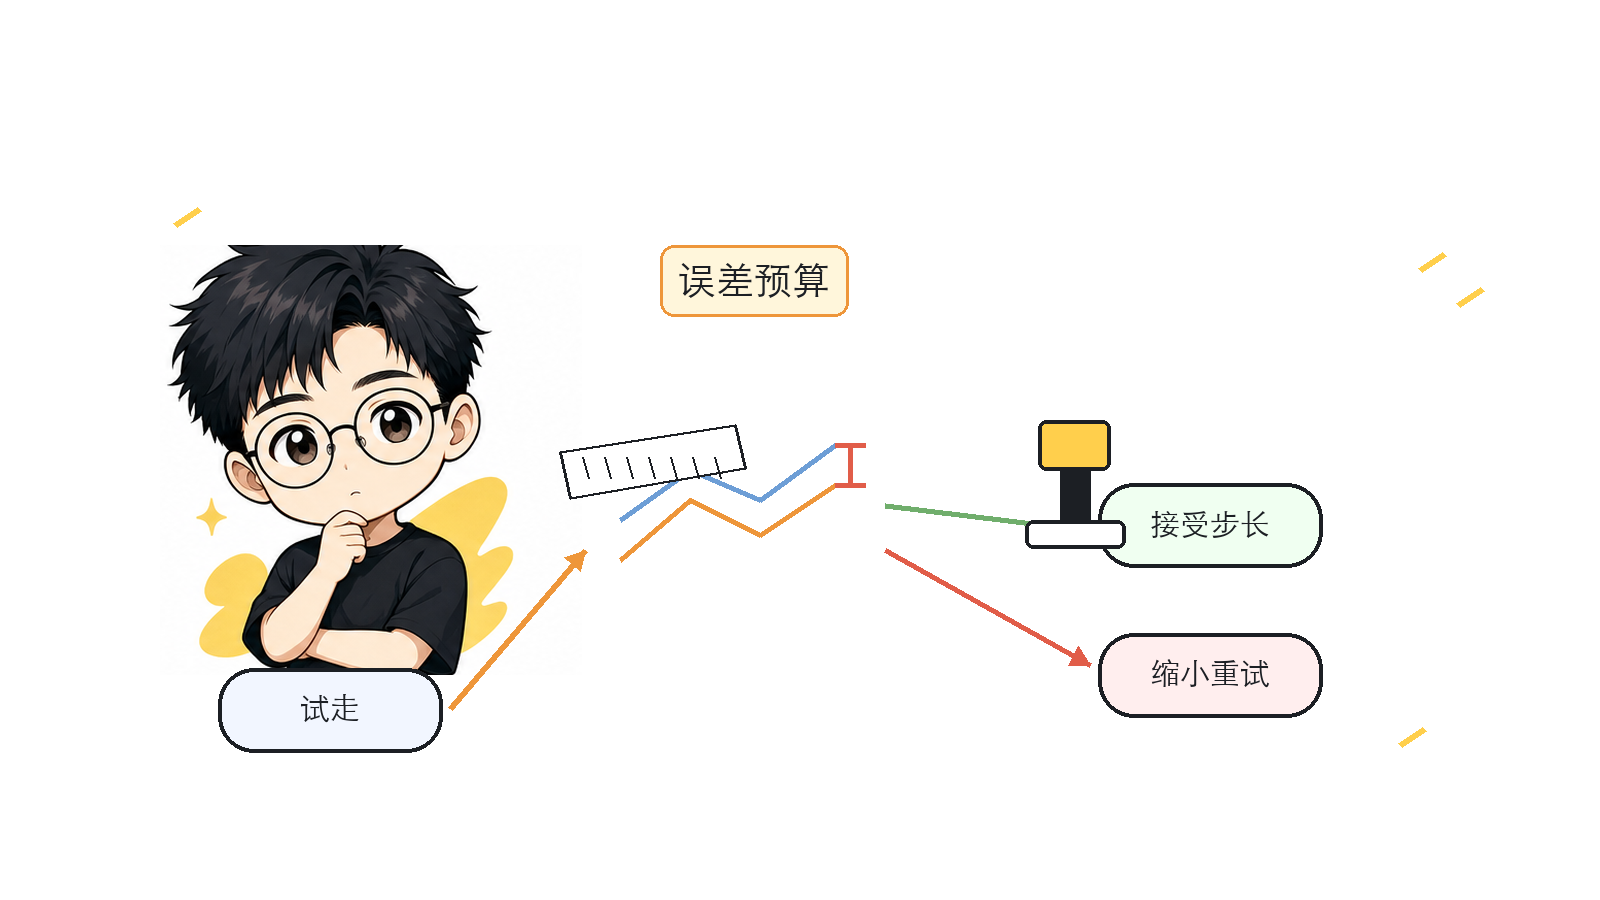
这张解释图对应 RK45 的内部动作:先试走一步,再拿误差和预算对照,最后决定接受步长还是缩小重试。
9. solve_ivp 这一层到底包了什么
现在再回头看 solve_ivp:
sol = solve_ivp(
    lambda t, y: sir_rhs(t, y, beta, gamma),
    (0, 160),
    [0.999, 0.001, 0.0],
    method="RK45",
    rtol=1e-8,
    atol=1e-11,
)
每个参数都可以用问题语言解释:
- 第一项
lambda t, y: ...:告诉求解器“给定当前状态时,变化速度怎么算” -
(0, 160):从第 0 天算到第 160 天 -
[0.999, 0.001, 0.0]:初始状态,也就是初值问题里的“初值” -
method="RK45":内部用 RK45 试步、估误差、调步长 -
rtol=1e-8, atol=1e-11:误差预算
这段代码没有说“每天算一次”。
它只说:从 0 算到 160,误差按这个标准控制。
具体中间走了多少步,是 RK45 自己决定的。
这一节的 takeaway:solve_ivp 是一个调度入口,真正反复做试步的是里面的数值方法。
10. t_eval 是拍照点,不是脚印
我们经常会加上:
t_eval = np.linspace(0, 160, 800)

sol = solve_ivp(
    lambda t, y: sir_rhs(t, y, beta, gamma),
    (0, 160),
    [0.999, 0.001, 0.0],
    t_eval=t_eval,
    method="RK45",
)
很多人会自然以为:
solve_ivp 内部就是按照这 800 个点一步一步算的。
这其实是错的。
t_eval 只表示:
最后请把结果报告在这些时间点上。
内部真实接受过哪些步子,仍然由误差控制决定。
可以这样记:
- 内部步子是脚印
-
t_eval是你想拿到照片的位置
如果照片位置不在脚印上,求解器会在已接受的内部步子之间做插值。
插值不是重新解方程,而是在已经算好的局部轨迹上补出你要看的时间点。
这一节的 takeaway:t_eval 控制输出密度,不等于控制内部计算步长。
11. 用低层 RK45 把脚印拿出来
如果只用 solve_ivp,你通常看到的是整理好的输出。
如果想观察内部脚印,可以直接用 SciPy 的低层 RK45 类。
下面这段代码和正文是一一对应的:
from scipy.integrate import RK45

solver = RK45(
    lambda t, y: sir_rhs(t, y, beta, gamma),
    0.0,                          # 初始时间
    np.array([0.999, 0.001, 0.0]), # 初始状态
    160.0,                        # 终止时间
    rtol=1e-6,
    atol=1e-9,
)

ts = [solver.t]
ys = [solver.y.copy()]
steps = []

while solver.status == "running":
    solver.step()              # 内部完成:试步、估误差、接受或缩小重试
    ts.append(solver.t)        # 接受后的真实时间点
    ys.append(solver.y.copy()) # 接受后的真实状态
    steps.append(solver.step_size) # 刚刚接受的步长
这段循环最值得看的不是类名,而是三个量:
-
solver.t:求解器真正走到的时间 -
solver.y:这个真实时间上的状态 -
solver.step_size:刚刚被接受的那一步有多长
有了这些量,solve_ivp 的黑箱就被打开了一条缝。
这一节的 takeaway:solve_ivp 适合日常求解,低层 RK45 适合观察求解器内部怎么走。
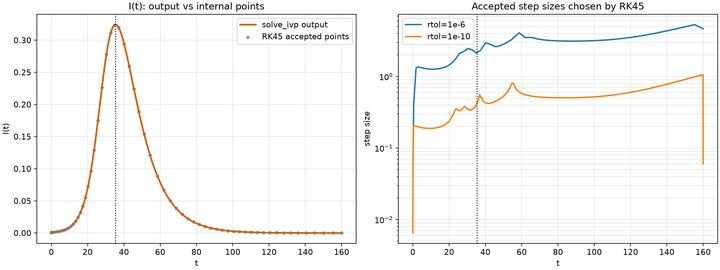
12. 图里能看到什么
运行配套脚本:
python 03_solve_ivp_inside_demo.py
会生成这张图:
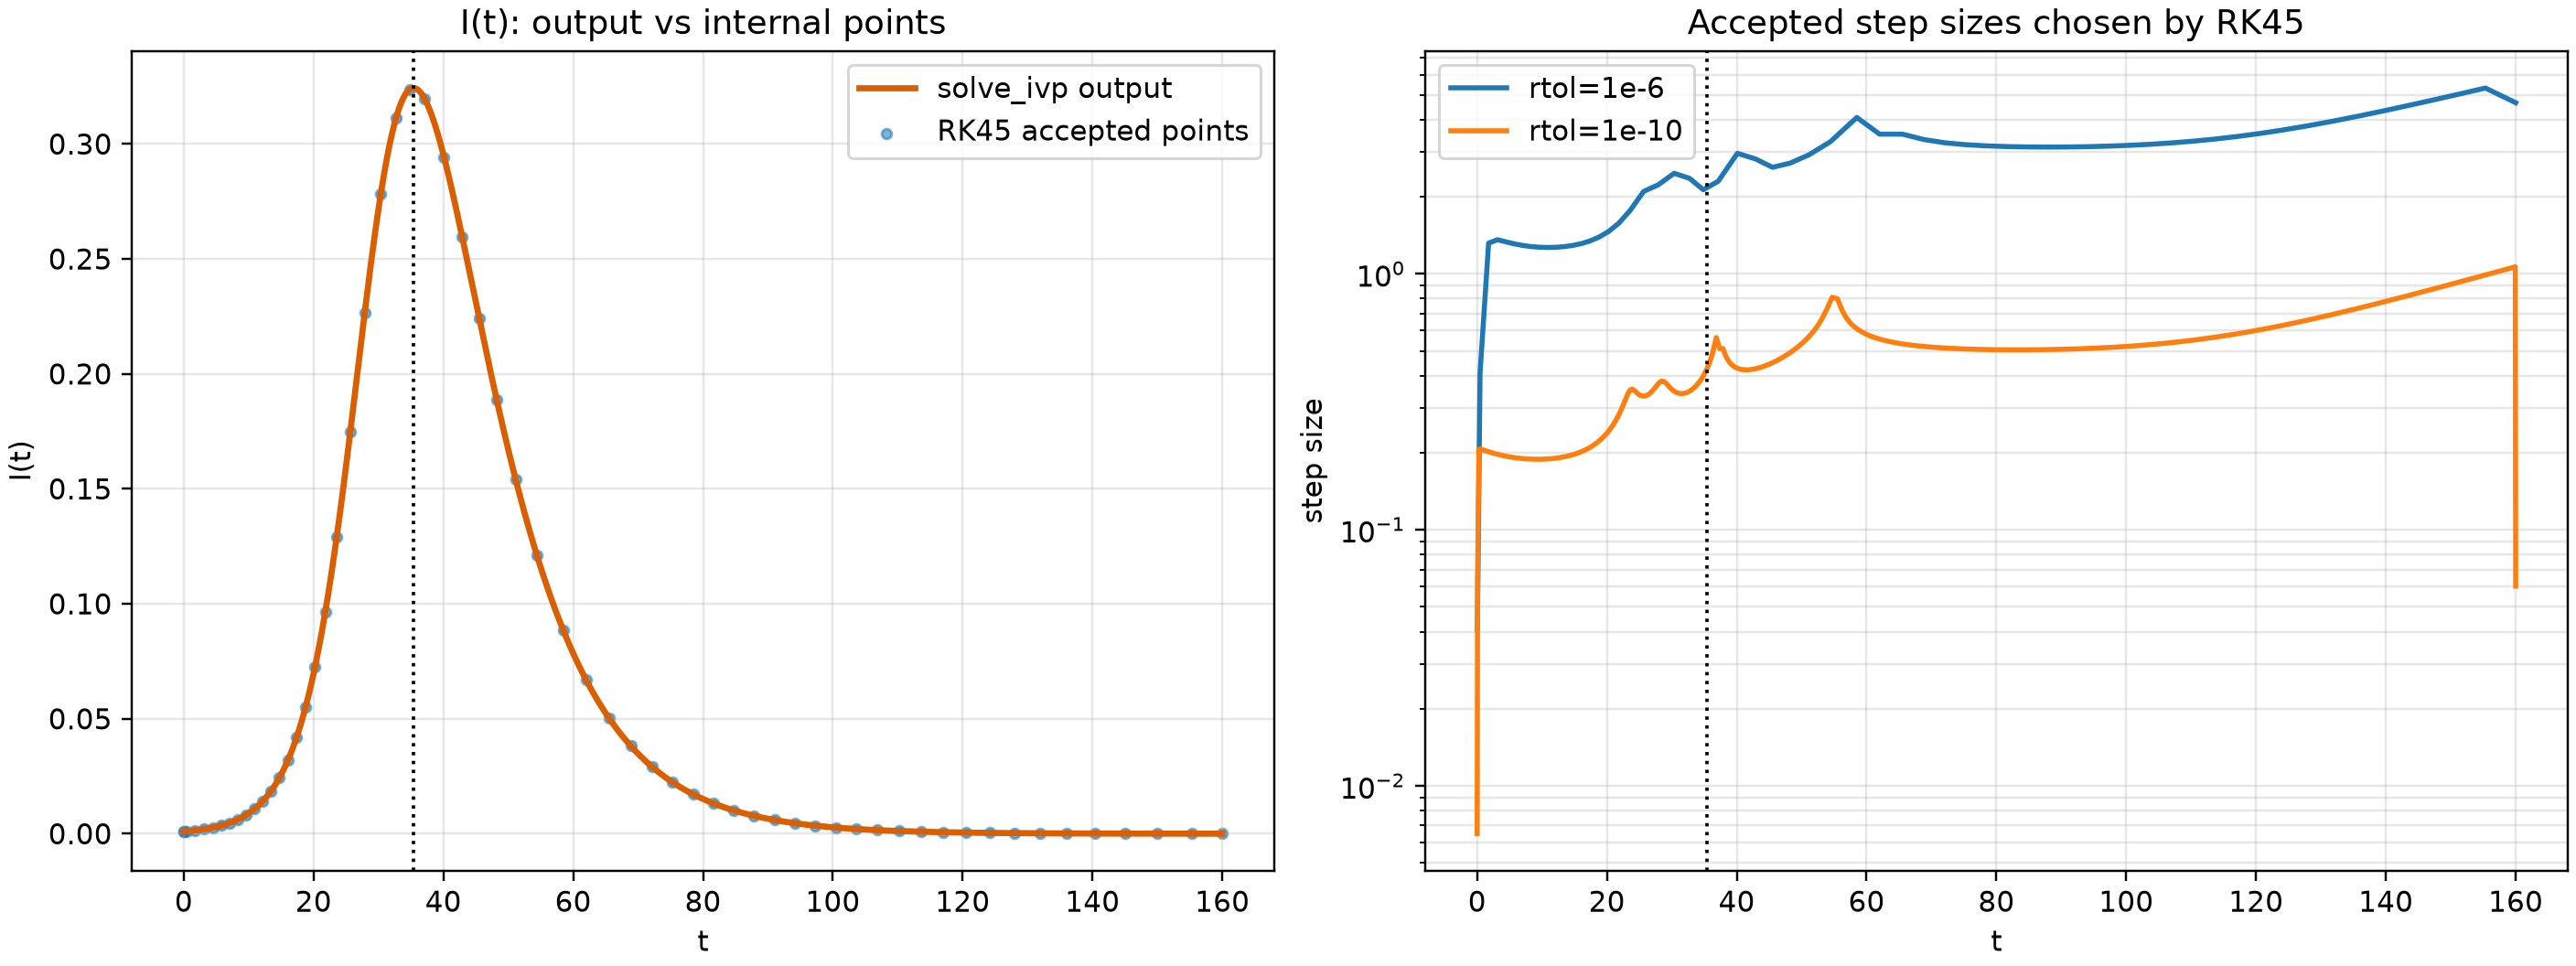
左图对比的是:
- 橙色线:
solve_ivp最后报告给你的I(t)输出曲线 - 蓝色点:宽松容差下,
RK45内部真正接受过的点 - 黑色虚线:感染者比例峰值附近的位置
右图对比的是:
-
rtol=1e-6:误差预算宽松,内部接受步数少,步长较大 -
rtol=1e-10:误差预算严格,内部接受步数多,步长较小
脚本输出类似:
saved: /Volumes/PSSD/code/Mathematical_Modeling/projects/python_differential_equations/figures/rk45_inside_sir.png
solve_ivp points: 800
RK45 loose steps: 60, min=0.0411, max=5.3161
RK45 tight steps: 361, min=0.0065, max=1.0650
peak infected I(t) = 0.3243 at t = 35.44
max population error = 1.11e-15
R_eff at output peak = 0.9946
initial infection flow = 0.00031968
initial recovery flow = 0.00010000
initial dI/dt = 0.00021968
这里最重要的对比是:
输出点有 800 个,不代表内部走了 800 步。
宽松容差下,内部只接受了约 60 步。
严格容差下,内部接受了约 361 步。
但你仍然可以拿到 800 个 t_eval 输出点,因为输出点可以由内部轨迹插值得到。
这一节的 takeaway:输出越密,不一定计算越细;真正决定计算细不细的是误差预算和内部步长。
13. 回到建模:怎么知道结果没乱跑
会调用求解器只是第一层。
建模时还要会检查结果。
SIR 有一个很自然的守恒检查:
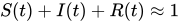
原因是模型里没有出生、死亡、外来人口。
人只是从 S 流向 I,再从 I 流向 R,总量不应该凭空变多或变少。
代码里可以这样检查:
population_error = np.max(np.abs(sol.y.sum(axis=0) - 1.0))
print(f"max population error = {population_error:.2e}")
还可以检查感染峰值。
第二篇讲过,基本再生数是:

但疫情是不是还在增长,不只看固定的  ,还要看当时剩下多少易感者:
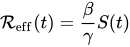
当感染者达到峰值时,I(t) 的变化速度接近 0:
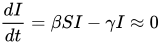
如果 I > 0,两边除以 I:

也就是:

所以峰值附近可以检查:
I = sol.y[1]
peak_idx = np.argmax(I)
S_at_peak = sol.y[0, peak_idx]
R_eff_at_peak = beta / gamma * S_at_peak

print(f"R_eff at output peak = {R_eff_at_peak:.4f}")
这个检查不要求正好等于 1。
因为我们是在离散输出点里找峰值,真正的连续峰值可能落在两个输出点之间。
但它应该接近 1。
这一节的 takeaway:不要只看图漂不漂亮,要用模型自身的结构做 sanity check。
14. 什么时候该对 solve_ivp 提高警惕
这篇不是要把你变成数值分析专家,而是让你知道哪里可能出问题。
实际建模里,下面几种情况要多看一眼:
-
sol.success是False:求解器明确说没成功 -
S、I、R出现明显负数:模型或容差可能有问题 -
S + I + R明显偏离 1:右端函数或数值精度可能有问题 - 改小
rtol、atol后结果变化很大:原来的容差可能太松 - 步长长期被压得极小:模型可能变化尺度差异很大,需要换方法或重新缩放变量
最后一条有时会牵出“刚性方程”这个术语。
先不用急着背。
人话理解就是:
系统里有的量变化特别快,有的量变化特别慢,显式一步步试走的方法会被快变量拖住。
遇到这种情况,再去看 Radau、BDF 这类方法就有动机了。
这一节的 takeaway:知道 solve_ivp 怎么走,你才知道什么时候该信它、什么时候该检查它。
15. 小结
把这一篇压成一句话:
solve_ivp 是在解初值问题:从初始状态出发,用右端函数给出的当前变化速度,一步步试走、估误差、调步长,最后把结果报告到你要看的时间点。
如果只记六句话,就记这六句:
-
ivp是initial value problem,核心是“给起点,往后推” - SIR 的方程右边返回的是当前变化速度,不是未来答案
- 最朴素的数值思想是
y_next = y + h * f(t, y) -
RK45在一步里多看几个斜率,并用四阶/五阶两个结果估误差 -
rtol和atol是误差预算,决定步长能不能放大 -
t_eval是输出拍照点,不是求解器内部脚印
下一篇如果继续写,我们就可以用这个理解去看 Lotka-Volterra 捕食-被捕食模型。
到那时,相图里的每一个箭头,本质上还是一句话:
当前状态告诉你下一步往哪里走。