
Agentic、verifiable、统一标准环境,对于评测大模型未来解决真实数学建模问题的长程能力,或者把数学建模任务作为 RL envs 去用强化学习优化模型,都有非常重要的意义。
如果只看普通数学题,今天的大模型已经很强了。
给一道 AIME,给一道证明题,或者给一道高中竞赛题,我们通常能把问题压缩成一句话:最后答案是多少?
但真实世界里的数学不是这样工作的。真实世界不会把变量、假设、目标函数、约束、数据清洗、求解器、图表和结论都整理好,再温柔地问你“请选择 A、B、C、D”。
真实世界更像数学建模竞赛:你拿到一份很长的题面,一堆附件,一个含糊但重要的问题,然后要在有限时间里决定:
- 这个问题到底该抽象成什么数学对象?
- 该用微分方程、优化、统计建模、图论网络,还是综合评价?
- 数据可信不可信?缺失值怎么办?单位有没有坑?
- 代码跑出来的数值是不是可复现?
- 最后怎么写成一份人能看懂、也经得起检查的报告?
这就是我们做 TB-MathModel 的原因。
项目地址:https://github.com/wxj630/terminal-bench-math-modeling
一句话说,TB-MathModel 是一个 Terminal-Bench-style 的数学建模 agent benchmark:它把完整的 CUMCM/MCM 竞赛题放进容器化终端环境,让模型像一个真正的 agent 一样读题、读附件、写代码、跑计算、产出结构化结果,并由可执行 verifier 自动检查关键数值。
更谨慎地说,据我们所知,它是第一个把完整竞赛式数学建模问题做成 agentic + verifiable + terminal benchmark 这种形态的 benchmark。
1.为什么是数学建模?
数学建模是应用数学进入真实世界的一条主干道。
普通数学题经常是“方程已经在那里,你来解”。数学建模则是“现实问题在那里,你先把方程造出来”。
这一步听起来轻,但其实最难。
比如同样是“交通问题”:
- 预测明天车流量,可能是时间序列或回归;
- 安排车辆路线,可能是车辆路径问题(VRP)或混合整数规划;
- 研究拥堵传播,可能是动力系统或元胞自动机;
- 找关键路口,可能是图论网络;
- 评估交通政策,可能是多目标优化或综合评价。
所以数学建模不是某一个窄任务。它天然横跨很多数学分支和应用领域:
- 解析几何与方程:距离、角度、覆盖、碰撞、三维姿态;
- 微分方程与动力系统:生态、传染病、交通流、人口演化;
- 运筹优化:生产、排程、选址、路径、资源配置;
- 数据建模:回归、分类、聚类、时间序列、机器学习;
- 图论网络:最短路、最大流、匹配、传播;
- 综合评价:AHP、熵权、TOPSIS、DEA、多准则决策;
- 仿真与 Monte Carlo:不确定性、风险、复杂系统。
这也意味着数学建模非常适合测试长程 agent。
一个模型如果只是会聊天,不够。它要能长期保持上下文,读懂题面和附件,选择合适的数学模型,写可运行代码,处理文件和依赖,生成图表,把结果落到指定位置,还要写出能自圆其说的解释。
这几乎是“大模型作为工作流 agent”的现实版。
加之我对这领域也比较熟悉,2020年就有在知乎分享相关内容
python数学建模实践<h2>2.数学建模为什么难评?</h2><p data-pid="j3Qy5QON">因为它通常没有唯一标准答案。</p><p data-pid="iV7EuSEC">一道数学建模题可以有很多合理假设。不同队伍可能选不同模型:有人用线性规划,有人用非线性优化,有人用仿真,有人用机器学习。只要假设清楚、计算可信、结论有用,都可能是一份好论文。</p><p data-pid="FwEYsZ0u">这就带来一个评测困境:</p><ul>
</ul><p data-pid="3GO_vLMU">TB-MathModel 的选择是:先把评测锚到可检查的数值核心上。</p><p data-pid="P_8p2xow">每道题要求 agent 最终写出:</p><div class="highlight"><pre>/root/results/<task-slug>_result.json
</pre></div><p data-pid="w8lafKAU">verifier 不读整篇报告的文采,而是抽取最后一问最关键的数值字段。例如:</p><ul>
</ul><p data-pid="CxN7EteC">这些字段来自题目最终结论,是数学建模报告里最能被复现、被比较的一部分。</p><h2>3.Outstanding-Eval:先问离优秀论文有多近</h2><p data-pid="aaa9JmxQ">我们用 O 奖论文复现答案作为 oracle anchor,也就是 O。</p><p data-pid="_N1krjD4">这里的 O 不是“宇宙唯一真理”,而是“优秀论文复现出来的一组强参考答案”。在数学建模里,这个定位很重要:我们不是说只有 O 的答案才合理,而是需要一个可复现、可比较的高质量锚点。</p><p data-pid="pNIj685A">每道题先得到一个 Direction-Aware raw score。所谓 direction-aware,就是每个数值先看语义方向:</p><ul>
</ul><p data-pid="I0rSA28p">然后主指标 O-Eval 很直接:</p><div class="highlight"><pre>本题 O-Eval = 模型 direction-aware raw / O raw
</pre></div><p data-pid="LLqyD6Ql">最后对 18 道题平均。</p><p data-pid="_WzXKReX">大白话说:O-Eval 衡量一个模型平均能达到 O 奖复现答案的多少比例。
100% 约等于平均达到 O 奖锚点;80% 约等于平均有 O 奖锚点的八成。</p><h2>4.Robust BO-Eval:再问比便宜 baseline 多追回多少</h2><p data-pid="1_vBE2cW">只看 O-Eval 还不够。我们还想知道:模型相对便宜 baseline 到底有没有稳定进步?</p><p data-pid="7dL_v8oj">于是有 B,也就是 v4 flash baseline。传统 BO-only 直觉是:</p><div class="highlight"><pre>BO-Eval = (模型 raw - B raw) / (O raw - B raw)
</pre></div><p data-pid="IiXcwg4R">它问的是:从 baseline 到 O 的这段距离,模型追回了多少?</p><p data-pid="uTOpRf6N">但原始 BO-Eval 有一个坑:如果 O 和 B 非常接近,分母很小,模型只要多一点点 raw 增益,比例就会炸。我们在分析里就见过类似 37 对 32 的小分母情况,能把单题拉成几百甚至八百多个百分点。这个指标好玩,但不能当主排名。</p><p data-pid="KRpGNLQb">所以我们引入 Robust BO-Eval:</p><ul>
O raw - B raw >= 0.10,用追回比例,但截到 ±100%;模型 raw - B raw 截到 ±10pp;</ul><p data-pid="JHcw3Gif">大白话说:O-Eval 是绝对成绩单,Robust BO-Eval 是相对便宜 baseline 的稳健增益表。</p><h2>5.和已有 benchmark 有什么不同?</h2><p data-pid="rj_glHrG">这里要先给已有工作一个公允位置。</p><p data-pid="SL7xRo9u">Mamo 是很重要的前置工作。它用 solver-grounded 的方式评估数学建模,覆盖 ODE、LP、MILP 等任务,能自动检查模型生成的形式化结果。它的强项是可验证。但它主要测的是形式化片段和 solver-facing artifact,不是完整竞赛式建模 workflow。</p><p data-pid="riEJkI1F">ModelingAgent / ModelingBench 往真实数学建模竞赛迈了一大步。它强调 open-ended real-world modeling,让模型完成问题分析、工具使用、结构化报告,并用 ModelingJudge 做多专家视角评估。它的强项是开放性和报告级评价。但主要信号仍是 report-level judge,自动 verifier 的可复现性没那么强。</p><p data-pid="ylI83a9d">MM-Agent / MM-Bench 进一步把数学建模拆成问题分析、结构化建模、计算求解、报告生成等阶段,还引入层级数学建模方法库。它的强项是 agent workflow 和建模知识检索。但 MM-Bench 的主评测仍偏竞赛式报告 rubric,而不是每题标准化输出 + 可执行 verifier。</p><p data-pid="jmImHcak">TB-MathModel 想补的是这个空位:</p><table data-draft-node="block" data-draft-type="table" data-size="normal" data-row-style="normal"><tbody>
</tbody></table><p data-pid="yta7-VZv">Terminal-Bench 这种形式有几个特别实用的优点:</p><ol>
</ol><p data-pid="2bfuMrB2">这点很关键。很多数学建模失败不是“模型不会公式”,而是 workflow 某一环断了:读错附件、单位错了、优化目标写反、依赖缺失、结果没有按 schema 输出。Terminal-Bench-style benchmark 能把这些失败暴露出来。</p><p data-pid="ZqnH3g0A">更往前看,agentic、verifiable、统一标准环境这三件事放在一起,意义不只是做一个排行榜。它让我们可以更可靠地评测大模型未来解决真实数学建模问题的长程能力:同一份题面、同一套附件、同一个容器环境、同一个输出协议、同一个 verifier,模型到底能不能把问题完整做完,一眼就能复现和比较。</p><p data-pid="Wmf3ZNfq">这也让 TB-MathModel 不仅可以作为搜集轨迹去后训练大模型(我们沿用了terminal bench官方的terminus-2 agent,支持保存agent轨迹),更可以成为强化学习环境。数学建模能力不是单步问答能力,而是长程策略能力:什么时候检索,什么时候写代码,什么时候调用优化器,什么时候检查单位,什么时候重跑实验,什么时候停止并输出结论。把这些任务做成可执行环境和可验证奖励之后,就可以作为 RL envs,用来训练和优化模型的数学建模 workflow,而不只是事后评价模型写出来的报告像不像。</p><h2>6.当前任务集:三年十八题</h2><p data-pid="Lqk7WpjR">当前 TB-MathModel 覆盖 2023、2024、2025 三年 CUMCM/MCM 的 A/B/C 题,共 18 道, 后面我们也会随着比赛更新而更新(2026美赛出了,2026国赛是在9月份比赛还没出):</p><ul>
</ul><p data-pid="Yjd6xH3W">下面是 18 题的一句话版:</p><ol>
</ol><p data-pid="8c1hUQh9">这 18 道题覆盖了几乎所有常见数学建模题型:解析几何、微分方程、运筹优化、统计建模、机器学习、图论网络、综合评价、Monte Carlo 仿真。对 agent 来说,这不是单点能力测试,而是一次小型真实工作流测试。</p><h2>7.当前模型结果</h2><p data-pid="wwD4IxlY">下面是 18 题 O-Eval 主指标的结果图,主要是国产御三家(deepseek, kimi, glm)+ 国外御三家中的两家(OpenAI+Gemini, Claude是在是没有api就没评)。我们后面也会随着新模型发布一直更新这个bench。</p>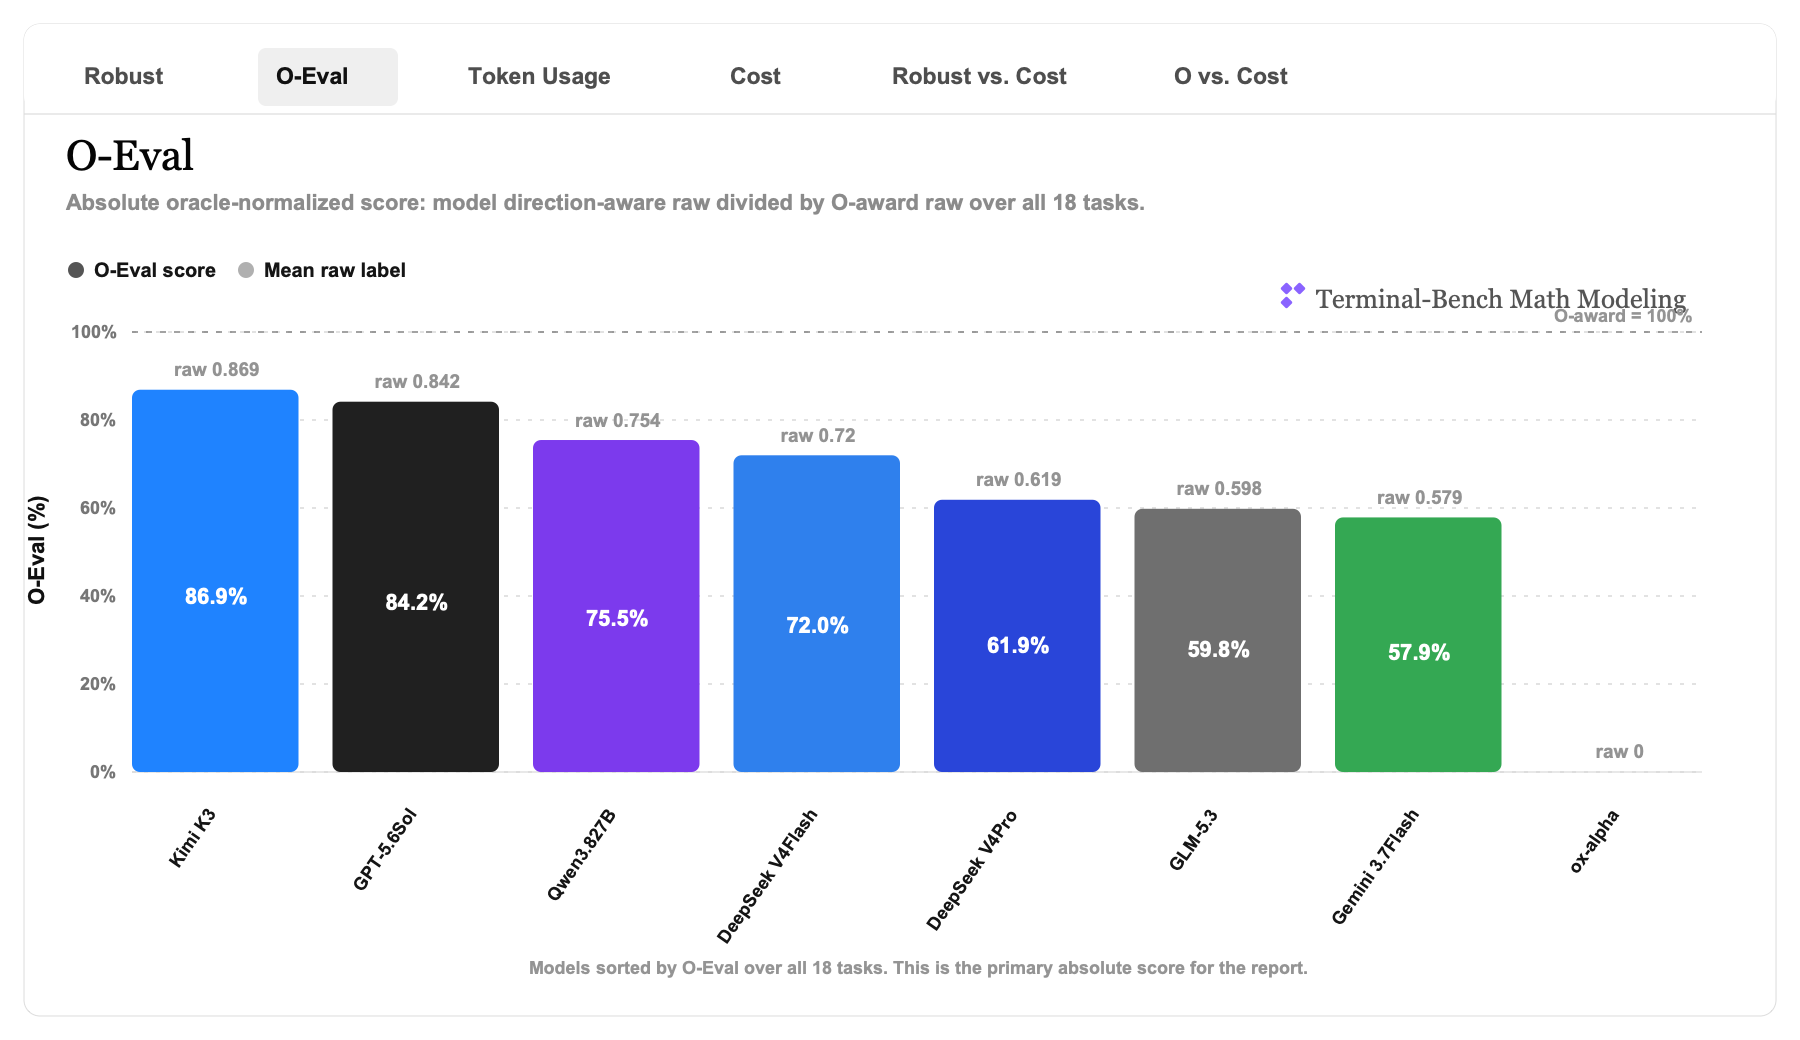
</p><p>
</p><p data-pid="7d0nzMaM">当前主排名按 O-Eval 看:</p><ul>
</ul><p data-pid="GfJwAzh0">这个结果的读法是:Kimi K3 和 GPT-5.6 SOL high 在 18 道题上平均最接近 O 奖复现锚点;Qwen3.8 27B 的表现也明显超出参数规模直觉;Gemini 因为缺了部分 artifact,被覆盖率直接拉低。</p><p data-pid="00Y7BvzH">再看 O-Eval 和成本的关系:</p>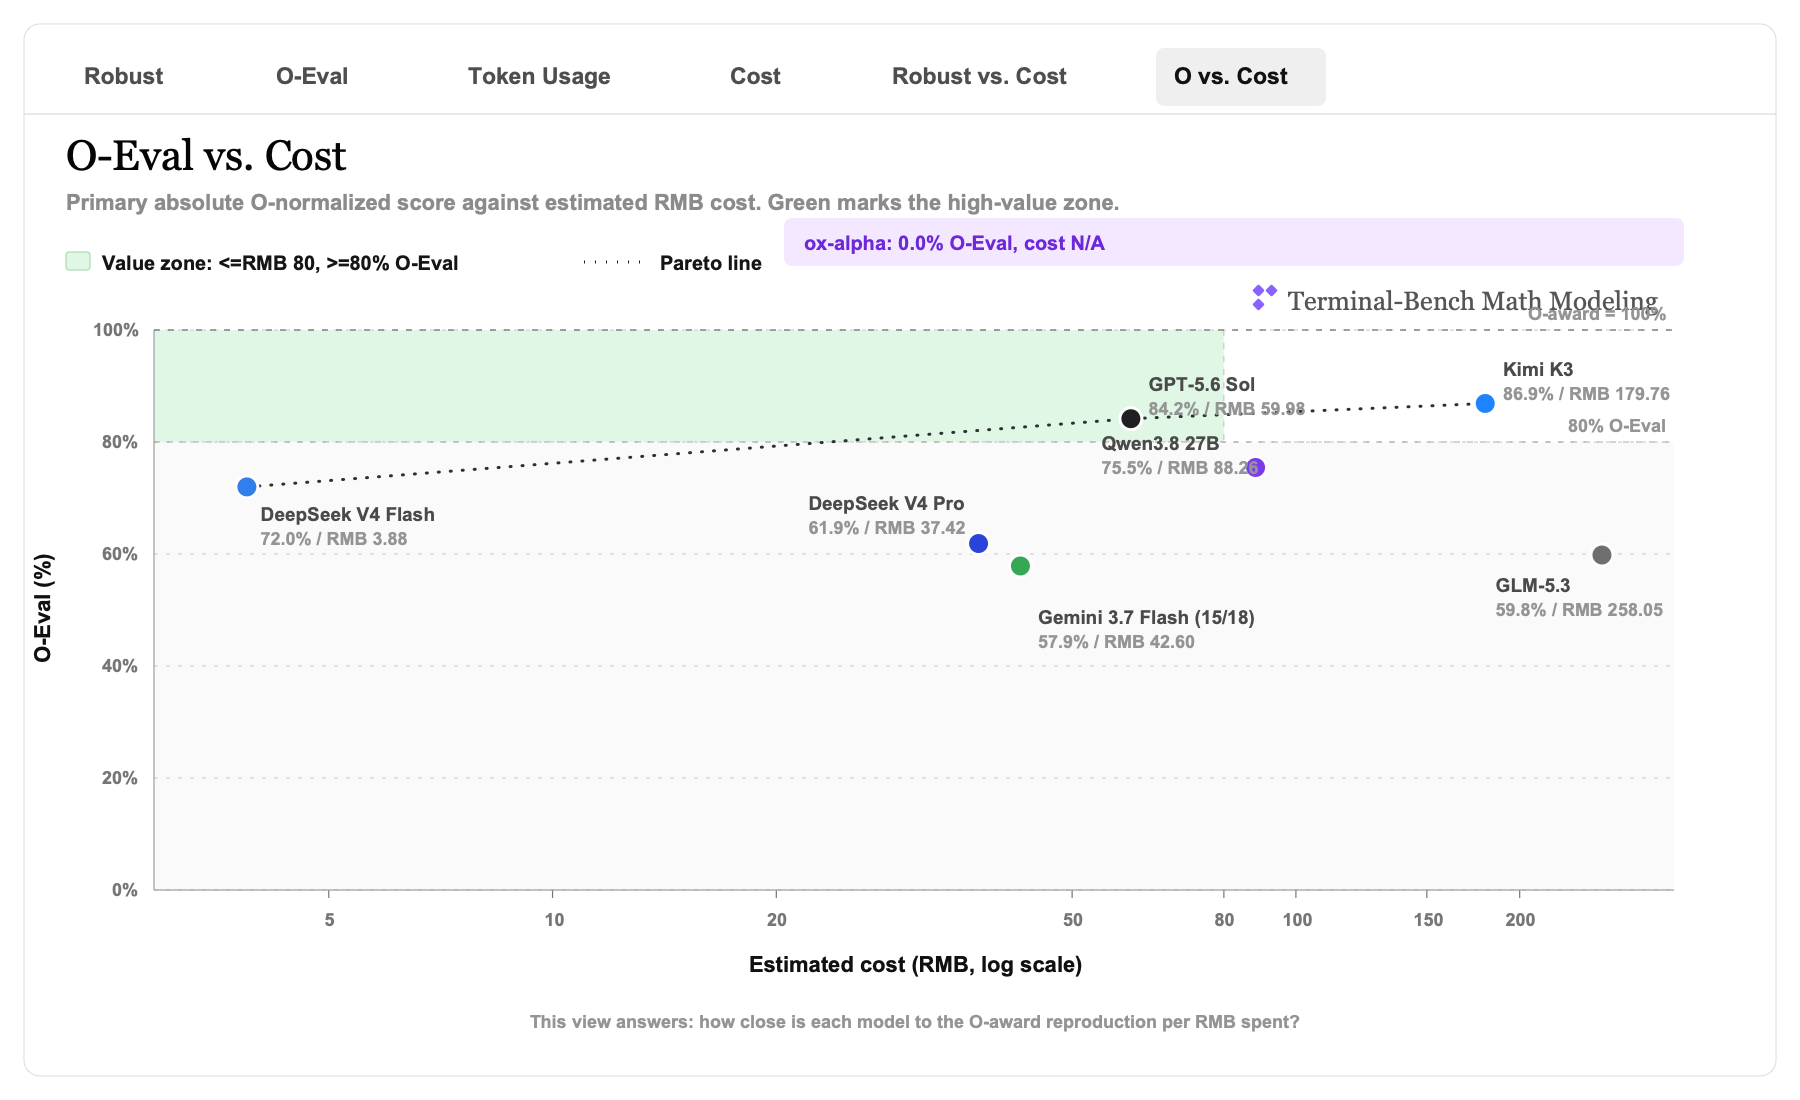
</p><p data-pid="nB1DpGxl">这张图回答的是另一个问题:不只是“谁最高”,还要看“花多少钱做到这个分”。在实际 agent benchmark 里,cost 很重要,因为数学建模是长程任务,token 和工具调用会迅速放大。</p><p data-pid="r5MIV9yY">Robust BO-Eval 用来观察相对 v4 flash baseline 的稳健增益:</p>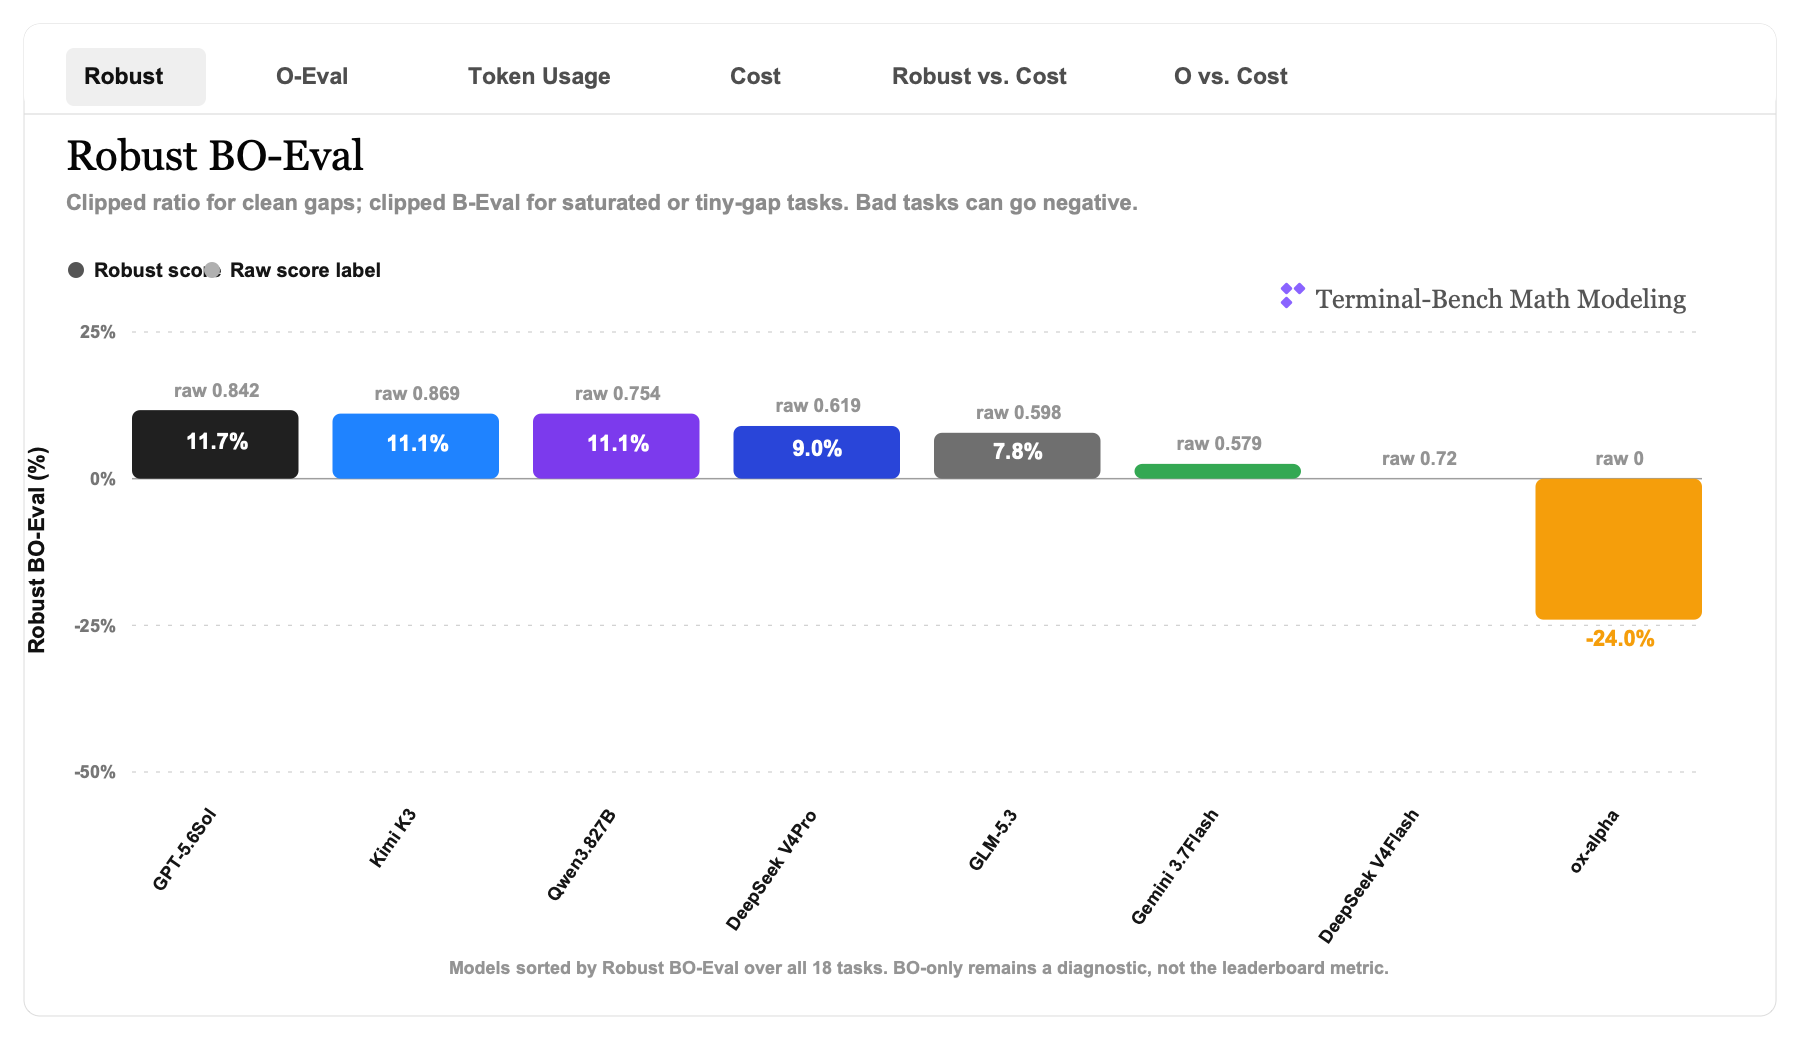
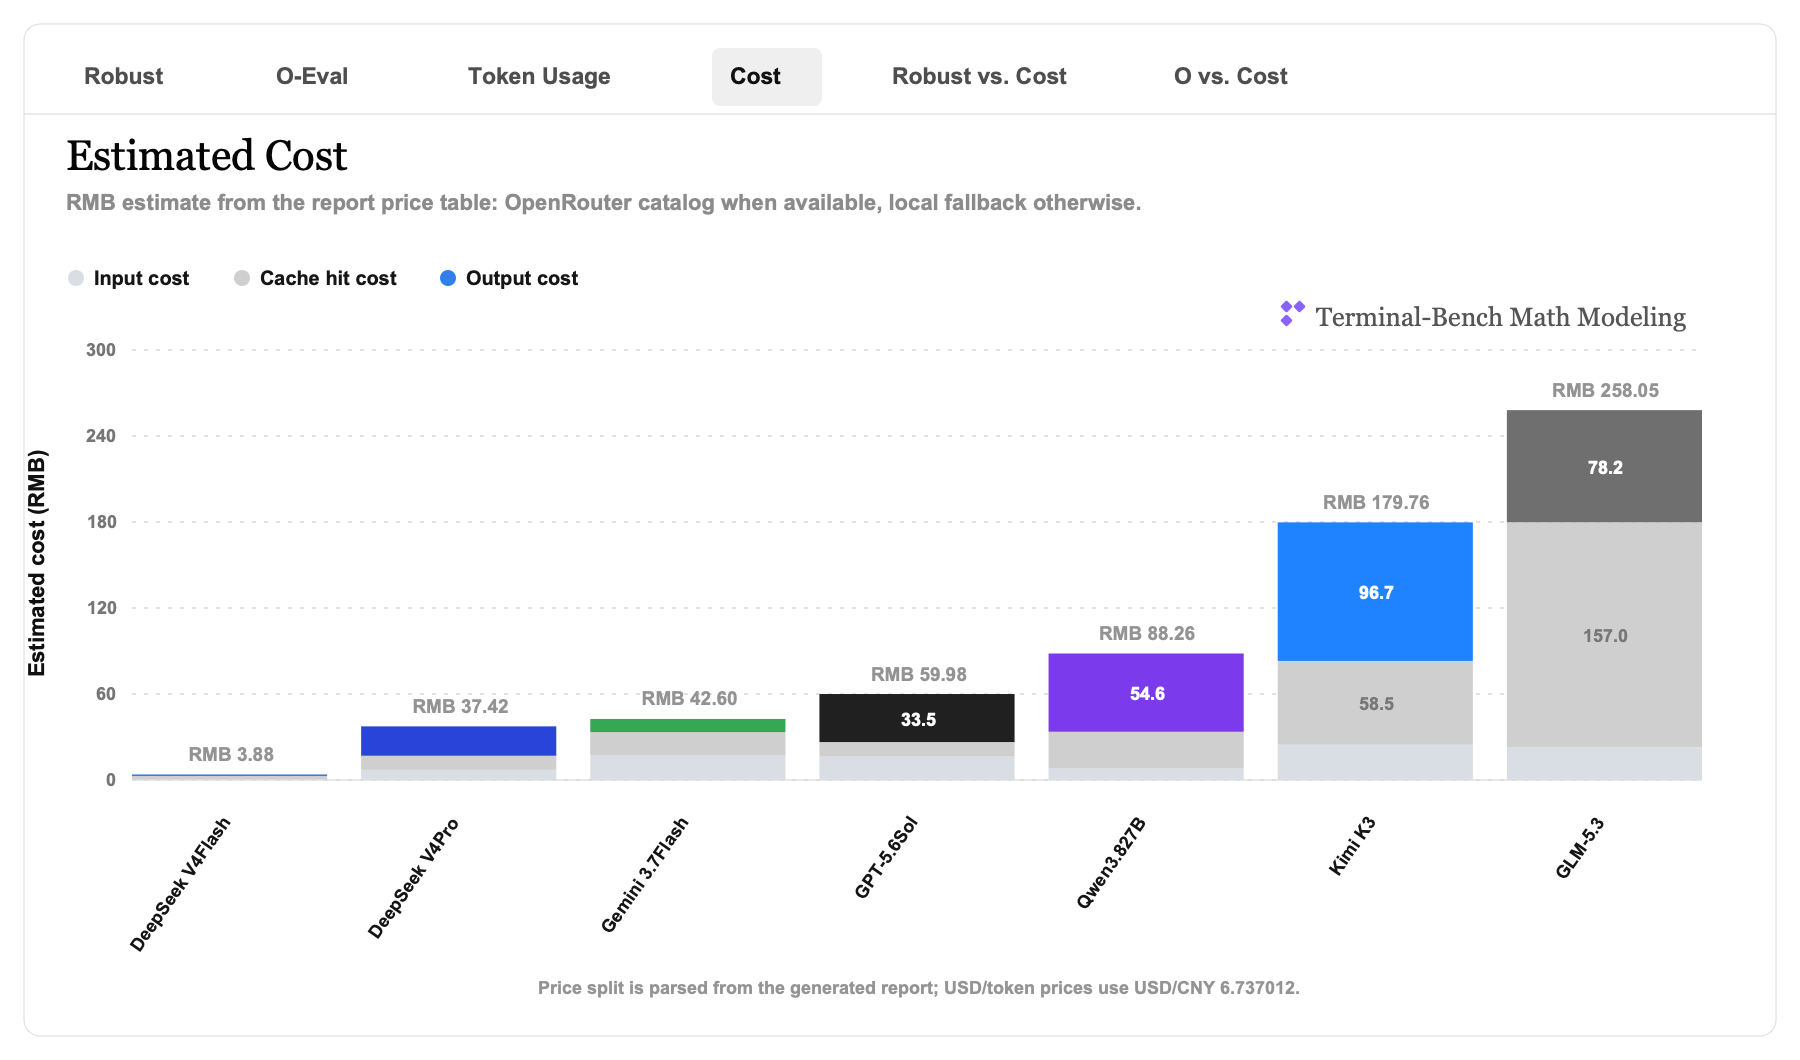
</p><p data-pid="SL3idAEn">这里 GPT-5.6 SOL high、Kimi K3、Qwen3.8 27B 都处在第一梯队。和 O-Eval 不同,Robust BO-Eval 更像“在 baseline 弱项上能追回多少”,所以它适合做辅助分析,而不是唯一主榜。</p><p data-pid="quY4Uoxf">token 和 cost 也值得看:</p>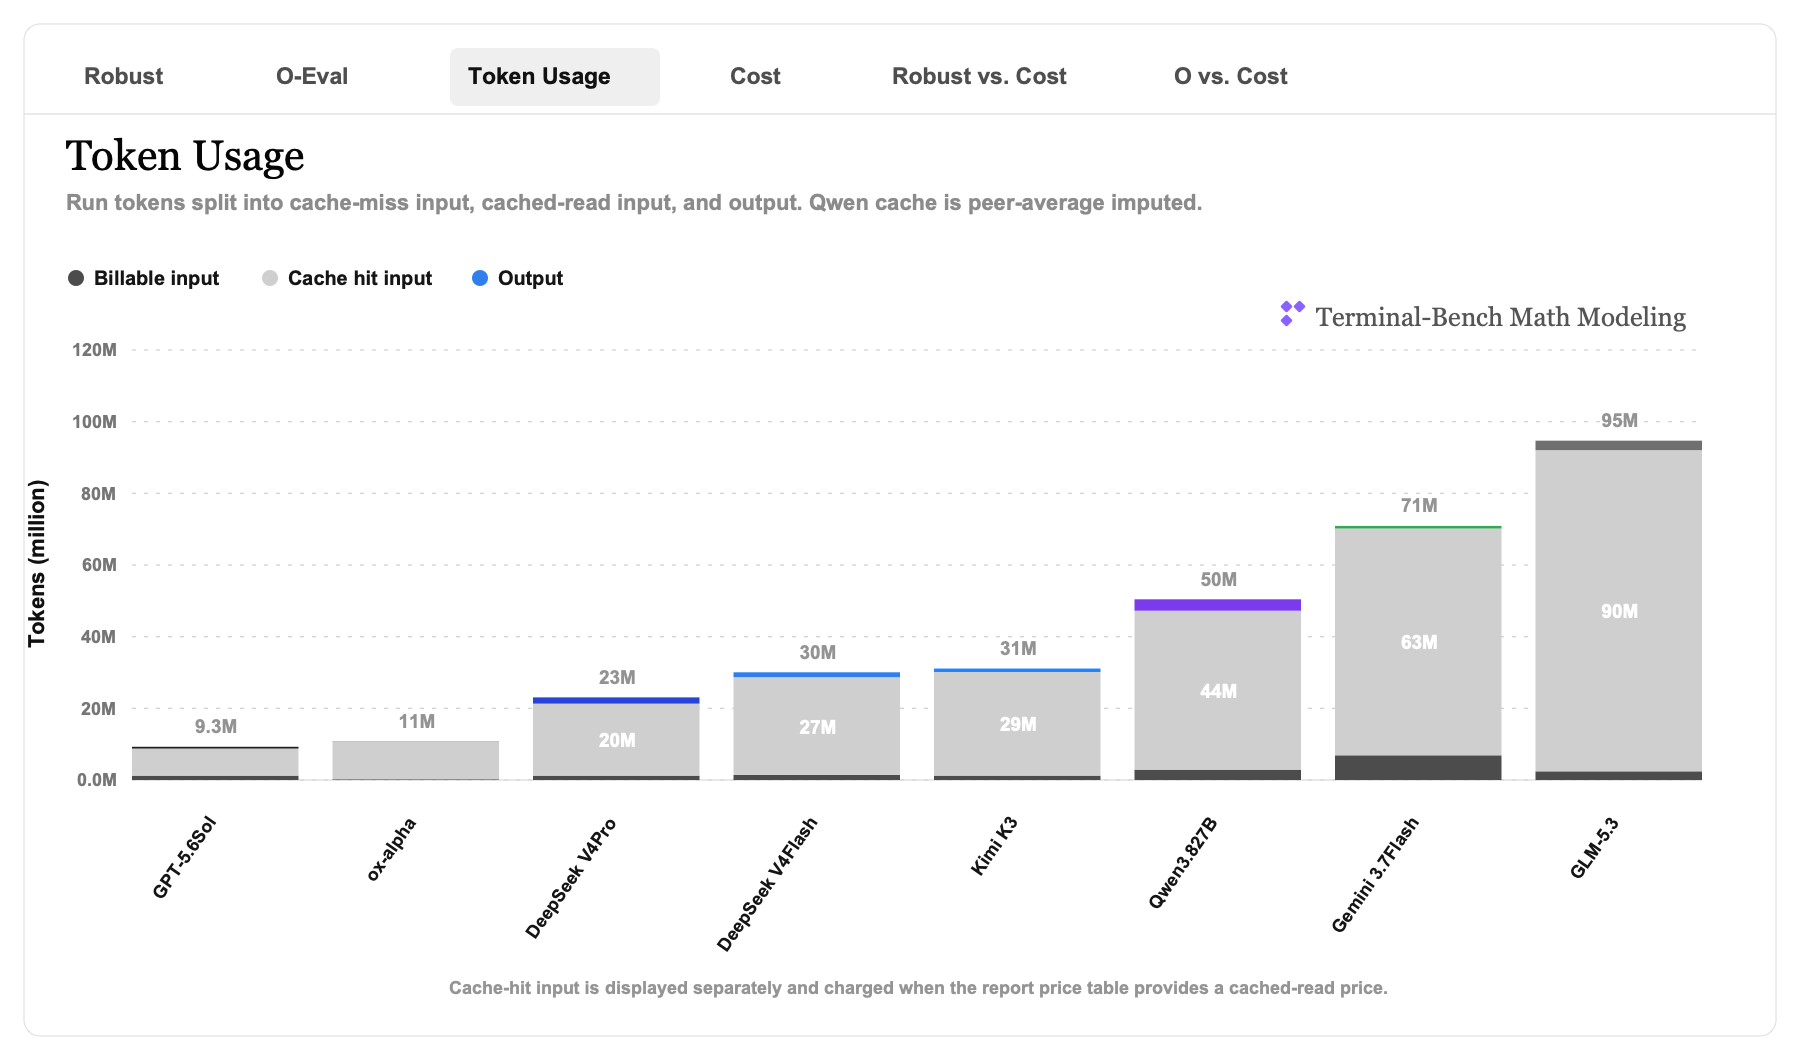
</p><p>
</p><p data-pid="m-zwz88D">有些模型效果不错但成本很高,有些模型便宜但覆盖或稳定性不足。数学建模 benchmark 不能只报 accuracy,因为真实 agent 服务里,长上下文、重试、代码执行、缓存命中率都会影响可用性。</p><h3>这个 benchmark 不是想替代报告评审</h3><p data-pid="ZmYDY-aT">最后强调一点:TB-MathModel 不是说数学建模只剩最后几个数字。</p><p data-pid="DfUmjwAJ">真正好的数学建模当然包括问题理解、假设设计、模型合理性、敏感性分析、可视化和论文表达。只是如果我们想做一个可复现 benchmark,就必须先把其中一部分落到 verifier 能检查的 artifact 上。</p><p data-pid="SI3se9KR">我的看法是:数学建模评测最终应该是分层的。</p><ul>
</ul><p data-pid="6_YnbzPT">TB-MathModel 当前先把前两层做扎实:agentic workflow + verifiable numeric core。后续可以继续叠加报告级 rubric、人类评审和轨迹审计。</p><h2>8. 结语</h2><p data-pid="pZVmyKbI">数学建模是一个很好的 LLM agent 试金石。</p><p data-pid="U_cKurDH">它不像短数学题那样只考一个答案,也不像纯代码题那样只考程序能不能跑。它要求模型把真实问题变成数学对象,把数学对象变成可计算程序,把程序结果变成可信结论,再把结论写成人能理解的报告。</p><p data-pid="G9hE4e04">这正是长程 agent 最该被测试的地方。</p><p data-pid="e0JptgH8">所以我们把 TB-MathModel 定位为:</p><blockquote data-pid="ZTn4pcz7"> 第一个 Terminal-Bench-style、面向完整竞赛式数学建模的 agentic and verifiable benchmark。</blockquote><p data-pid="0eFkLIJY">第一篇先介绍整体动机、指标和初步结果。第二篇我会把 18 道题逐题展开:每道题到底问什么,O 奖答案是什么,各个模型用了什么数学模型,又主要靠什么库和求解器把结果算出来。</p><h2>参考:</h2><ul>
</ul>