
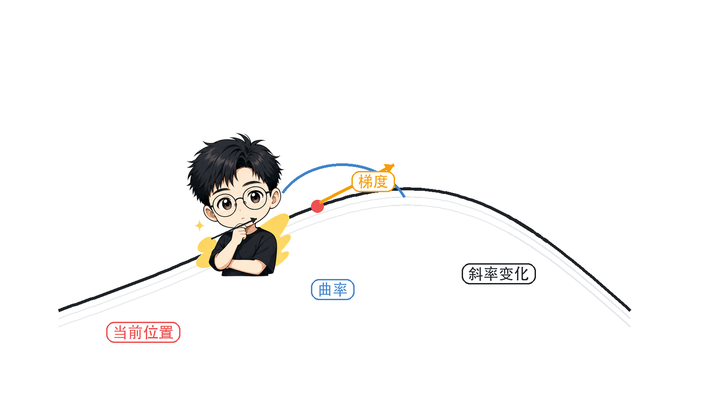
训练神经网络的时候,我们常说“换个优化器试试”。SGD 不行换 AdamW,AdamW 不稳调学习率,最近又有人把 MLP 和 Attention 的矩阵权重交给 Muon。
但优化器到底在做什么?
最直观的答案是:每一步都要回答一个问题。
现在参数在这里,loss 在这里,我应该往哪个方向走、走多远,才更可能让 loss 下降?
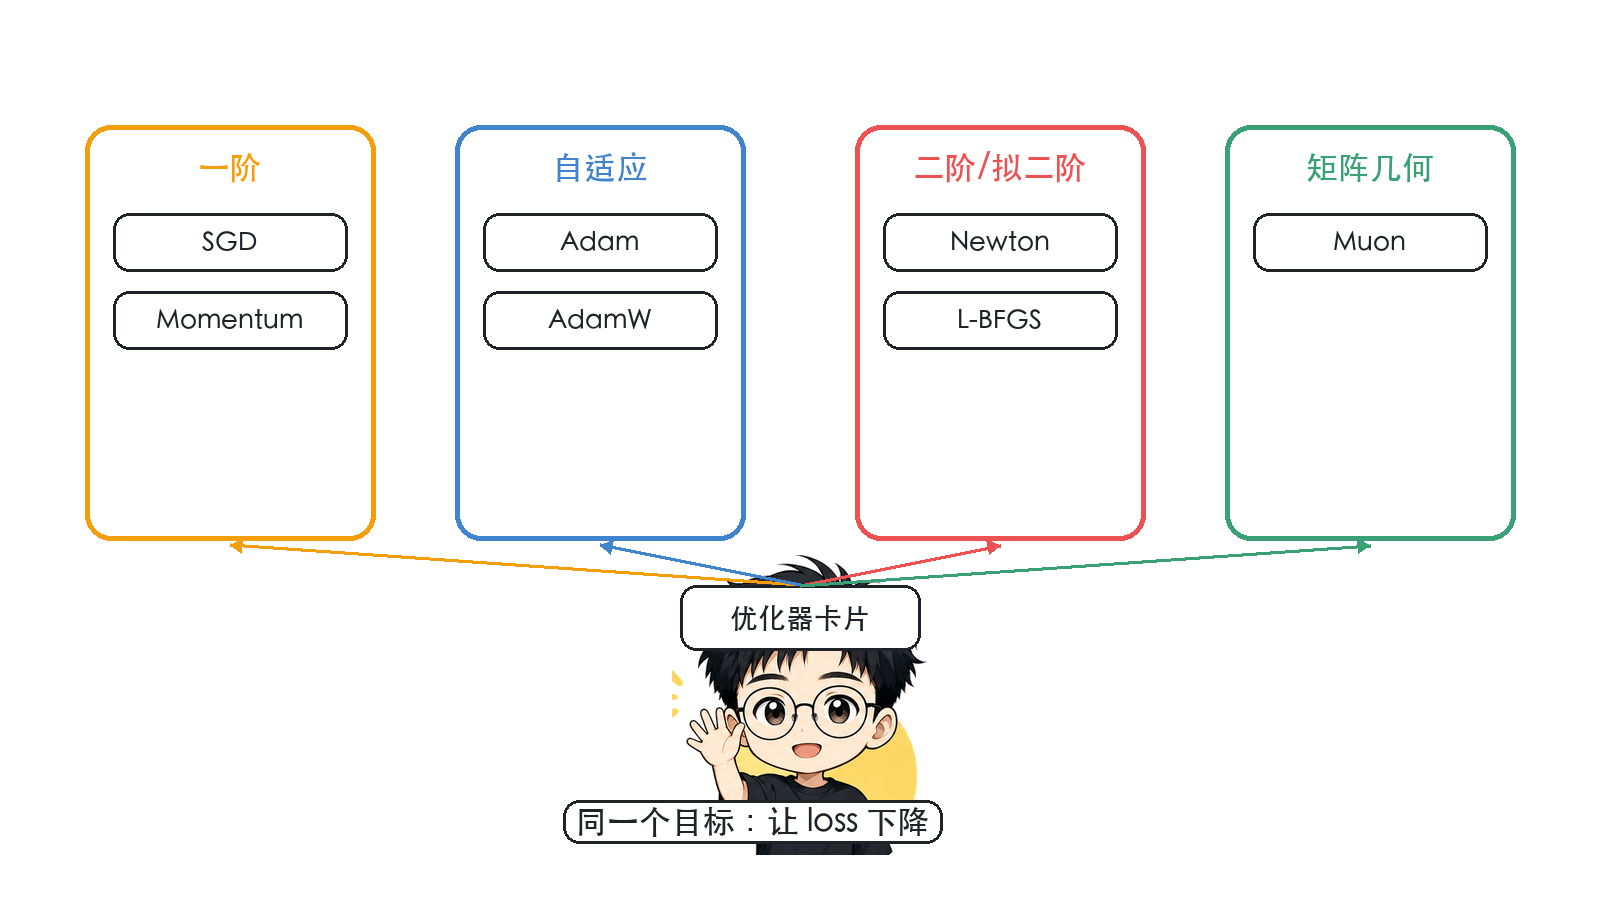
这篇先不急着提出新优化器。我们先把传统数值优化和深度学习优化器放到同一张地图上:梯度、曲率、Hessian、牛顿法、动量、Adam、AdamW、Muon,各自到底在利用什么信息。
如果你想找一个工程上的入口,scipy.optimize 是很好的目录。它把无约束最小化、有约束最小化、全局优化、最小二乘、求根、线性规划、分配问题、混合整数线性规划等常见工具放在一起。
但要注意,它是一个非常实用的工具箱目录,不是“最优化学科的全部”。最优化还包括凸优化、组合优化、随机优化、鲁棒优化、最优控制、动态规划、变分法、大规模混合整数优化、PDE 约束优化、分布式训练优化等很多方向。SciPy 适合帮你建立第一张地图,但真实问题会继续往外长。
1. 最优化的基本问题:选择一次更新
最优化问题最常见的写法是:

 是决策变量。在神经网络里,它就是模型参数;在运筹优化里,它可能是产量、路径、排班、库存;在控制论里,它可能是控制输入或轨迹。
 是目标函数。深度学习里常叫 loss,运筹优化里常叫成本、收益的负数、总时间、总能耗。
很多最优化问题还有约束:
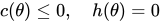
所以一个优化模型通常有三要素:决策变量、目标函数、约束条件。深度学习训练常被写成无约束问题,但正则化、梯度裁剪、投影、参数化约束,本质上也在控制可行更新的范围。运筹优化更常显式写约束,比如容量、预算、路径、排班规则。控制论则会把“时间演化”也写进约束里,比如:
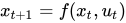
这里  是系统状态,
 是控制输入。机器人路径规划、轨迹优化、模型预测控制,经常就是“最优化 + 动力学约束 + 反馈”的组合。
优化器真正决定的是这一步的更新:

然后把参数改成:
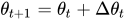
所以所有优化器都可以粗暴地问成一句话:你准备用什么信息来决定  ?
这也是为什么运筹学、控制论、深度学习优化器会经常互相碰到。它们不一定研究同一种问题,但都在处理“怎么选择变量,让目标变好,同时别违反约束”。差别主要在问题结构:运筹优化常面对显式约束和离散决策;控制论常面对时间、动力学和反馈;深度学习训练常面对高维、随机、非凸和分布式计算。
2. 一阶方法:只看“坡往哪边下”
梯度下降是最容易理解的一阶方法。
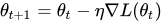
这里的  就是当前位置的梯度。它告诉你:在当前位置,哪个方向上升最快。既然我们要最小化 loss,就反着走。
学习率  控制步子大小。
如果每一步都用全量数据算梯度,就是 batch gradient descent;如果每次只用一个 mini-batch 的数据估计梯度,就是 stochastic gradient descent,简称 SGD。
SGD 的优点是便宜、直接、泛化常常不错。缺点也明显:mini-batch 梯度有噪声,如果每一步都完全相信当前梯度,路线会抖。
于是出现了 Momentum。
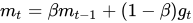
动量不是在问“这一秒风往哪吹”,而是在问“最近一段时间,风大体往哪吹”。它把历史梯度做指数平均,让更新方向更稳。
所以 SGD 和 Momentum 都是一阶方法:它们主要使用梯度,不显式使用 Hessian。
这里顺便澄清一个常见误解:不能简单说“SGD 是无约束优化,运筹规划是有约束优化”。SGD/Adam 当然常用于无约束随机非凸优化,但它们也可以和投影、惩罚项、拉格朗日方法结合,用在有约束问题里。运筹优化也不只研究有约束问题,它也有无约束非线性优化、最小二乘、动态规划、随机近似。
更准确的区别是:SGD/Adam 是一类求解方法,运筹优化是一大片问题与建模传统。一个是“怎么走”,一个更偏“问题长什么样”。
3. 曲率:梯度已经告诉我陡不陡,为什么还要曲率?
很多人第一次听 Hessian 会有同一个疑问:梯度不就已经告诉我们山坡陡不陡了吗?为什么还要曲率?
关键区别是:
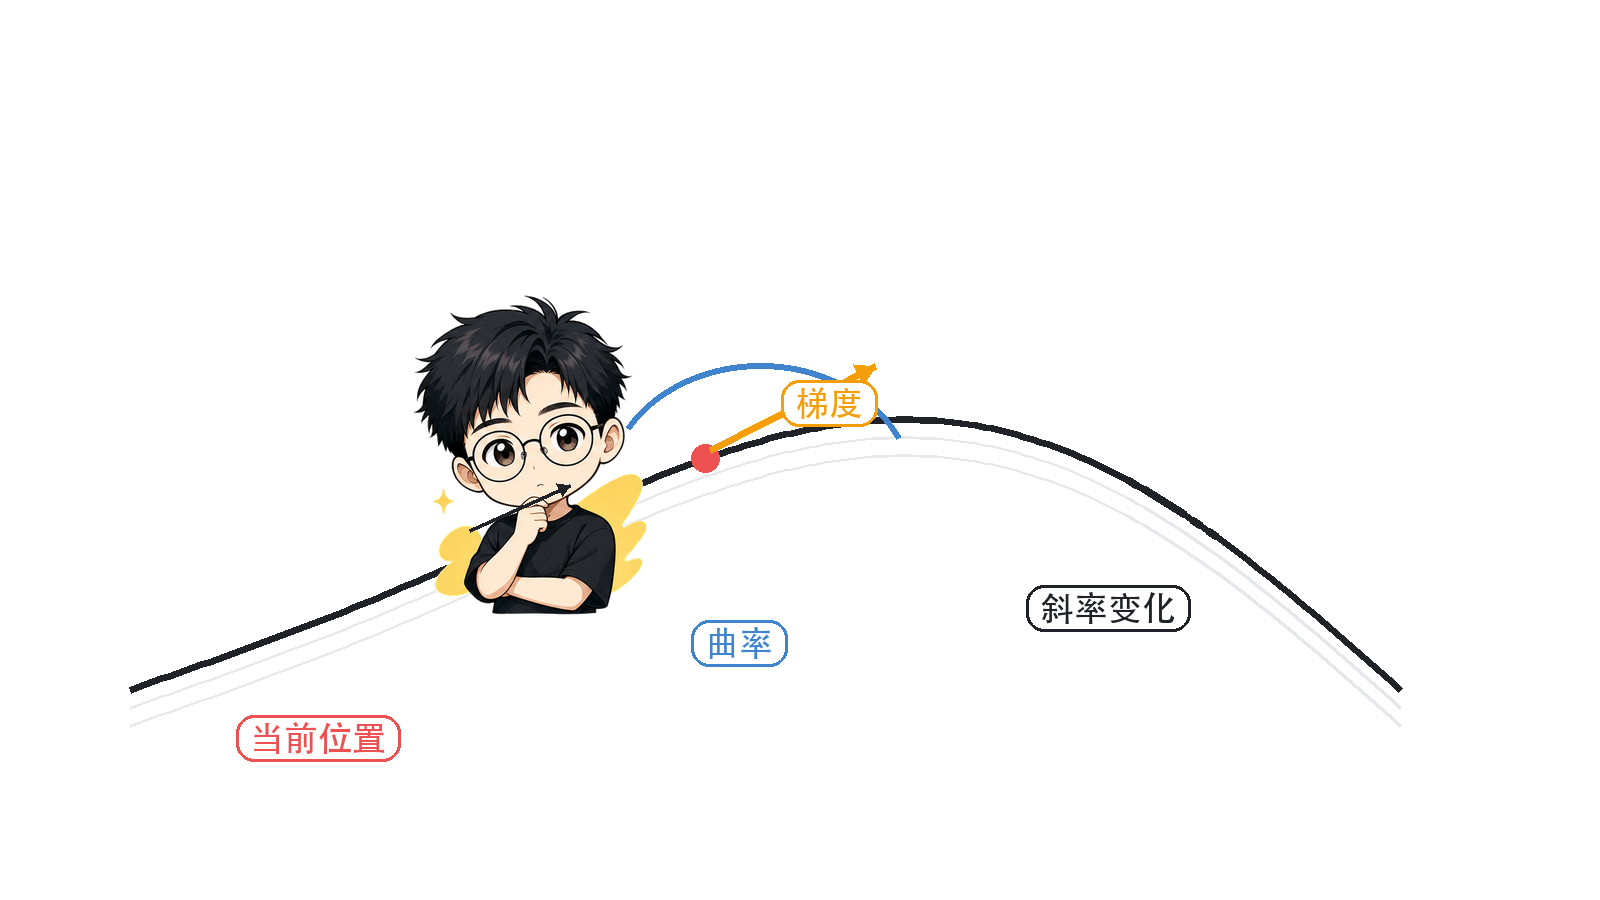
梯度告诉你“当前位置有多陡”;曲率告诉你“你往前走一点,坡度会怎么变”。
两个地方的当前坡度可能一样,但后面的地形完全不同。
一个地方像长斜坡,坡度稳定;另一个地方像窄山谷,刚走一点坡度就剧烈变化。只看当前梯度,你会以为它们一样;看曲率,你才知道第二个地方更危险,步子应该小一点或换个方向。
对多参数函数来说,曲率由 Hessian 矩阵描述:
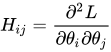
它是一个  矩阵。对角线元素表示某个参数方向自己的弯曲程度;非对角线元素表示两个参数方向之间的耦合:你改
 ,
 方向的梯度会不会也跟着变。
Hessian 出现在二阶泰勒展开里:
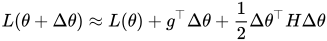
第一项  是“沿当前坡度走会怎样”。第二项
 是“地形弯曲会怎样改变这一步的结果”。
这就是 Hessian 为什么能体现曲率。
4. 牛顿法:不只看坡,还看碗的形状
如果梯度下降像是“看到坡就往下冲”,牛顿法更像是“先估计这个山谷像什么碗,再一步走向碗底”。
牛顿方向是:
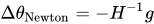
这一步非常漂亮:梯度  告诉你哪里下降,Hessian
 告诉你每个方向的曲率和耦合,
 相当于根据地形重新缩放和旋转梯度。
如果某个方向曲率很大,说明那里很窄,牛顿法会少走一点;如果某个方向曲率很小,说明那里很平,牛顿法会允许走大一点。
这就是“二阶方法”的核心气质:不仅看一阶坡度,还看二阶弯曲。
但神经网络里直接用牛顿法很难。
假设一个模型有  个参数,Hessian 是 。大模型的 可以是十亿、百亿、千亿。别说求逆,连把 Hessian 存下来都不现实。
所以深度学习里的多数优化器不会真的构造完整 Hessian。
5. 拟牛顿法:不存 Hessian,也想学一点曲率
传统数值优化里有一类方法叫拟牛顿法,比如 BFGS、L-BFGS。
它们的思路是:我不直接算 Hessian,但我观察几步之间梯度怎么变化,从这些变化里估计一个“像 Hessian 逆矩阵”的东西。
如果你从  走到
 ,梯度从
 变成
 ,那么:

 是参数变化,
 是梯度变化。梯度变化里藏着曲率信息。
BFGS 会维护一个近似的二阶矩阵;L-BFGS 则只保留最近几步的  ,省内存。
为什么它们在深度学习里没有 AdamW 这么流行?主要不是因为它们“不高级”,而是因为大模型训练有三个现实问题:参数太多、梯度噪声太大、分布式训练通信成本太高。拟牛顿法要维护和使用额外的历史曲率结构,在超大规模随机训练里很难像 AdamW 那样简单、稳定、便宜。
如果对应到 scipy.optimize,你会看到很多传统数值优化器都在这里出现:Nelder-Mead 不需要梯度,BFGS 和 L-BFGS-B 使用梯度和近似曲率,Newton-CG、trust-ncg、trust-krylov、trust-exact 更靠近二阶方法,SLSQP 和 trust-constr 处理有约束最小化。
这份目录很适合建立直觉:传统优化器经常在“是否需要梯度、是否使用曲率、是否处理约束、局部还是全局”这些维度上分类。深度学习优化器则是在另一个极端场景里演化出来的:超高维、mini-batch 噪声、GPU/TPU 并行、参数量巨大。所以它们更在意吞吐、内存、通信、稳定性。
6. Adam:不是牛顿法,但确实在“重新缩放梯度”
Adam 的核心更新是两条历史统计:
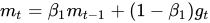
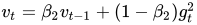
 是梯度的一阶矩估计,可以粗略理解成“最近梯度的平均方向”。
 是梯度平方的二阶矩估计,可以粗略理解成“这个方向历史上抖得有多大、尺度有多大”。
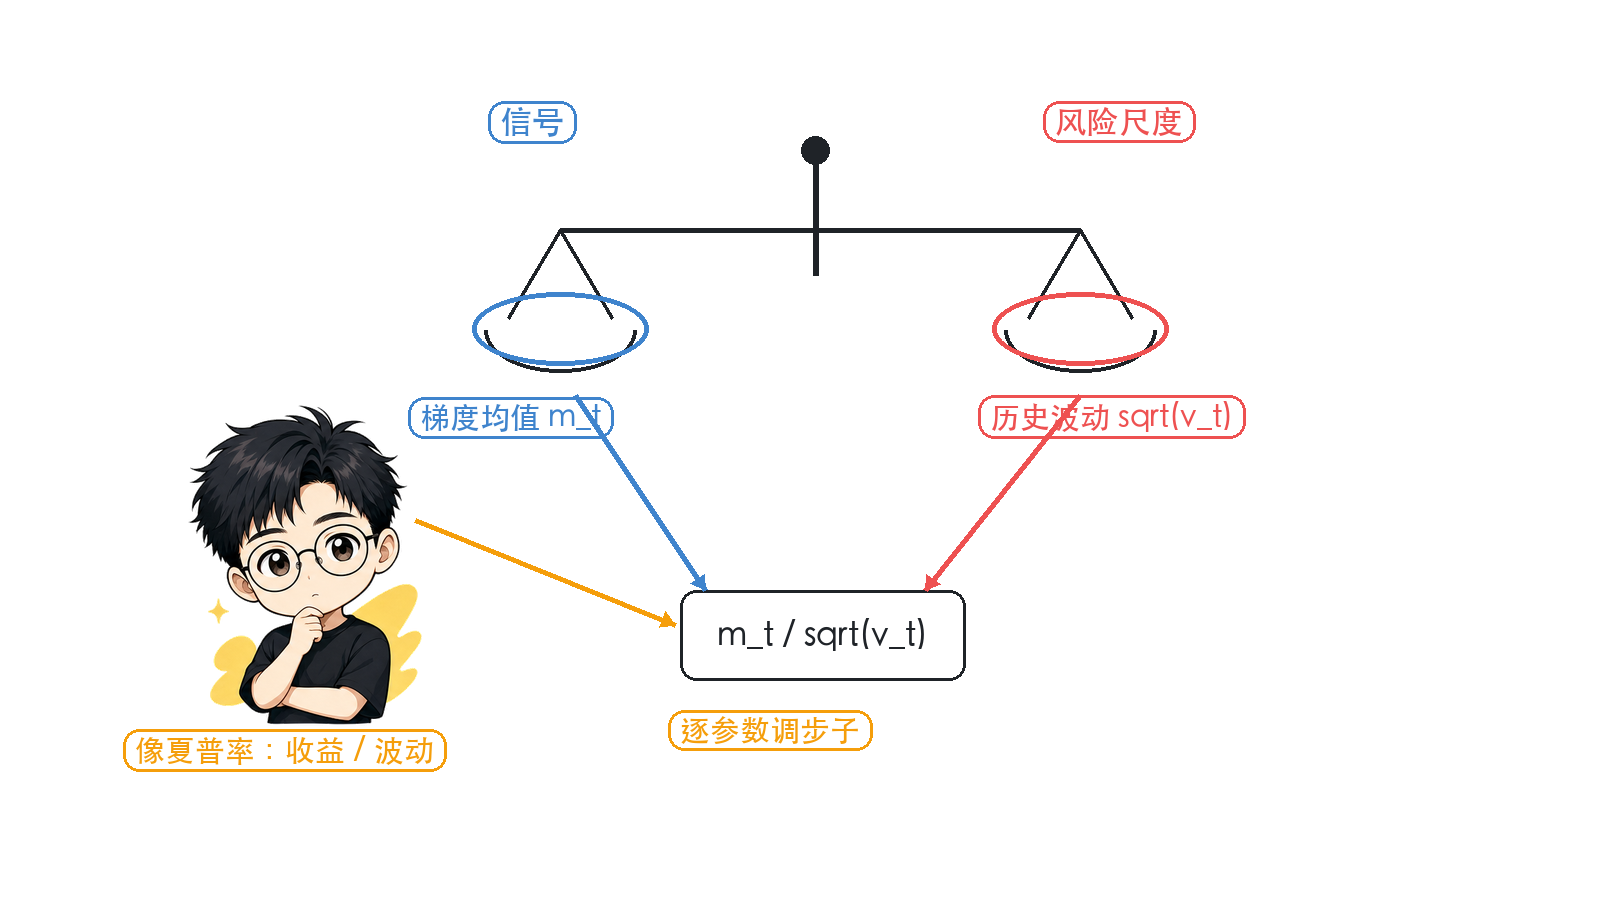
这时很容易联想到金融里的 Sharpe ratio。不是因为 Adam 真的在做资产定价,而是因为它也在做一个“信号除以波动”的缩放:如果一个方向平均梯度很稳定,它更值得走;如果一个方向历史梯度很大但也很抖,直接按梯度猛走就容易过冲。
Adam 的方向大致是:
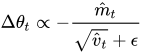
这就产生了一个很重要的效果:某个参数方向历史梯度尺度很大,就给它小一点步子;历史梯度尺度小,就相对给大一点步子。
这和牛顿法有没有关系?
有关系,但不能说 Adam 就是牛顿法。
共同点是:它们都不是裸梯度下降。它们都会对梯度做某种“预条件化”,也就是先改变不同方向的尺度,再决定更新。
区别是:牛顿法的尺度来自目标函数的曲率,也就是 Hessian;Adam 的尺度来自历史梯度的平方均值,是一种逐坐标的梯度尺度/噪声统计。它通常不理解参数之间的耦合,也不显式估计完整曲率。
一个讨论:Adam 是不是在近似二阶导?
这个问题不能只回答“是”或者“不是”。
如果从严格数学定义看,Adam 没有计算 Hessian:
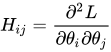
它没有问“梯度对参数再求一次导是多少”,也没有保存参数之间的交叉项  。所以它不是牛顿法,也不是标准二阶优化器。
但如果从训练直觉看,说 Adam 完全和曲率无关,也太粗暴了。
深度学习的 loss landscape 非常不规则:mini-batch 在变,样本分布在变,激活状态在变,梯度噪声也很大。很多时候,直接估计 Hessian 既贵又脏,得到的局部曲率也未必稳定。于是 Adam 退了一步:我不估计完整曲率,只估计每个坐标方向上“历史梯度到底有多大、多抖”。
这个量不等于 Hessian,但在某些条件下会和二阶信息产生联系。比如在最大似然训练里,梯度平方的期望和 Fisher 信息矩阵的对角线有关;而 Fisher 又常被看作 Hessian 或 Gauss-Newton 矩阵的一种替代曲率。换句话说,Adam 的 可以被理解成一种非常粗糙、逐坐标、随机采样出来的“曲率/噪声尺度”。
更准确地说:
Adam 不是在近似 Hessian 本身,而是在用历史梯度平方近似一个逐坐标的局部尺度。这个尺度有时表现得像曲率预条件器,有时更像噪声归一化器。
这也是为什么 Adam 的直觉和牛顿法有亲戚关系:它们都在避免所有方向使用同一个步长。但它们的“风险账本”来源不同。牛顿法用 Hessian 账本,Adam 用历史梯度平方账本。
所以更准确的说法是:
Adam 是带动量和逐参数自适应缩放的一阶优化器。它有“像牛顿法一样给不同方向不同步长”的味道,但它不是二阶曲率方法。
7. AdamW:把 weight decay 从梯度里拆出来
AdamW 可以看成 Adam 在大模型训练里的更常用版本。
Adam 原始写法里,L2 正则经常会混进梯度估计里。问题是 Adam 会对梯度做自适应缩放,于是正则项也被缩放了,weight decay 的含义变得不够干净。
AdamW 的做法是把 weight decay 解耦:
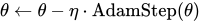

也就是说,优化方向和参数衰减分开处理。这样 weight decay 更像一个稳定的“参数收缩规则”,不会被 Adam 的逐坐标缩放扭曲。
这也是为什么大模型训练里 AdamW 比 Adam 更常作为默认选择。
8. Muon:矩阵权重不是一堆独立坐标
Muon 的核心直觉和 Adam 不一样。
Adam 把每个参数坐标看得很重要:每个坐标都有自己的 、、步长缩放。
但 MLP 和 Attention 里的很多权重是二维矩阵。一个矩阵不是一把散沙。它作为线性变换,真正改变的是表示空间:某些方向被放大,某些方向被压缩,某些子空间被旋转。
Muon 大致做的是:
- 先对矩阵梯度做 momentum。
- 再对这个 momentum 矩阵做近似正交化。
- 用更均衡的矩阵方向更新权重。
可以粗略写成:
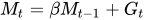
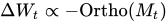
这里的  不是求 Hessian,也不是 Adam 的逐坐标除法。它更像是把一个矩阵更新方向的少数巨大奇异方向压住,让更新不要被少数大方向支配。
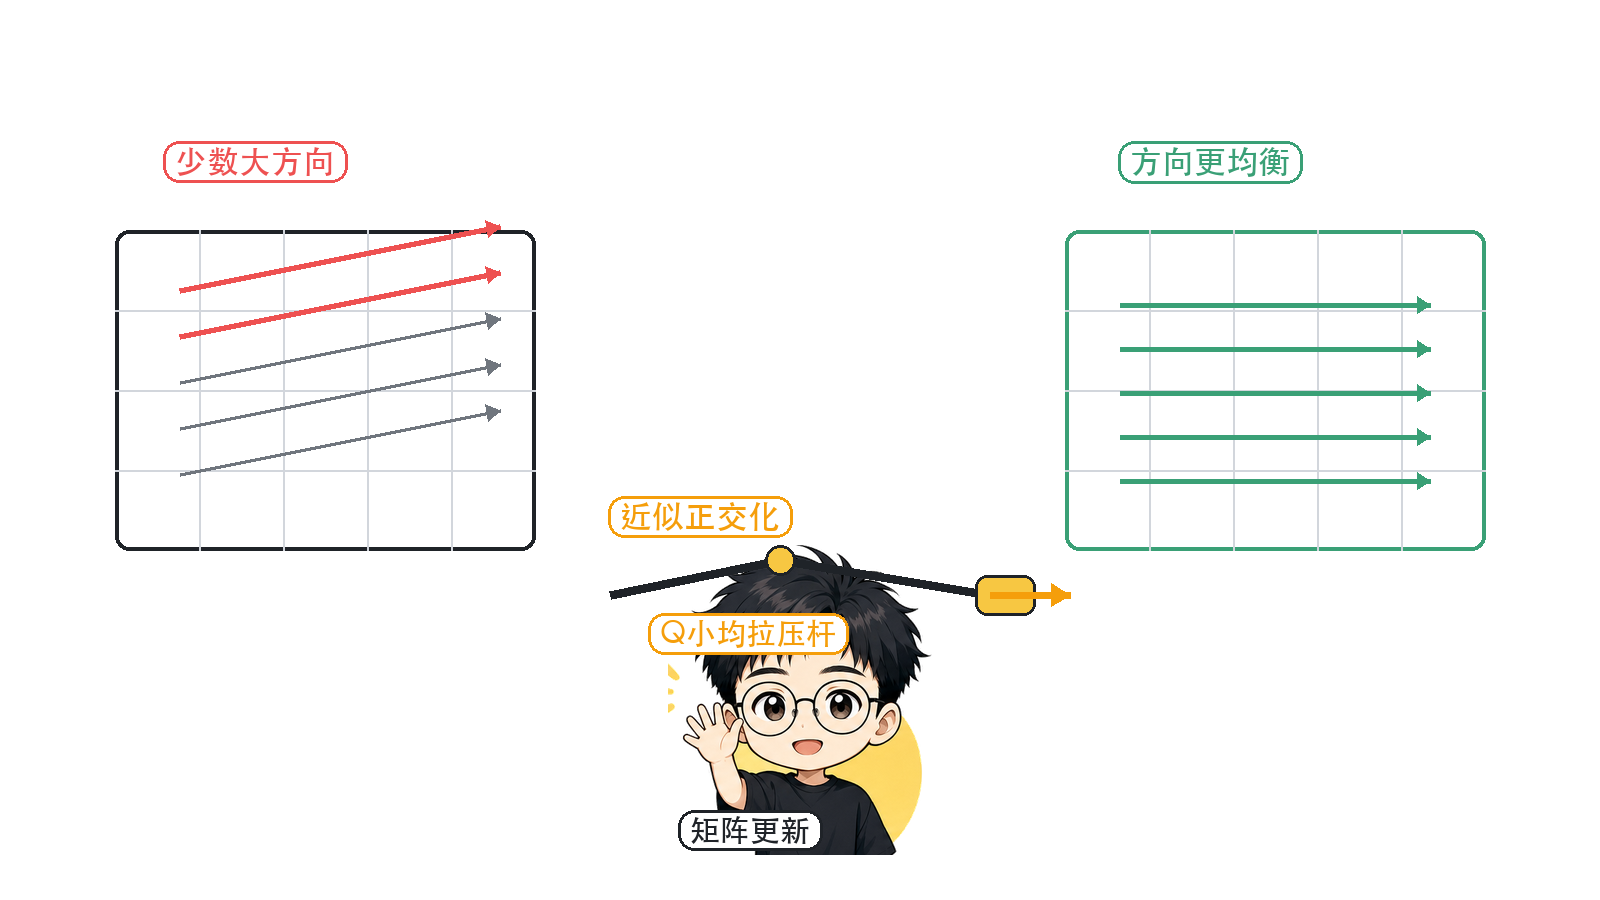
这也是为什么 Muon 通常更适合 MLP、Attention 这类二维 dense weight,而不是 norm、bias、embedding 这些结构。
它不是“Adam 的替代品”这么简单。更准确地说,它换了一种看待更新风险的单位:Adam 看坐标,Muon 看矩阵。
这也对应我们前面聊过的机器人例子:路径规划有时像运筹优化,在图上找最短路、最低成本轨迹;有时又像控制论,要在动力学约束下实时修正轨迹。分类不是靠名字,而是靠问题结构。优化器也一样,Adam 和 Muon 的差别不是“谁更高级”,而是它们假设参数块的结构不同。
这句话会成为第二篇的入口。
9. 一张表记住它们
| 优化器 | 主要信息 | 看待参数的方式 | 优点 | 局限 |
|---|---|---|---|---|
| SGD | 当前梯度 | 全局同一步长 | 简单、便宜、泛化好 | 噪声大,调参敏感 |
| Momentum | 历史梯度均值 | 方向有惯性 | 路线更稳 | 没有逐坐标尺度 |
| Newton | 梯度 + Hessian | 曲率耦合结构 | 局部收敛快 | 大模型不可承受 |
| BFGS/L-BFGS | 梯度变化 | 近似曲率 | 不显式算完整 Hessian | 随机大规模训练不方便 |
| Adam | 动量 + 梯度平方均值 | 逐参数自适应 | 稳、好用、默认强 | 不显式理解矩阵结构 |
| AdamW | Adam + 解耦 weight decay | 逐参数自适应 | 大模型默认常用 | 仍是坐标视角 |
| Muon | 矩阵动量 + 近似正交化 | 矩阵几何 | 适合 dense matrix weight | 不适合所有层 |
10. 小结:优化器不是一个公式,而是一种“风险观”
到这里,我们可以把优化器重新理解一遍。
SGD 说:我相信当前梯度。
Momentum 说:我相信历史平均方向。
Newton 说:我还要知道地形弯曲。
拟牛顿说:我不直接算 Hessian,但我要从梯度变化里学曲率。
Adam 说:每个参数方向都有自己的历史波动,步子要按坐标缩放。
AdamW 说:别把正则化和自适应缩放搅在一起。
Muon 说:矩阵权重不是一堆独立参数,更新应该尊重矩阵几何。
如果只从“谁更快、谁更强”理解优化器,很容易陷入经验主义。但如果从“每个优化器到底在用什么信息、控制什么风险”理解,Adam 和 Muon 就不再是两个互相打架的技巧,而是两个风险度量不同的更新策略。
第二篇我们就从这个角度继续:能不能把 Adam 和 Muon 放进一个金融式的“收益-风险-预算”框架里?
参考资料
- Diederik P. Kingma, Jimmy Ba, Adam: A Method for Stochastic Optimization
- Ilya Loshchilov, Frank Hutter, Decoupled Weight Decay Regularization
- Keller Jordan, Muon: An optimizer for hidden layers in neural networks
- Muon GitHub: KellerJordan/Muon
- SciPy User Guide, Optimization and root finding (scipy.optimize)
- SciPy API Reference,
scipy.optimize