
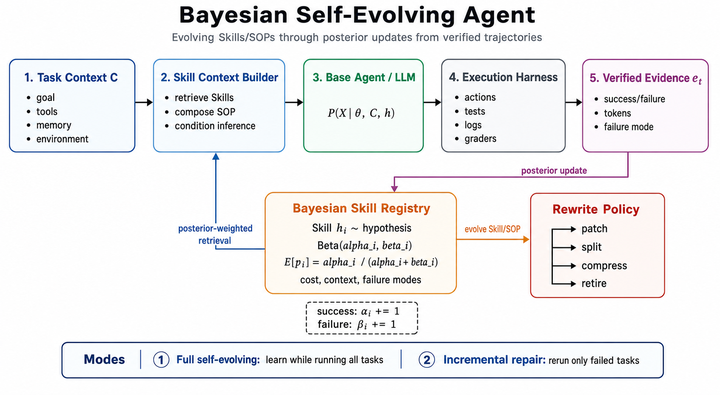
最近 Harness Engineering 这个概念开始火起来。AI和大模型领域发展日新月异,Prompt Engineering、Context Engineering、RAG、Memory、Tool Use、Harness新名词层出不穷,好像每个词都是一套新范式。
但如果把它们放到同一个视角下看,本质其实很简单:
大语言模型吐出的每一个 token,都是在某个条件下的概率采样。
最朴素的模型是:
P(X | θ)
其中 θ 是模型参数。预训练、微调、RLHF、强化学习,本质上都是在改变 θ 或者改变 θ 的分布。
而 Prompt、Context、RAG、Memory、Tool、Harness 做的事情,是另一条路线:
P(X | θ, C)
模型参数不变,但我们改变推理时的条件 C。
所以说要:
- 改变模型本身:预训练、微调、强化学习。
- 改变模型推理环境:Prompt、Context、RAG、Memory、Tool、Harness。
前者是训练,后者是推理环境工程。
这也是为什么 AI 工程范式会从 Prompt Engineering 走向 Context Engineering,再走向 Harness Engineering。
一、从 Prompt 到 Context,再到 Harness
Prompt Engineering 解决的是:如何把任务说清楚。
早期我们面对的是问答场景。你输入一句话,模型输出一段回答。于是大家研究角色设定、few-shot、CoT、ReAct,本质是在优化输入表达。
但当任务从“答一道题”变成“让 Agent 连续几十分钟完成一个真实任务”,Prompt 就不够了。
因为很多失败不是模型不会,而是它不知道:
- 该看什么文件
- 该调用什么工具
- 错了以后如何验证
- 什么时候应该停止
- 哪些经验应该沉淀下来,下次继续用
于是 Context Engineering 出现了。它关心的是模型在关键时刻能看到什么,包括用户输入、工具返回、历史对话、检索片段、短期记忆、长期记忆、当前任务状态。
但只补 Context 仍然不够。
一个 Coding Agent 真正要稳定工作,还需要运行环境、权限边界、反馈回路、测试机制、日志、版本记录、失败恢复。这就是 Harness Engineering。
如果把 Agent 看作一个新入职工程师,Prompt 是任务说明,Context 是你递给他的材料,Harness 是他的电脑、权限、文档、工具链、测试环境和团队规范。
真实任务里,决定 Agent 能不能交付的,往往不是“模型会不会写代码”,而是这个工程支架搭得好不好。
1.1 为什么 Skill 变得越来越重要
在这个框架里,Skill 是一个很关键但经常被低估的东西。
Skill 不是简单的 Prompt 模板。它更像是“被压缩过的工程经验”。
比如一个 Debug Agent,如果只告诉它:
解决这个崩溃问题。
即使你给它日志和代码仓库,它也可能在仓库里盲目搜索,读很多无关文件,然后围绕一个错误假设反复自证。
但如果你给它一个崩溃分析 Skill:
- 遇到这类崩溃先搜哪些关键字
- 优先调用哪个本地分析工具
- 如何从日志反查调用链
- 什么时候看 git 历史
- 哪些历史案例值得参考
它的行为会立刻变得更像一个有经验的工程师。
这说明 Agent 缺的不是“再解释一遍任务”,而是一条可执行的调查路径。
所以我认为,Agent 时代真正有价值的工程资产,不是某一段 prompt,而是可复用、可验证、可进化的 Skill / SOP。
问题是:Skill 应该如何进化?
1.2 Skill 进化不能靠玄学
现在很多 Agent 系统都有 Memory 或 Skill 机制,但它们的更新方式往往比较粗糙。
任务成功了,就把经验写进去。 任务失败了,就补一句“以后不要这样”。
这有两个问题。
第一,经验不一定可靠。一次成功可能只是运气,一次失败也可能只是环境偶然波动。
第二,Skill 容易膨胀。所有经验都往里写,最后 Skill 变成一堆互相冲突的自然语言碎片,模型反而更难用。
所以我设计了一个 Bayesian Self-Evolving 算法,把 Skill 当成一个可检验的假设,而不是一段神圣文本。
一个 Skill / SOP 可以看作假设 h:
在某类任务上下文中,使用这个 Skill 可以提高成功概率。
于是我们要估计的是:
P(success | θ, C, h)
模型参数 θ 不变,任务上下文 C 不同,Skill 假设 h 会随着证据更新。
二、Bayesian Self-Evolving 的核心思路
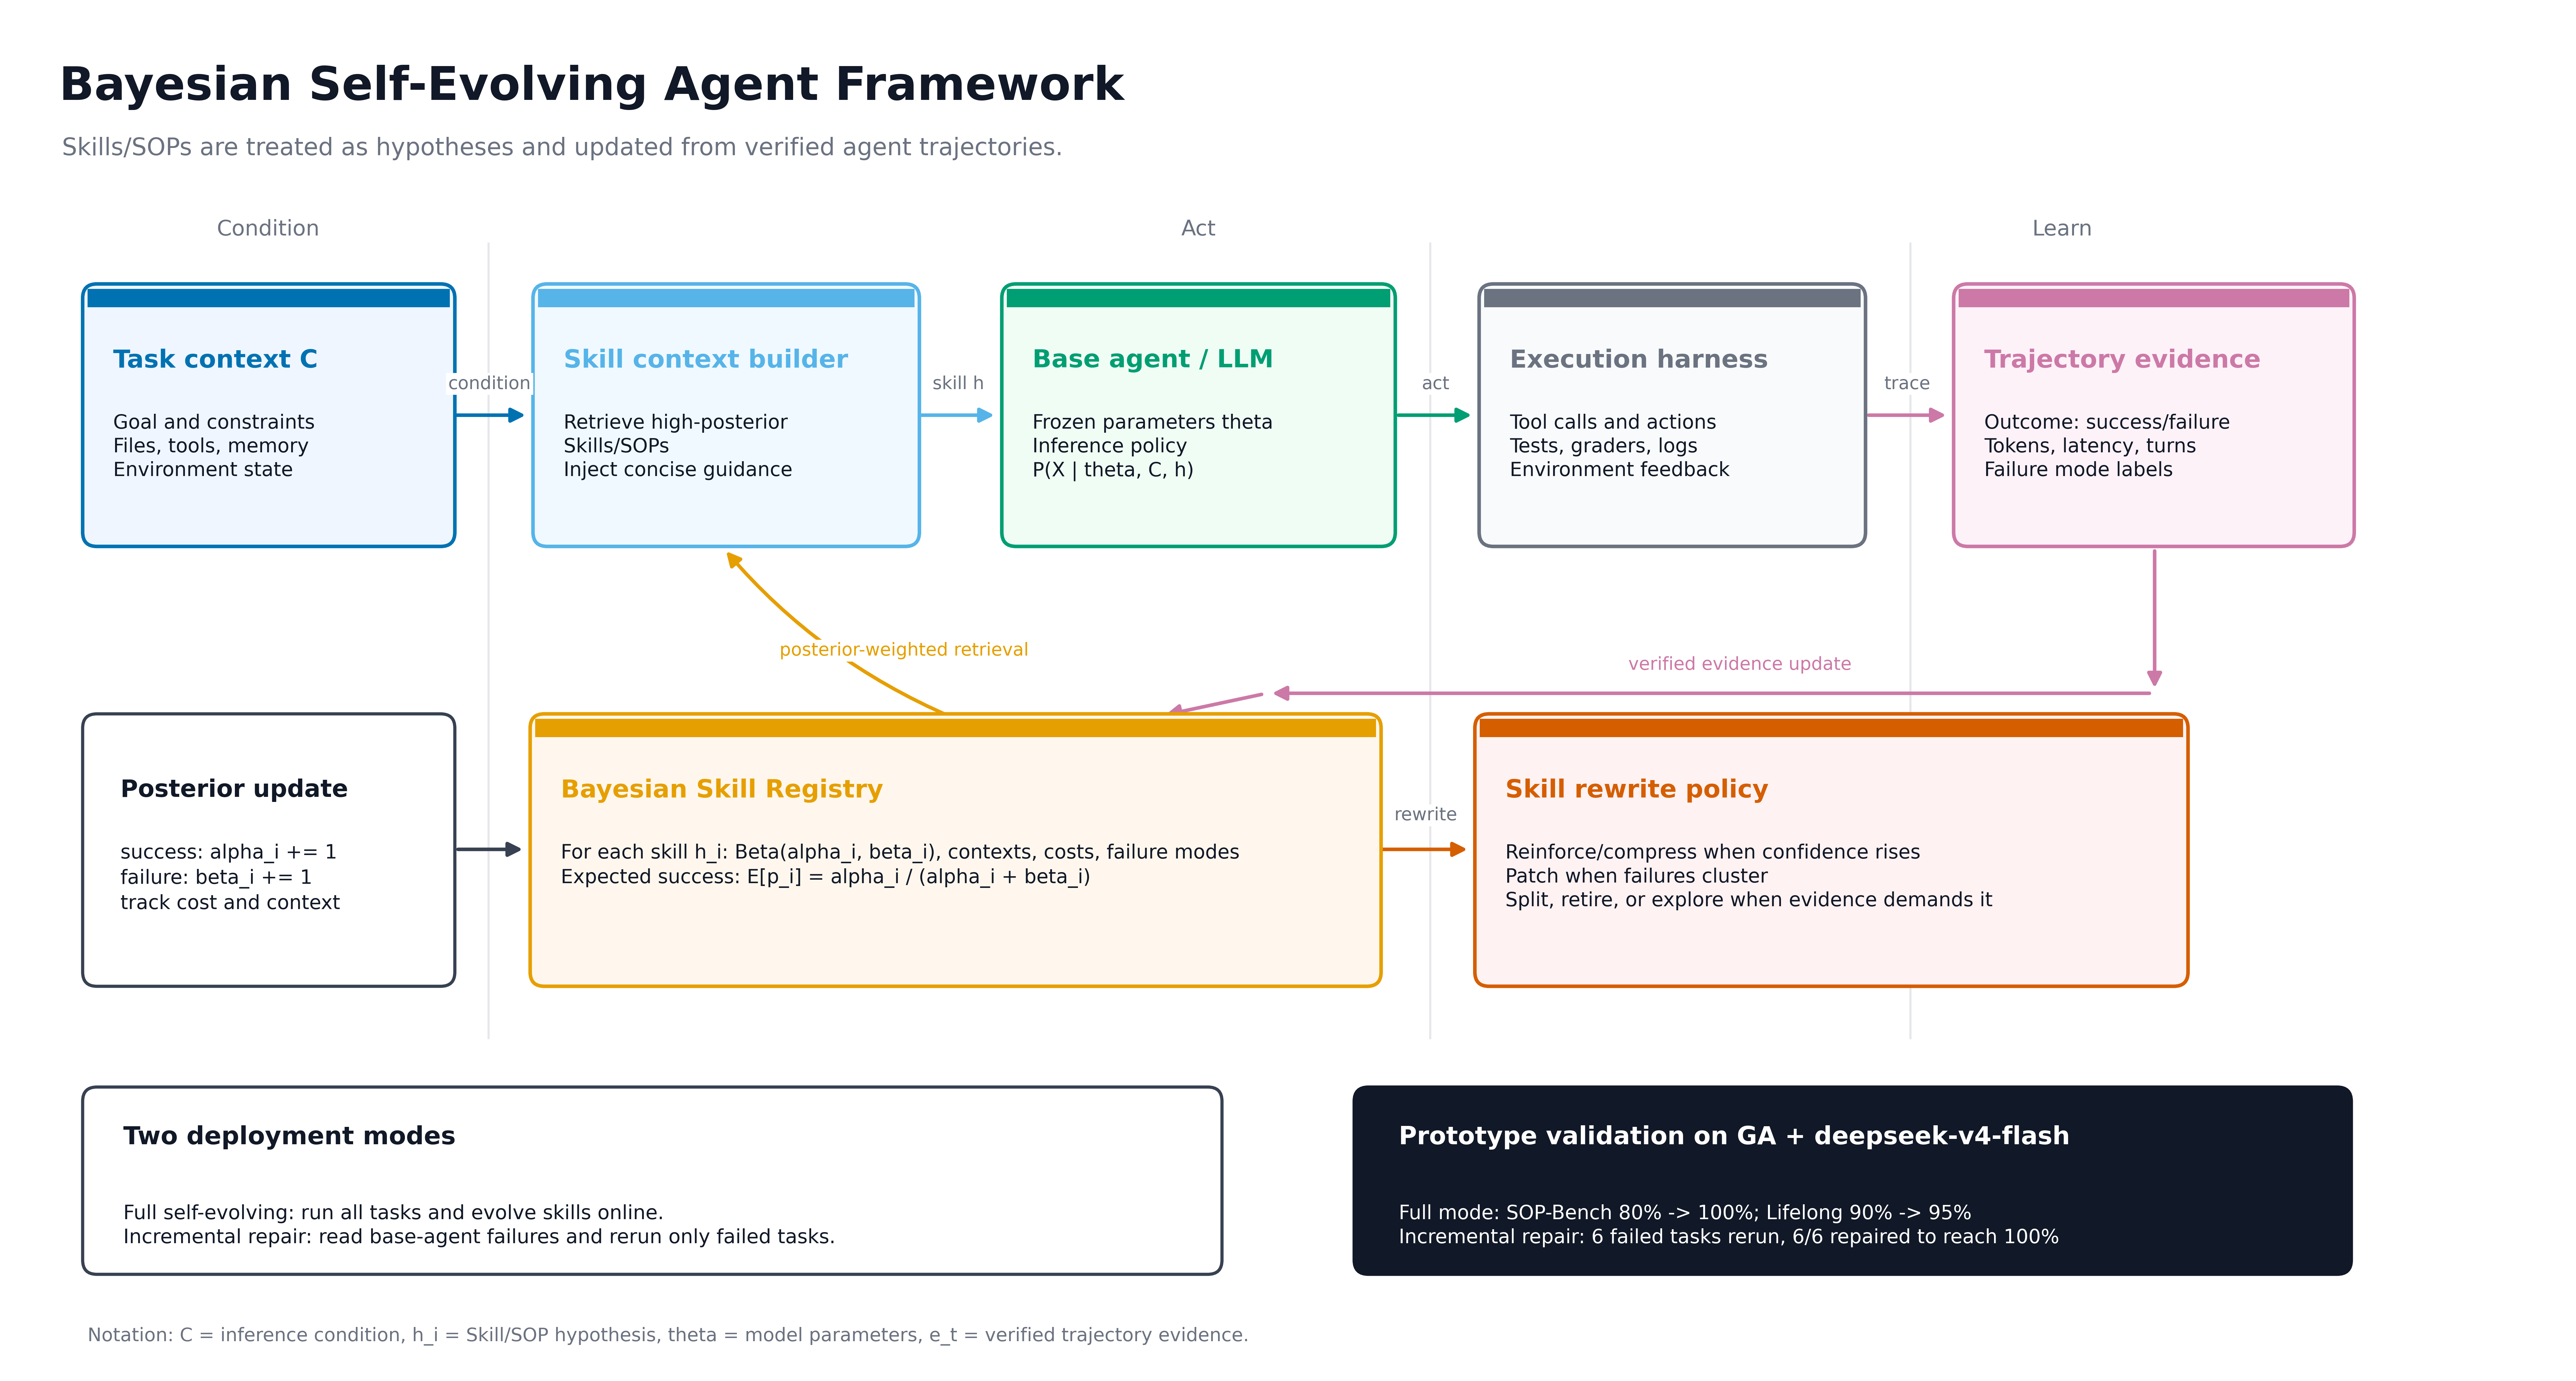
算法很简单:
- 每个 Skill 维护一个 posterior belief。
- 初始用 Beta prior,例如
Beta(1, 1)。 - 每次任务执行后,记录 action-verified evidence。
- 成功则提高
alpha,失败则提高beta。 - 同时记录 failure mode、token cost、耗时、适用上下文。
- Skill 改写不直接靠主观总结,而是根据 posterior 和 failure mode 触发。
举例:
- 如果连续成功,posterior success 提高,就压缩和强化这条 Skill。
- 如果某个上下文成功、另一个上下文失败,就拆分 Skill。
- 如果失败集中在同一类 failure mode,就做局部 patch。
- 如果失败压倒成功,就 retire 或重写。
- 如果没有足够证据,就保持 exploratory,不急着固化进长期记忆。
这和传统 Memory 最大的区别是:它不是“把感觉写进记忆”,而是“把验证过的证据写进 posterior”。
也就是说,Skill 的进化过程本身变成了一个小型贝叶斯推理过程。
2.1 两种使用方式:从零进化,以及增量修复
我把这个算法接到了 GenericAgent 上,并用 deepseek-v4-flash 做了两组实验。
第一组是从零开始跑。也就是不给它 GA 之前的失败结果,让 Bayesian Skill 在 benchmark 过程中自己积累证据。
第二组是增量模式。这个更有实用价值:假设你已经有一个 Agent,比如 GA,它在 benchmark 上没有达到 100%。Bayesian 模块不推翻原系统,只读取 GA 的成功/失败轨迹,把失败样本变成 evidence,然后只重跑失败题。
这相当于把 Bayesian Self-Evolving 当成一个即插即用的修复层。
三、实验:GA + deepseek-v4-flash 基线
原始 GA + deepseek-v4-flash 的结果是:
| Benchmark | Agent | Model | Accuracy | Input Tokens | Output Tokens | Total Tokens | Efficiency |
|---|---|---|---|---|---|---|---|
| SOP-Bench | GA | deepseek-v4-flash | 80% | 1.34M | 57k | 1.39M | 11.47 |
| Lifelong AgentBench | GA | deepseek-v4-flash | 90% | 649k | 42k | 690k | 26.07 |
可以看到,GA 本身已经不差,但还没有到 100%。
3.1 从零跑 Bayesian
Bayesian Self-Evolving 从零跑 SOP-Bench 和 Lifelong AgentBench 的结果是:
| Benchmark | Agent | Model | Accuracy | Input Tokens | Output Tokens | Total Tokens | Efficiency |
|---|---|---|---|---|---|---|---|
| SOP-Bench | GA+Bayesian | deepseek-v4-flash | 100% | 1.07M | 52k | 1.12M | 17.86 |
| Lifelong AgentBench | GA+Bayesian | deepseek-v4-flash | 95% | 666k | 44k | 710k | 26.77 |
SOP-Bench 从 80% 提升到 100%,同时 token 从 1.39M 降到 1.12M。
Lifelong 从 90% 提升到 95%,token 基本持平。
这说明 Bayesian Skill 不是简单“多塞上下文”,它确实能减少一部分重复探索和错误执行。
3.2 增量模式:只修复 GA 的失败题
更有意思的是增量模式。
GA 在 SOP-Bench 失败了 4 题,在 Lifelong AgentBench 失败了 2 题。Bayesian 模块读取这些失败轨迹,只重跑失败题,结果如下:
| Benchmark | Agent | Model | Final Accuracy | Incremental Input | Incremental Output | Incremental Total | Incremental Efficiency |
|---|---|---|---|---|---|---|---|
| SOP-Bench | GA+BayesianIncremental | deepseek-v4-flash | 100% | 216k | 10k | 226k | 17.73 |
| Lifelong AgentBench | GA+BayesianIncremental | deepseek-v4-flash | 100% | 71k | 7k | 78k | 25.57 |
也就是说:
- SOP-Bench:额外花 226k tokens,把 80% 补到 100%。
- Lifelong AgentBench:额外花 78k tokens,把 90% 补到 100%。
这就是我认为它有实用价值的地方。
它不要求你替换原来的 Agent,也不要求重新训练模型,而是作为一个后验修复层,挂在已有系统后面:
先让原 Agent 做事,再用 Bayesian Skill Evolution 学习失败模式,只对失败区域进行低成本修复。
这比“全量重跑一遍”更接近真实生产里的工作流。
四、为什么这件事重要
很多人讨论 Agent,最后会落到模型能力本身:是不是要换更强模型?是不是要微调?是不是要 RL?
这些当然重要。
但从工程角度看,还有另一条非常现实的路线:
不动模型参数,而是让 Skill、Memory、Tool、Harness 变成可观测、可验证、可进化的外部系统。
模型参数是 θ,它很贵。 推理环境是 C,它更灵活。 Skill 是 C 里面最值得沉淀的一部分。
如果说 Prompt Engineering 是写好一句话,Context Engineering 是组织好一批信息,那么 Harness Engineering 的下一步,应该是让这些信息资产能够自我进化。
Bayesian Self-Evolving 想做的,就是把 Skill 从“经验文本”变成“带 posterior 的工程假设”。
Claude Code/ Codex/ Openclaw/ Hermes 已经说明不会未来大模型系统的竞争不会只发生在模型层。
未来真正拉开差距的,可能是这些东西:
- 谁能把失败变成可复用证据
- 谁能把经验压缩成可执行 Skill
- 谁能让 Skill 在长期任务里不断进化
- 谁能用最小 token 成本,把已有 Agent 的成功率继续往上推
Agent 每一次成功和失败,都不应该只是日志里的噪声,而应该成为下一次推理环境的一部分。贝叶斯方法为我们去建模这一过程提供了有力的工具。
我们会把这套 Bayesian Self-Evolving Agent 的代码开源在: