
前面几篇文章里,我主要在讲 Bayesian-Agent 为什么需要贝叶斯、它和 frequentist skill evolving 的区别、没有手写 skill catalog 的 zero-shot 模式是否仍然有效。
这篇文章换一个角度,回答一个更工程化的问题:
如果我已经有自己的 agent 了,怎么快速接入 Bayesian-Agent?
论文地址:http://arxiv.org/abs/2606.08348
GitHub:https://github.com/DataArcTech/Bayesian-Agent
答案其实很简单:
你不需要换掉自己的 agent,也不需要把自己的 harness 重写成 Bayesian-Agent 的样子。
你只需要让自己的 agent 多做两件事:
- 接收 Bayesian-Agent 给出的 Skill/SOP context;
- 把每次运行后的 trajectory、token、成功失败、failure mode 等信息返回给 Bayesian-Agent。
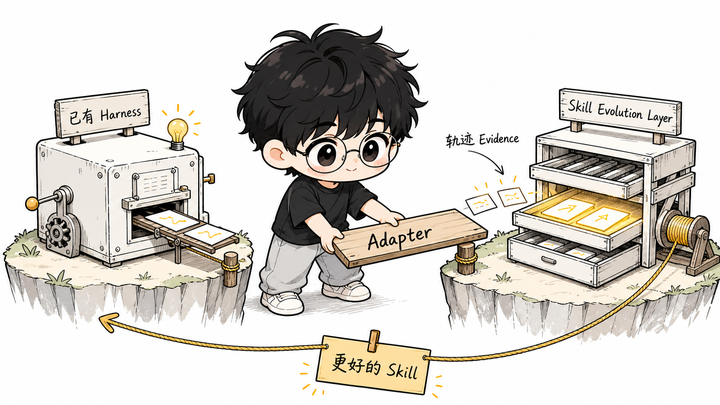
也就是说,Bayesian-Agent 更准确地说不是“又一个 agent framework”,而是一个:
Bayesian-Agent Skill Evolution Layer
它可以挂在你已有的 agent / harness 旁边,依赖之前的执行轨迹,不断更新 skill belief,再把下一轮更有针对性的 skill context 交还给你的 agent。
一、最重要的心智模型:不要替换你的 agent,而是加一层 evolution layer
很多 agent 框架都已经很复杂了。
它们可能有自己的:
- tool system;
- memory;
- planner;
- browser/runtime;
- workspace;
- permission model;
- prompt template;
- logging/tracing;
- benchmark runner。
如果 Bayesian-Agent 要求你把这些全部迁移过来,那上手成本就太高了。
所以我们一开始就把 Bayesian-Agent 设计成分层结构:
你的 Agent / Harness
        |
        | 运行任务,产生 trajectory
        v
Bayesian-Agent Evidence Layer
        |
        | success / failure / tokens / failure mode / metadata
        v
Bayesian Skill Registry
        |
        | posterior belief + rewrite policy
        v
Skill/SOP Context
        |
        | 注入下一次任务
        v
你的 Agent / Harness
这件事的关键是:Bayesian-Agent 不需要控制你的 agent 内部所有细节。
它只需要一个稳定边界:
run(task, skill_context) -> trajectory-like result
这就是 adapter。
二、Adapter 到底要做什么?
Bayesian-Agent 里的 adapter contract 非常小。
大概就是:
from typing import Any, Mapping, Protocol

class AgentAdapter(Protocol):
    def run(
        self,
        task: Mapping[str, Any],
        skill_context: str,
    ) -> Mapping[str, Any]:
        ...
它接收两个东西:
-
task:你的 benchmark 或业务任务; -
skill_context:Bayesian-Agent 根据历史证据生成的 Skill/SOP context。
它返回一个 trajectory-like mapping,例如:
{
    "task_id": "sop_12",
    "success": False,
    "transcript": "...",
    "input_tokens": 70123,
    "output_tokens": 4242,
    "total_tokens": 74365,
    "turns": 8,
    "elapsed_seconds": 31.5,
    "failure_mode": "left_expected_output_blank",
    "summary": "The model left the expected_output cell blank.",
    "metadata": {
        "harness": "my_agent",
        "model": "deepseek-v4-flash"
    }
}
这些字段不需要一开始就全部完美。
最低限度,你至少要能提供:
-
task_id:是哪一个任务; -
success:是否通过 verifier / grader / 业务检查; -
transcript或运行日志:方便后续归因; - token usage:方便计算效率;
- failure mode:如果没有手写 taxonomy,也可以先让 Bayesian-Agent 自动发现。
Bayesian-Agent 会把这些运行结果转成 TrajectoryEvidence,再更新 Skill belief。
三、最小 adapter 怎么写?
假设你已经有一个自己的 agent:
my_agent.run(prompt, workspace=workspace)
那 adapter 可以非常薄:
from dataclasses import dataclass
from typing import Any, Mapping


@dataclass
class MyAgentAdapter:
    agent: Any

    def run(self, task: Mapping[str, Any], skill_context: str = "") -> Mapping[str, Any]:
        prompt = str(task["prompt"])
        if skill_context:
            prompt = f"{skill_context}\n\n{prompt}"

        result = self.agent.run(
            prompt,
            workspace=task["workspace"],
        )

        return {
            "task_id": task.get("task_id", ""),
            "transcript": result.transcript,
            "input_tokens": result.input_tokens,
            "output_tokens": result.output_tokens,
            "total_tokens": result.total_tokens,
            "elapsed_seconds": result.elapsed_seconds,
            # success / failure_mode 可以由外部 verifier 或 benchmark runner 补上
        }
注意这里的 adapter 不应该做太多事。
也就是说 adapter 的 return 重点是:轨迹、token、耗时、错误信息。
success/failure_mode 通常是 verifier 之后由BA再加上去的。
它不应该负责:
- benchmark loop;
- grader;
- Bayesian posterior update;
- skill registry;
- incremental repair 策略;
- 复杂的实验统计。
这些应该留在 Bayesian-Agent 这一层。
adapter 只负责一件事:
把 Bayesian-Agent 生成的 skill context 交给你的 agent,然后把运行轨迹带回来。
四、依赖之前的轨迹,怎么接入?
如果你已经有一批历史运行结果,比如:
baseline_results.json
里面包含每个任务的 success/failure、token、输出、日志、failure mode 等信息,那可以先把这些历史轨迹喂给 Bayesian-Agent:
bayesian-agent evolve \
  --results baseline_results.json \
  --registry temp/bayesian_skill_beliefs.json \
  --context-out temp/skill_context.md
这一步会做几件事:
- 读取历史 trajectories;
- 转成
TrajectoryEvidence; - 更新 Bayesian Skill Registry;
- 生成 posterior audit context 或下一轮 skill context。
然后可以找出 baseline 中失败的任务:
bayesian-agent repair-plan \
  --baseline baseline_results.json \
  --out temp/failed_tasks.json
接下来有两种常见接法。
第一种是 full self-evolution:
从零开始跑所有任务
每跑一个 case 就更新一次 belief
下一条 case 使用更新后的 skill context
第二种是 incremental repair:
先读取已有 baseline trajectories
只挑失败 case 重跑
把修复结果和 baseline 合并
用更少 token 提升最终准确率
在真实业务里,我更推荐先从 incremental repair 开始。
因为它最像一个即插即用模块:
你的 agent 先跑一遍
Bayesian-Agent 分析失败轨迹
只重跑失败任务
把修复后的结果合并回去
不用一上来就重构你的 agent 系统。
五、我们已经有的 adapter
目前仓库里已经有几个 adapter / backend:
1. GenericAgent adapter
GenericAgent 是我们最早验证 Bayesian-Agent 原型的地方。
现在它已经不再被复制到 Bayesian-Agent 仓库里,而是作为一个 optional compatibility backend:
python experiments/run_benchmarks.py \
  --harness genericagent \
  --genericagent-root /path/to/GenericAgent \
  --model deepseek-v4-flash \
  --bench core \
  --mode all
这个 adapter 的边界很清楚:
- GenericAgent 负责执行任务;
- Bayesian-Agent 负责 benchmark orchestration、evidence collection、posterior update、skill evolution、incremental repair。
也就是说,我们没有 copy 一份 GenericAgent。
我们只是写了一个 adapter,让 GA 可以作为执行后端。
2. mini-swe-agent adapter
mini-swe-agent 也可以作为 execution backend:
python experiments/run_benchmarks.py \
  --harness mini-swe-agent \
  --mini-swe-agent-root /path/to/mini-swe-agent \
  --model deepseek-v4-flash \
  --bench realfin \
  --mode all
它的定位也一样:
mini-swe-agent 负责跑任务,Bayesian-Agent 负责把运行轨迹变成 skill evolution evidence。
这种设计很重要。
因为同一个 Bayesian Skill Evolution Layer 可以挂在不同 agent harness 上,比较不同 backend 的执行能力,也可以观察 skill evolution 组件本身是否稳定有效。
3. Claude Code adapter
我们也加了 Claude Code CLI adapter:
python experiments/run_benchmarks.py \
  --harness claude-code \
  --claude-cli claude \
  --model deepseek-v4-pro[1m] \
  --bench realfin \
  --mode all
Claude Code 负责实际执行命令和生成结果。
Bayesian-Agent 负责:
- 接收它的 JSON / transcript;
- 统计 token;
- 交给 verifier;
- 更新 Skill Registry;
- 为下一轮生成 Bayesian Failure-Mode Patches。
这说明 Bayesian-Agent 的目标不是绑定某一个 agent 框架,而是做一个跨 harness 的 skill evolution layer。
4. 一个直接的实验表格
为了避免这件事只停留在“接口设计很优雅”的层面,我们看几组已经跑完的代表性结果。
这里比较的不是“哪个 harness 天然更强”,而是更实际的问题:
在同一个 backend 内,把 Bayesian-Agent 接上去以后,是否能用历史轨迹和 Skill Evolution 继续提升结果?
| Backend | Benchmark | Model | Baseline | Bayesian full | Bayesian incremental |
|---|---|---|---|---|---|
| GenericAgent adapter | SOP-Bench | deepseek-v4-flash | 80%, 1.39M tokens | 100%, 1.12M tokens | 100%, +268k tokens |
| GenericAgent adapter | Lifelong AgentBench | deepseek-v4-flash | 90%, 690k tokens | 95%, 710k tokens | 100%, +139k tokens |
| BA native backend | SOP-Bench | deepseek-v4-flash | 95%, 1.05M tokens | 100%, 870k tokens | 100%, +45k tokens |
| BA native backend | Lifelong AgentBench | deepseek-v4-flash | 95%, 538k tokens | 100%, 514k tokens | 100%, +65k tokens |
| BA native backend | RealFin-Bench | deepseek-v4-pro | 65%, 9.54M tokens | 70%, 9.91M tokens | 77.5%, +4.59M tokens |
这里的 Bayesian full 指从头跑完整 benchmark,并在过程中持续更新 Skill belief。
Bayesian incremental 指先读取已有 baseline trajectories,只重跑失败任务,所以表里的 token 是额外修复成本。
这个表想说明的不是“Bayesian-Agent 一定让每个 harness 都立刻碾压”,而是:
只要你的 agent 能产生可验证轨迹,Bayesian-Agent 就可以作为旁路模块,把这些轨迹变成后续 Skill Evolution 的 evidence。
六、那 native backend 是干什么的?
既然我们支持接入 GA、mini-swe-agent、Claude Code,为什么还要做 Bayesian-Agent 自己的 native backend?
答案是:为了实验和归因。
复杂 harness 很强,但也很难做消融。
如果一个 agent 系统里同时有:
- 很厚的 system prompt;
- 多层 memory;
- planner;
- tool router;
- reflection;
- retry;
- long-horizon state;
- framework-specific heuristics;
- benchmark-specific hacks;
那么当结果变好时,我们很难回答:
到底是 Bayesian Skill Evolution 有用?
还是 harness 本身某个隐含策略有用?
这就是 native backend 的设计哲学:
让 harness 尽量小,把能力提升尽量推到 skill evolution layer。
Bayesian-Agent native harness 只保留最小执行 substrate:
- OpenAI-compatible LLM client;
- workspace-scoped tools:
file_read、file_write、code_run、finish; - turn loop;
- tool dispatch;
- transcript capture;
- token accounting;
- trajectory artifact。
native memory 默认关闭。
如果你显式打开:
--native-memory
它才会注入三层 memory context。
默认关闭的原因也很简单:
我们希望 baseline 和 Bayesian runs 的差异尽量来自 Skill Evolution Layer,而不是来自一个隐式增强的 memory system。
换句话说,native backend 是为了让实验更干净。
复杂 harness 更像生产系统。
native backend 更像实验仪器。
七、如何选择接入方式?
如果你只是想最快体验:
python experiments/run_benchmarks.py \
  --harness bayesian-agent \
  --model deepseek-v4-flash \
  --bench core \
  --mode all \
  --limit 1
如果你已经有自己的 agent:
先写 adapter
再把历史 trajectories 转成 Bayesian-Agent 能读的 results
然后跑 incremental repair
如果你想验证某个新组件是否真的有用:
优先用 native backend
保持 harness 简单
看新增组件对结果、token、failure mode 的影响
如果你想在生产环境里用:
保留自己的 agent / harness
让 Bayesian-Agent 做旁路 skill evolution
只把稳定 patch 注入下一轮任务
八、Catalog skill 是必须的吗?
不是。
Bayesian-Agent 默认是 use_skill_catalog=True,也就是 catalog-first。
如果你已经有 benchmark-specific failure taxonomy 和 patch catalog,那它们就是很好的强先验,通常效果更好。
但如果你没有,也可以用:
--no-use-skill-catalog
这时 Bayesian-Agent 会进入 zero-shot automatic failure discovery:
trajectory
  -> verifier scores / errors / requested artifacts / output contract
  -> auto failure mode
  -> distilled repair rules
  -> repeated evidence 后激活 patch
我们最近做了一组对比:
没有 catalog skills 时,BA 仍然能提升:
- SOP-Bench incremental:70% -> 100%
- RealFin-Bench full/incremental:38% -> 45%
有 catalog skills 时,BA 表现更强:
- SOP-Bench:最高 100%
- Lifelong AgentBench:最高 100%
- RealFin-Bench:最高 72%
这说明 catalog 不是 Bayesian-Agent 的全部。
catalog 更像强先验。
没有强先验时,Bayesian-Agent 仍然能通过轨迹证据发现重复失败,并形成 generic patches。
有强先验时,它可以更快、更准、更稳。
九、一个真实上手流程
如果你现在有一个自己的 agent,我建议按这个顺序接:
Step 1:先保留你的 agent 不动
不要一开始就重构 harness。
先确认你的 agent 能输出:
- 每个 task 的 id;
- transcript;
- token usage;
- workspace / artifacts;
- verifier result;
- error / failure reason。
Step 2:写一个薄 adapter
只实现:
run(task, skill_context) -> result
把 skill_context 拼到 prompt 前面,调用你的 agent,然后返回 trajectory-like result。
Step 3:把旧结果转成 evidence
用历史 run:
bayesian-agent evolve \
  --results old_results.json \
  --registry beliefs.json \
  --context-out skill_context.md
Step 4:先跑 incremental repair
不要急着全量重跑。
先找失败任务:
bayesian-agent repair-plan \
  --baseline old_results.json \
  --out failed_tasks.json
然后只重跑失败任务。
这是最容易看到 ROI 的方式。
Step 5:检查 artifacts,而不是只看 accuracy
Bayesian-Agent 会保存:
- belief json;
- posterior audit context;
- skill context before/after;
- failure mode patches;
- benchmark summary;
- token / efficiency table。
我强烈建议不要只看最后 accuracy。
要看它到底学到了什么:
它识别了哪些 failure mode?
哪些 patch 被激活?
有没有过拟合?
token 是否下降?
失败是否集中在同一类问题?
这才是 skill evolution 真正有价值的地方。
十、总结
如果只用一句话概括 Bayesian-Agent 的上手方式:
不要把它当成替代你 agent 的新框架,而是把它当成一个可插拔的 Bayesian Skill Evolution Layer。
你可以:
- 保留自己的 agent;
- 写一个薄 adapter;
- 复用已有 trajectories;
- 用 Bayesian-Agent 更新 Skill belief;
- 把生成的 Skill/SOP context 注入下一轮任务;
- 先从 incremental repair 开始验证收益。
我们已经支持:
- Bayesian-Agent native backend;
- GenericAgent adapter;
- mini-swe-agent adapter;
- Claude Code adapter。
native backend 的价值是让实验干净、组件归因清楚。
external adapter 的价值是让 Bayesian Skill Evolution Layer 可以进入真实 agent 生态,而不是被锁死在某一个 harness 里。
这也是我们一直强调的:
Bayesian-Agent 不是又一个孤立 agent framework。
它更像一层可以跨 harness 迁移的后天学习系统:
experience -> evidence -> belief -> skill rewrite -> better next run
这就是 Bayesian-Agent 快速上手的核心