
上一篇我们把一个单方程常微分方程跑通了。
常微分方程的英文是 ordinary differential equation,简称 ODE。
这一篇往前走一步:不只跟踪一个量,而是同时跟踪三类人。
这一篇先问一个具体问题:
为什么一场传播刚开始会扩散,但过一段时间感染者又会自己降下来?
先给一句人话答案:
感染者一边把易感者拉进感染桶,一边又有人康复离开感染桶;前者先占上风,后来易感者被消耗掉,后者就占上风。
SIR 是 Susceptible-Infectious-Recovered 的缩写,中文通常叫“易感者-感染者-康复者模型”。
它是微分方程建模里最经典的例子之一:不复杂,但很完整。
有假设,有方程组,有阈值判断,也有非常直观的曲线解释。
0. 先把它想成三只桶
先别急着记 SIR 这个缩写。
你可以先把它想成三只桶:
-
S桶:还没被传上的人 -
I桶:正在传播的人 -
R桶:已经康复、不再参与传播的人
人只会从 S 流到 I,再从 I 流到 R。
这就是这篇模型最核心的直觉。
这一节的 takeaway:SIR 的第一层理解不是公式,而是三只桶之间的人口流动。
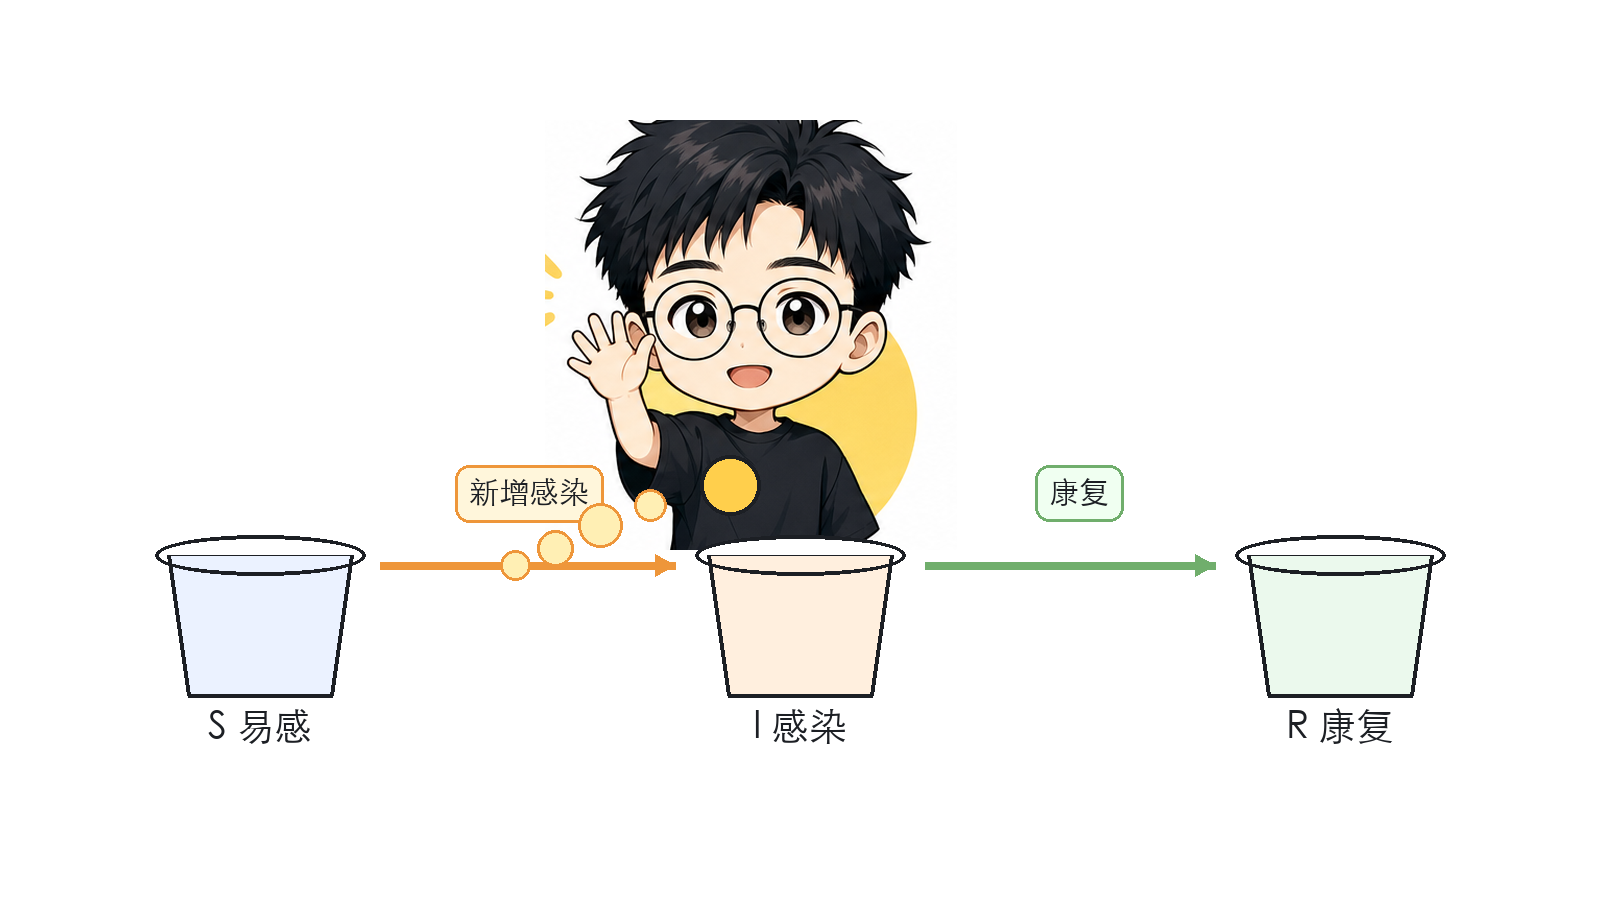
这张解释图先把公式藏起来,只保留最关键的流动:S 流向 I,I 再流向 R。
1. 模型要讲清楚什么
SIR 里的三个变量分别表示:
-
S(t):易感者比例 -
I(t):感染者比例 -
R(t):康复者比例
通常先做一个最常见的简化:
- 总人口固定
- 人群均匀混合
- 康复后不再被感染
这篇用“人口比例”建模,所以 S + I + R = 1。
时间单位可以理解成“天”,于是 beta 和 gamma 都是“每天发生多少”的速率。
在这个假设下,总量守恒:
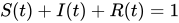
这类模型的核心参数有两个:
-
beta:接触并导致感染的速率 -
gamma:康复速率
于是方程组写成:
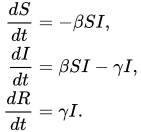
这三条式子其实是在写“人数流动”:
-
-beta * S * I:S和I同时存在时,才会发生新增感染,所以S被转走。 -
beta * S * I:同一批新增感染流入I,所以I先加这一项。 -
-gamma * I:感染者按固定速度康复离开I。 -
gamma * I:离开的感染者进入R。
为什么是乘积 S * I?
先看两个最小情况:
- 如果只有易感者,没有感染者,就不会新增感染
- 如果只有感染者,没有易感者,也不会新增感染
所以“新感染”必须同时依赖两边的人数。
最简单的写法,就是把它们乘起来,再乘一个传染强度 beta,得到 beta * S * I。
这不是说现实里一定完全如此,而是说:这是一个最简单、最好用的起步假设。
后面如果要更细,可以再改成分年龄、分场所、分接触网络的版本。
这一节的 takeaway:方程里的每一项都应该能翻译成“谁从哪个桶流到哪个桶”。
2. 为什么这个模型重要
这个模型最有用的一点,是它能直接告诉你一个阈值:

它叫基本再生数。
先别被名字卡住,你可以先把它理解成:
传播能力和恢复能力的比值。
- 如果
 ,说明一开始有扩散条件
- 如果
 ,说明连起步扩散都很难发生
但它只描述“先天传播能力”,真正决定某一时刻还能不能继续涨的,是:
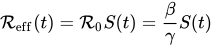
你可以把它理解成“当前这波传播到底还能不能烧起来”。
- 当
\mathcal{R}_{\mathrm{eff}}(t) > 1,I(t)还在涨 - 当
\mathcal{R}_{\mathrm{eff}}(t) < 1,I(t)开始回落
为什么可以这样判断?
直接看感染者这一条方程:
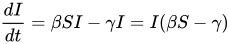
只要 I > 0,感染者是在涨还是跌,就看括号里的 beta*S - gamma:
-
beta*S > gamma:新增感染压过康复,I(t)上升 -
beta*S < gamma:康复压过新增感染,I(t)下降
两边同除以 gamma,就得到:

这就是  。
更具体一点,I(t) 达到峰值时,满足
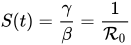
这个条件非常适合拿来和数值解对照。
也就是说,感染曲线不是凭空长起来的,它背后有一个很朴素的平衡点。
起初 S(t)≈1,所以 \mathcal{R}_{\mathrm{eff}}(t)≈\mathcal{R}_0;
随着传播进行,S(t) 被不断消耗,\mathcal{R}_{\mathrm{eff}}(t) 也会往下掉,最后压到 1 以下,感染就开始掉头。
这一节的 takeaway: 只说明“起步能扩散”,疫情后来会下降,是因为 S(t) 下降让  跌破 1。
3. 用 solve_ivp 解方程组
这一篇的代码和上一篇的结构很像,只是右端项从一个方程变成了三个方程。
# 对应正文中的 SIR 方程组
def sir_rhs(t, y, beta, gamma):
    S, I, R = y

    # infection 是 S -> I 的流量,对应 beta*S*I。
    infection = beta * S * I

    # recovery 是 I -> R 的流量,对应 gamma*I。
    recovery = gamma * I

    # 三个导数就是三个桶的净变化速度。
    dS_dt = -infection
    dI_dt = infection - recovery
    dR_dt = recovery
    return [dS_dt, dI_dt, dR_dt]
这里的 y 就是状态向量 [S, I, R]。rhs 是 right-hand side 的缩写,也就是“方程右边”。
它不是新概念,只是代码里那个“给当前状态,返回当前变化速度”的函数。
solve_ivp 并不关心你有几个变量,它只管把这个右端函数一步步积分下去。
完整求解可以写成:
import numpy as np
from scipy.integrate import solve_ivp

# 对应理论参数 beta 和 gamma
beta = 0.32
gamma = 0.10

# 对应初始条件 S(0), I(0), R(0)
S0, I0, R0_init = 0.999, 0.001, 0.0
t_eval = np.linspace(0, 160, 800)

sol = solve_ivp(
    lambda t, y: sir_rhs(t, y, beta, gamma),
    (t_eval[0], t_eval[-1]),
    [S0, I0, R0_init],
    t_eval=t_eval,
    method="RK45",
)
这一节的 takeaway:方程组进 solve_ivp 的方式没有变,只是 y 从一个数变成了一个状态向量。
4. 看结果时要看什么
SIR 模型最值得看的不是“某个点的值”,而是三条曲线之间的关系。
-
S(t)会下降 -
I(t)先升后降 -
R(t)单调上升
如果参数合理,数值结果应该还满足近似守恒:
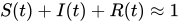
另外,感染峰值出现的时刻,也能和理论条件 S = \gamma / \beta 对上。
这其实就是在看 \mathcal{R}_{\mathrm{eff}}(t) 什么时候跌到 1 以下。
你真正要盯的是这两个问题:
- 传染会不会自己压下去
- 最严重的时候大概在什么时候
这一节的 takeaway:看 SIR 结果,重点看守恒、峰值和阈值是否互相对得上。
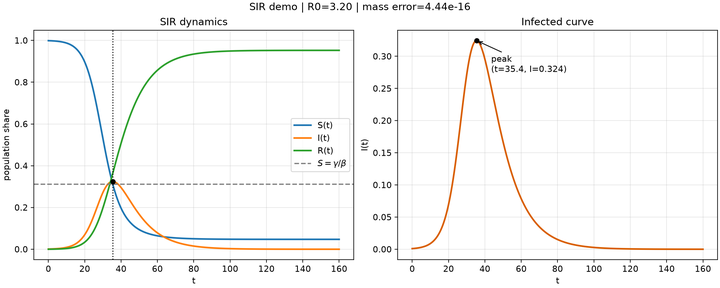
5. 例子:一个标准疫情曲线
下面这组参数会产生一条很典型的 SIR 曲线。
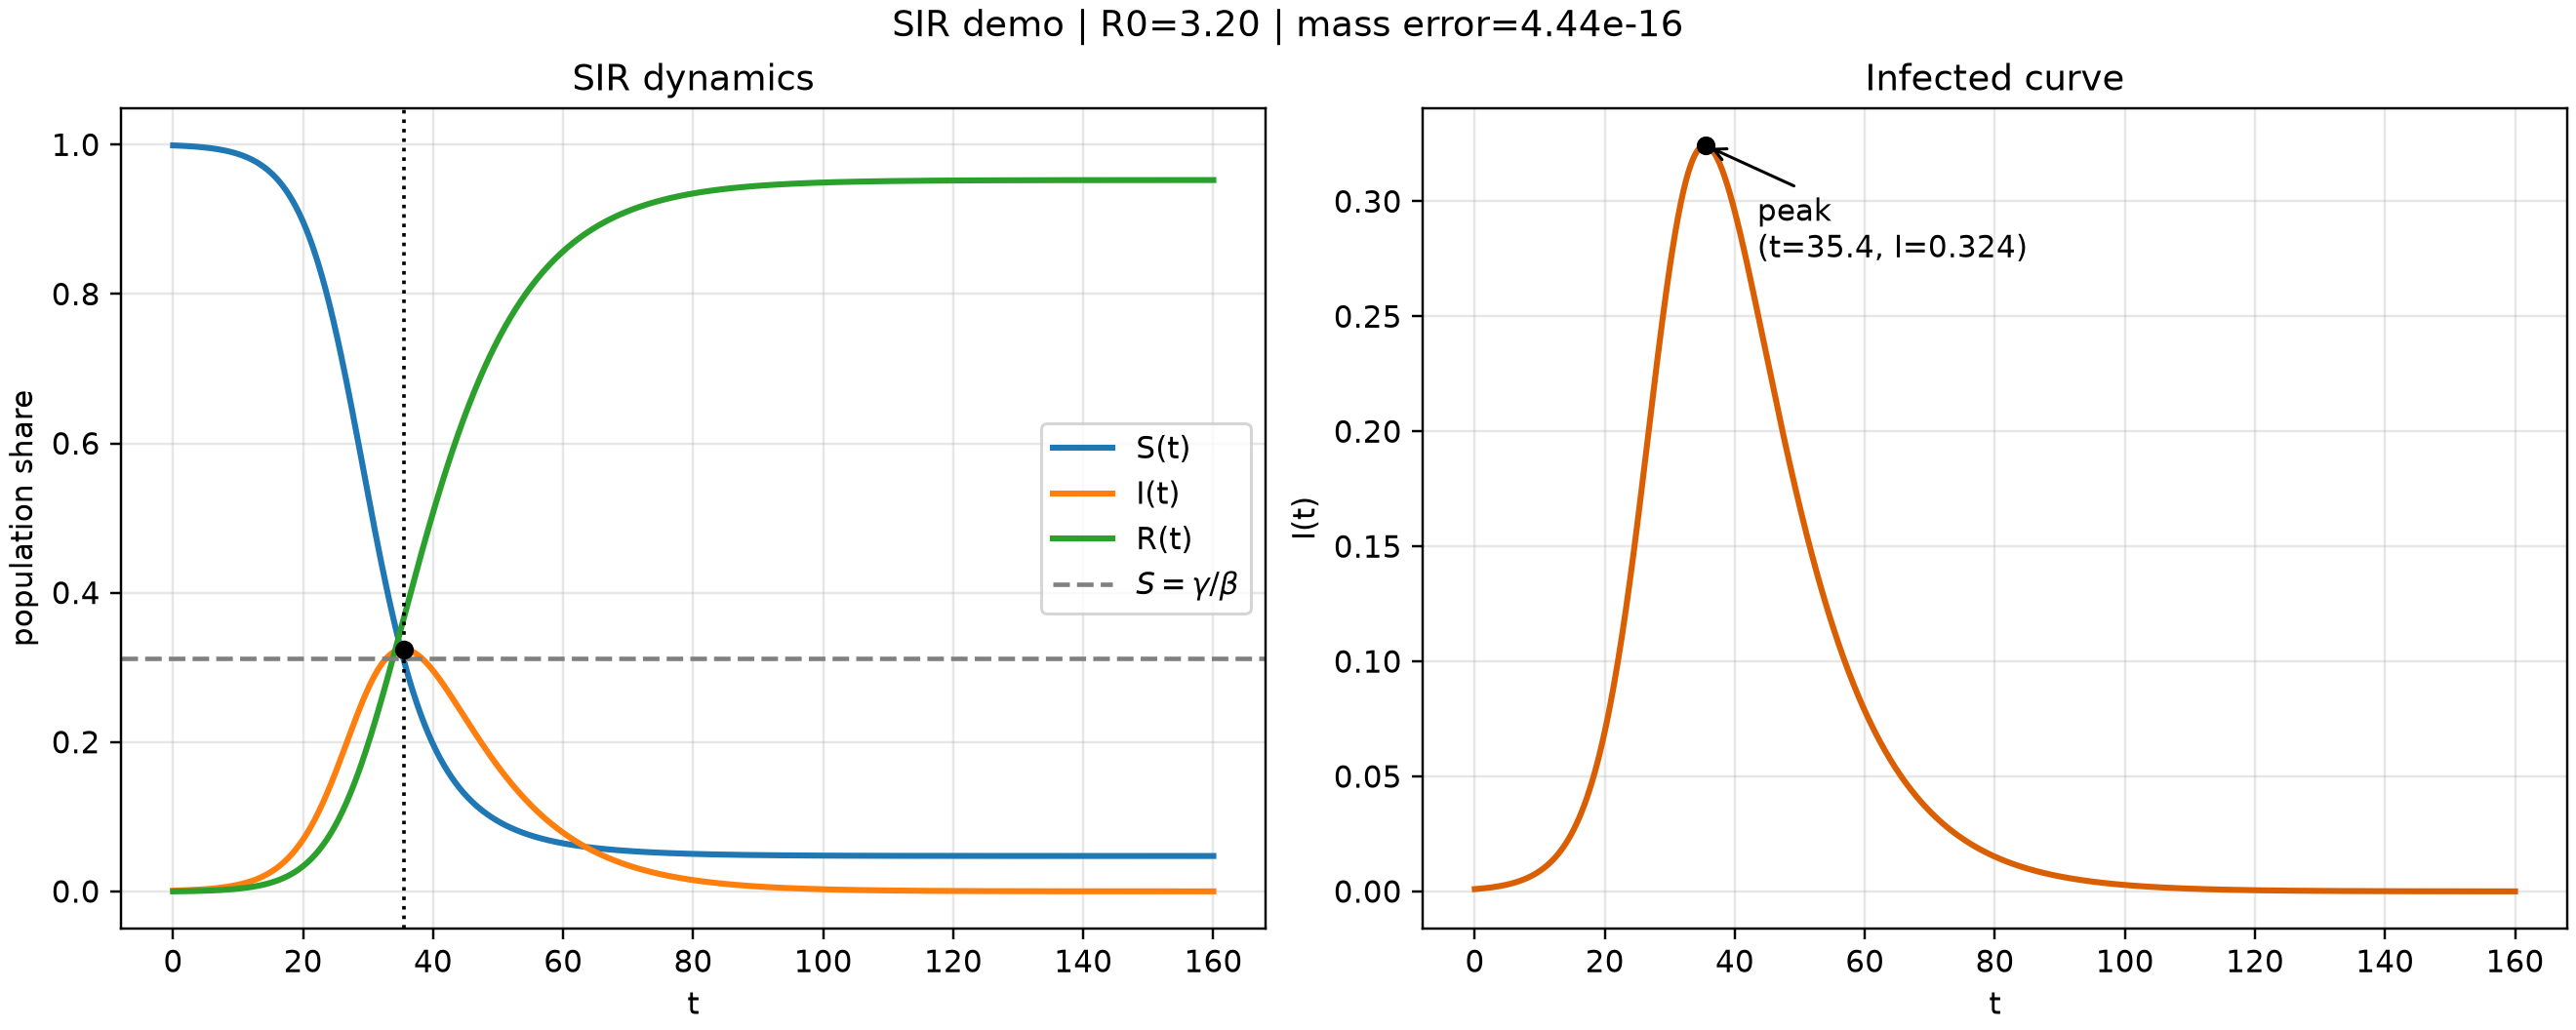
图左边是 S/I/R 的时间演化,图右边标出了感染者峰值。
你会看到:I(t) 先抬升到峰值,再逐渐回落;S(t) 在峰值时刻附近已经下降到阈值附近。
这一节的 takeaway:曲线先升后降,不是求解器画出来的巧合,而是新增感染和康复两股流的胜负变化。
6. 一份可复用的写法
以后写类似模型,基本可以套这个框架:
def rhs(t, y, params):
    # 拆出状态变量
    # 写出每个状态的变化率
    # 返回导数向量
    ...

sol = solve_ivp(
    lambda t, y: rhs(t, y, params),
    (t0, t1),
    y0,
    t_eval=t_eval,
)
这一类文章最关键的不是代码长短,而是把每个变量的物理意义讲清楚。
只要这一层清楚,后面无论写 SEIR、Lotka-Volterra,还是更复杂的多群体传播模型,结构都会很顺。
先让读者看到“三只桶怎么流”,再去看符号和推导,墙就会低很多。
这一节的 takeaway:换成别的方程组时,仍然先写清状态变量,再写每个变量的变化速度。
7. 小结
这一篇完成了两件事:
- 把单方程 ODE 推进到方程组
- 把“感染峰值”这个现象和阈值条件连了起来
下一篇我会写 Lotka-Volterra 捕食-被捕食模型,重点放在相图和振荡解上。