
我们有什么证据说明 Agent skill evolving 真的需要 Bayesian belief?
上一篇文章里,我讨论了一个问题:
Agent skill evolving 为什么需要贝叶斯?我直接进化不就行了吗?
这个问题很合理。
因为如果一个方法最后只是“错了就改 prompt / 改 skill”,那它确实不一定需要叫 Bayesian。它最多是一个 failure-driven repair loop。
所以这篇文章不继续停留在概念层面,而是回答一个更直接的问题:
我们有什么证据说明 Agent skill evolving 真的需要 Bayesian belief?
我的回答是:我们有两层保证。
第一层是实验保证:在 RealFin-Bench 上,Bayesian skill evolving 相比 frequentist 直接进化更稳。
第二层是理论保证:在小样本、高成本、强不确定性的 agent 任务里,Bayesian posterior mean 在 posterior squared risk 意义下不劣于 frequentist estimate。
这两层合起来,才是我们说 Bayesian-Agent 有价值的原因。
论文地址:http://arxiv.org/abs/2606.08348GitHub:https://github.com/DataArcTech/Bayesian-Agent
一、先看实验:Bayesian vs Frequentist
我们做了一个对照实验。
任务是 RealFin-Bench,一共 40 个金融 agent 任务。它不是简单问答,而是要求 agent:
- 读取金融数据;
- 计算 MACD、RSI、KDJ、Bollinger 等指标;
- 处理空字段、缺失值和异常数据;
- 按严格格式写出结果文件;
- 通过 verifier 的逐项检查。
这个 benchmark 很适合测试 skill evolving,因为 agent 失败时,我们不只是知道“错了”,还能看到它到底错在哪里。
比如是没有写输出文件,是空字段导致计算崩溃,是输出格式不对,还是某个指标条件漏算了。
1.1 两种 evolving 方法的区别
Frequentist control 的思路很直接:
q_F = S / n
也就是用成功次数除以总观察次数,作为某个 skill 或某类行为的可靠性估计。
这个方法非常自然。
如果样本足够多,它也很好。
但 agent skill evolving 的麻烦在于,我们往往没有很多样本。一个 benchmark 可能只有几十个 case;真实业务中的失败更少,而且每个 case 都很贵。
Bayesian-Agent 的做法不是只看经验频率,而是维护一个 belief:
P(skill quality | evidence)
proportional to
P(evidence | skill quality) P(skill quality)
每次 agent 执行后,我们把轨迹、成功失败、failure mode、token cost、latency、metadata 等信息作为 evidence,更新 skill belief。
这个 belief 会影响后续决策:
- 哪些 skill/SOP 更值得保留;
- 哪些 failure mode 只是偶然失败;
- 哪些 failure mode 已经重复出现,应该触发 patch;
- 什么时候 rewrite,什么时候先观望;
- 如何避免一次失败就把 skill 改得过拟合。
1.2 实验结果
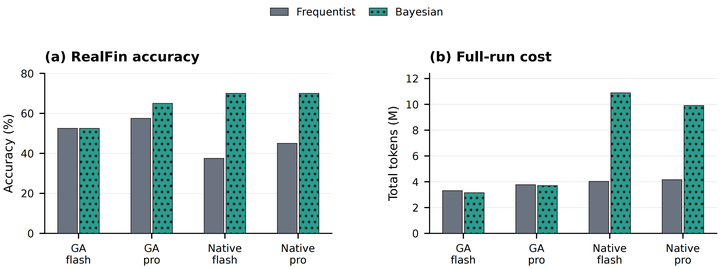
下面是 RealFin-Bench 的 Bayesian vs Frequentist 对照结果。
| Backend | Model | Bayesian | Frequentist | 结论 |
|---|---|---|---|---|
| GA | deepseek-v4-flash | 21⁄40 | 21⁄40 | 打平,但 Bayesian 少用约 161k tokens |
| GA | deepseek-v4-pro | 26⁄40 | 23⁄40 | Bayesian 多过 3 个任务,token 也更少 |
| BA native | deepseek-v4-flash | 28⁄40 | 15⁄40 | Bayesian 多过 13 个任务 |
| BA native | deepseek-v4-pro | 28⁄40 | 18⁄40 | Bayesian 多过 10 个任务 |
这张表的重点不是“Bayesian 永远赢”。
事实上,GA + deepseek-v4-flash 这一组就是打平。
这个结果反而让结论更可信:Bayesian 不是魔法,也不是每个 setting 都无脑碾压。
更准确的结论是:
在样本少、任务贵、失败模式稀疏但信息量很高的场景下,Bayesian skill evolving 比单纯经验频率更稳。
1.3 一个关键 case:为什么 frequentist 会反复遇到早期失败?
在 BA native + deepseek-v4-flash 这一组里:
- Bayesian:28/40;
- Frequentist:15/40。
差距很大。
看具体任务会更清楚:
| Task | Bayesian | Frequentist |
|---|---|---|
| task_29_momentum_reversal_combo | pass | blank-field crash |
| task_30_composite_scoring | pass | missing output file |
| task_31_triple_timeframe_macd | pass | missing output file |
| task_38_feature_engineering | pass | blank-field crash |
这里要说清楚一个容易误解的点。
不是说 frequentist 完全没有记录这些 failure mode,也不是说它看到一次错误后就应该马上把所有同类错误修好。
当前 full self-evolving 实验是在线单遍运行。第 4 个任务失败后,不会马上回头重跑第 4 个任务;它只能影响后面的任务。
而且 missing output file、blank field crash 这类标签是 failure mode,不一定是唯一根因。
同样叫 missing output file,背后可能是:
- 模型忘了写文件;
- 计算脚本中途崩了;
- 工具调用轮次不够;
- 数据字段没处理好;
- 输出路径理解错了。
所以重复 fail mode 的出现,不代表系统完全没改,而是说明同一个粗粒度 failure mode 在不同任务里还会以不同根因反复出现。
Bayesian 的优势不是“神奇地一次 patch 全修好”,而是对这些重复出现的失败更保守、更结构化地累计证据。
在实验里,Bayesian skill evolving 更稳定地保留了几类 guardrails:
- 先保证 output file 必须存在;
- 空字段不能让计算直接崩;
- 多指标任务要拆成 verifier predicate 逐项满足;
- failure mode 重复出现后,再触发更强的 skill patch。
这就是实验层面的第一个保证:
Bayesian 不是“看到错就改”,而是把失败轨迹转成 evidence,再用 evidence 更新 skill belief。
它解决的不是“永远不再出现同类错误”,而是让系统在重复错误面前有更稳的证据累计和改写决策。
二、再看理论:为什么小样本下 frequentist 会抖?
理论部分可以连成一条链:
frequentist 在小样本下容易抖;
Bayesian 用 posterior mean 做平滑;
在平方损失下,posterior mean 有一个“不劣于”经验频率的风险保证。
先看 frequentist。
假设某个 skill 的真实成功率是 p,观察到 S 次成功,总共执行 n 次。
Frequentist 最自然的估计是:
q_F = S / n
这个估计在大样本下很好。
但 agent skill evolving 的问题是:我们通常没有大样本。
一个 benchmark 可能只有几十个任务,一个真实业务 failure mode 可能一周才出现几次。
经验频率估计的方差是:
Var(q_F) = p(1 - p) / n
当 n 很小时,这个方差会很大。
只观察 1 次时尤其明显:
- 成功一次,
q_F = 1; - 失败一次,
q_F = 0。
如果直接拿这种极端估计指导 skill rewrite,就容易出现两个问题:
- 一次偶然成功,让系统过度相信一个 skill;
- 一次偶然失败,让系统过度改写一个 skill。
这就是小样本下“直接进化”的不稳定来源。
2.1 Bayesian 如何缓解?
Bayesian 的做法不是否定经验,而是让经验和先验一起说话。
最简单的情况,可以把 skill 成功率建模成 Beta-Bernoulli:
p ~ Beta(alpha_0, beta_0)
观察到 S 次成功、F 次失败后,后验是:
p | evidence ~ Beta(alpha_0 + S, beta_0 + F)
后验均值,也就是 Bayesian estimate,可以写成:
q_B = E[p | evidence]
    = (alpha_0 + S) / (alpha_0 + beta_0 + S + F)
它和 q_F = S / n 最大的区别是:q_B 不会在小样本下直接跳到 0 或 1。
先验 alpha_0, beta_0 会提供 smoothing。
当观察很少时,posterior 更保守;当观察越来越多时,数据逐渐主导,Bayesian 估计也会靠近 frequentist 估计。
所以 Bayesian 不是反经验,而是:
在样本少时不盲信经验;在样本多时让经验说话。
2.2 理论保证:Bayesian 不劣于 Frequentist
论文里给出了一个简洁的理论结论。
设 q_F 是经验频率估计,q_B 是 Bayesian posterior mean。在平方损失下:
E[L(q_F, theta_omega) | S,n]
- E[L(q_B, theta_omega) | S,n]
= (q_F - q_B)^2 >= 0
这说明:
在 posterior squared risk 意义下,Bayesian posterior mean q_B 不劣于 frequentist estimate q_F。
如果 q_F = q_B,两者一样;如果 q_F != q_B,Bayesian 的 posterior expected loss 更低。
完整证明可以看论文里的理论分析部分。这里保留最关键的结论:
在小样本 skill evolving 里,如果我们用 posterior risk 来衡量估计质量,那么 Bayesian posterior mean 至少不比经验频率差。
2.3 这对 skill rewrite 意味着什么?
Agent skill evolving 里,我们最怕的不是“不改”。
更怕的是“乱改”。
如果一次失败就 rewrite skill,很容易过拟合某个 case。
如果永远不改,又无法从错误中学习。
Bayesian 给了一个中间路径:
rewrite if expected_gain - expected_cost - uncertainty_penalty > 0
也就是:
Decision = E[Delta success | evidence]
           - lambda * token_cost
           - rho * uncertainty
这不是为了把工程说得复杂,而是表达一个很朴素的原则:
- 一次失败不一定值得改;
- 重复出现的失败才更值得改;
- 高置信度的 failure mode 更值得写进 skill;
- 低置信度的偶然失败应该先记录,不要马上污染 skill。
这就是理论层面的第二个保证:
Bayesian update 能把先验、证据、不确定性和改写成本放到同一个决策框架里。
2.4 failure mode 也可以 Bayesian 化
真实 agent 失败不是只有 success / fail。
失败也分类型:
- missing output file;
- blank field crash;
- invalid output format;
- wrong indicator calculation;
- missing verifier predicate。
这时可以用 categorical / Dirichlet belief:
theta ~ Dirichlet(alpha_1, alpha_2, ..., alpha_K)
如果第 k 类 failure mode 出现了 c_k 次,则:
P(failure_mode = k | evidence)
= (alpha_k + c_k) / sum_j(alpha_j + c_j)
这有什么用?
它让系统知道:某个 failure mode 是不是已经从“偶然现象”变成“稳定模式”。
只有当一个 failure mode 的 posterior 足够高,或者重复出现次数超过阈值时,才触发 skill patch。
这就是我们说的“不是情绪化进化,而是证据驱动进化”。
三、所以我们是双重保证
第一重保证:实验上成立。
RealFin-Bench 里,Bayesian 在多个设置下明显超过 frequentist:
- GA + pro:26/40 vs 23/40;
- BA native + flash:28/40 vs 15/40;
- BA native + pro:28/40 vs 18/40;
- GA + flash 打平,但 Bayesian token 更少。
第二重保证:理论上合理。
在小样本下,frequentist 的 S / n 方差大,容易极端;
Bayesian posterior mean 有 prior smoothing,有 uncertainty,有 failure-mode belief,可以更稳地决定:
- 什么时候信一个 skill;
- 什么时候改一个 skill;
- 什么时候只记录失败,不立刻改;
- 什么时候把重复 failure mode 写成 patch。
最后总结
如果任务很便宜、样本很多、失败成本低,直接按频率进化当然可以。
但 agent 任务往往不是这样。
真实 agent 每跑一个 case 都很贵:
tokens 贵,latency 高,benchmark case 少,真实业务失败更少。
这时 skill evolving 最需要的不是“改得快”,而是“改得稳”。
Bayesian-Agent 的核心价值就在这里:
它把 agent 的每一次成功、失败、空文件、格式错误、指标漏算,都变成 belief update 的 evidence。
然后再用 posterior belief 指导 skill rewrite。
所以这不是“贝叶斯包装”。
这是一个很实际的工程判断:
当你不能等大样本统计稳定,又不能让一次失败污染整个 skill,Bayesian 是更适合 Agent skill evolving 的学习方式