
那么有的同学就会问了:其实目前Bayesian-Agent的本质也还是根据执行轨迹,看错哪里了去针对性的改skill, 那么我们采用贝叶斯方式建模这个过程的优势在哪里呢?
系列文章更新中。。。
Bayesian-Agent(三):从三门问题到 Bayesian-Agent:Evidence Model、后天学习与 Skill 自进化
Bayesian-Agent (二):不仅是又一个 agent framework,而是可跨 harness 的 Bayesian Evolution Layer
Bayesian Agent (一):让 Harness 与 Skills 的 Self-Evolving过程不再黑盒、没有方向,走向贝叶斯信念
一、这个说法,对也不对?
这个说法其实对,但不全对:表层动作还是“看轨迹、识别失败模式、改 Skill/SOP”。贝叶斯的价值不在于把这个动作说得更玄,而在于给这个过程加了一个可累计、可审计、可迁移的 belief state。
最核心的区别是:
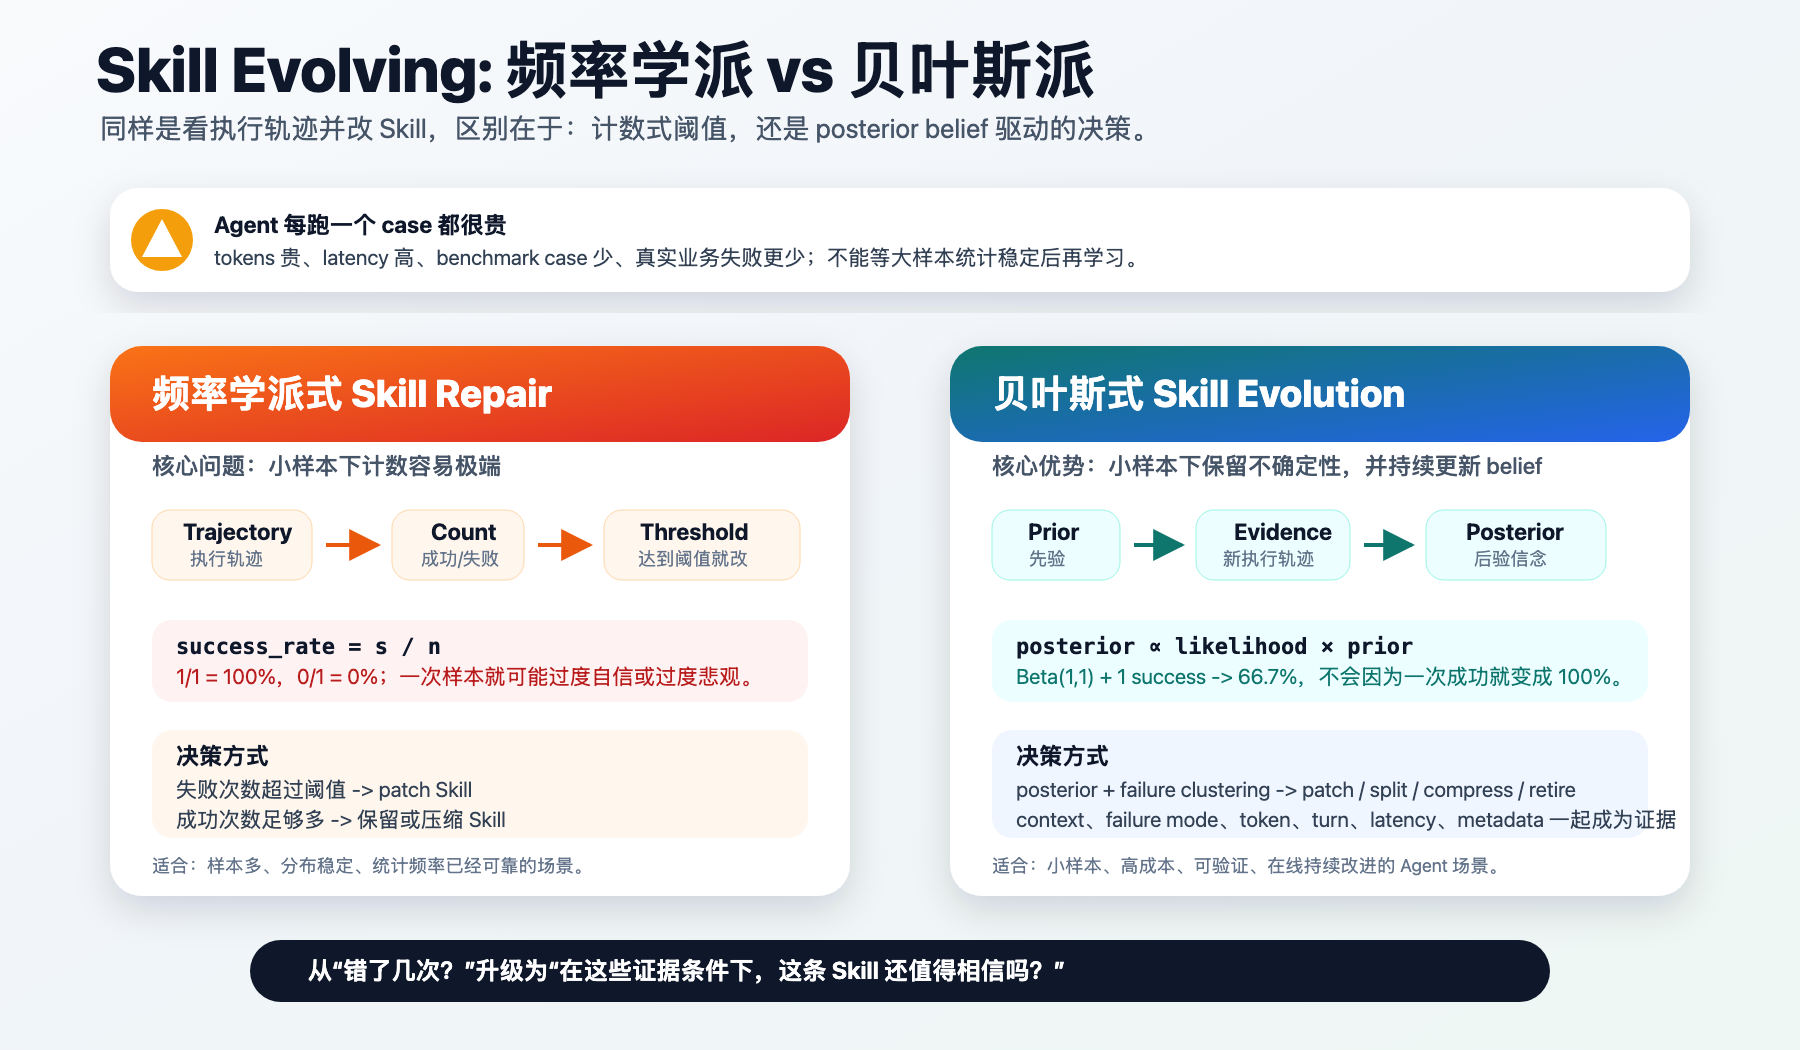
频率学派做法像这样:
这个 failure_mode 出现了 2 次,所以 patch
这个 skill 成功率是 s / n,所以保留或压缩
贝叶斯做法是:
我对 skill h 的可靠性有一个先验 belief
每条 verified trajectory 是 evidence
根据 likelihood 更新 posterior
再用 posterior 决定 patch / split / compress / retire / explore
公式上,最简单的 Beta-Bernoulli 是:
p_h ~ Beta(alpha_0, beta_0)

p_h | D_h ~ Beta(alpha_0 + s_h, beta_0 + f_h)

E[p_h | D_h] = (alpha_0 + s_h) / (alpha_0 + beta_0 + s_h + f_h)
如果用频率估计,一次成功后成功率就是 1/1 = 100%;贝叶斯 posterior 是 (1+1)/(1+1+1)=2/3。这就很重要:它不会因为一个样本就过度自信。
当前 Bayesian-Agent 里更主要的是 categorical likelihood model:
P(y | h, x) ∝ P(y | h) * product_j P(x_j | y, h)
其中:
y = success or failure
h = 某个 Skill/SOP hypothesis
x = trajectory evidence features
当前代码里的 evidence features 包括:
context
failure_mode
token_bucket
turn_bucket
latency_bucket
metadata.*
所以它不是只问“失败了几次”,而是问:
在这个 task context 下,
带着这个 failure_mode,
消耗这个 token bucket,
用了这个 turn bucket,
落在这个 latency bucket,
以及这些 metadata 条件时,

这个 Skill 更像会成功,还是更像会失败?
这就是贝叶斯相比普通计数的第一层优势:小样本下不极端,且能把多种证据统一进一个 posterior。
在我们框架里,贝叶斯优势已经体现在这些地方:
-
Skill reliability 不是裸成功率,而是 posterior belief
SkillBelief里维护alpha/beta、categorical_bayes、contexts、failure_modes、token/latency 均值。Skill 不再只是文本,而是“文本 + 证据状态”。 -
失败不是马上改,而是看 evidence 是否聚类
当前 policy 是 failure mode 至少出现 2 次才patch,这就是为了避免“一次失败就过拟合改 Skill”。 -
token / turn / latency 进入 likelihood
这点很关键。一个 Skill 成功但花 1M tokens,和成功且花 10k tokens,在贝叶斯 evidence model 里不是同一种证据。它让我们可以往“又准又省”的 Skill 进化。 -
能做增量修复
GA、Claude Code、BA native harness 的轨迹都可以转成统一 evidence。贝叶斯层可以从已有 Agent 的失败轨迹开始更新 posterior,然后只重跑失败任务。这比“重训一个 Agent”轻很多。 -
跨 harness 可迁移
因为 posterior 绑定的是 normalized trajectory evidence,而不是某个 harness 的内部状态。GenericAgent 跑出来的失败,可以被 Bayesian-Agent 读入,再影响 Claude Code 或 BA native harness 的后续 Skill/SOP context。
当前 Bayesian-Agent 的贝叶斯性体现在:把执行轨迹转化为 posterior belief,并用 posterior 管理 Skill/SOP 的改写、压缩、修复和迁移;它不是简单频率计数,但也还不是完整的贝叶斯推理系统。
一句话总结:
普通 self-evolving 是“错了就改”;Bayesian-Agent 想做的是“知道自己为什么错、在什么条件下错、证据够不够支持改、改完以后 belief 有没有真的变好”。这就是贝叶斯在我们框架里的核心价值。
二、小样本场景是BA最有优势的地方之一
小样本场景是我们方法最有优势的地方之一,但要说得更精确一点:
贝叶斯派相比频率学派的优势不是“小样本一定更准”,而是:
在样本少、每个样本很贵、不能等到大样本统计稳定时,贝叶斯可以把先验、不确定性和新证据统一起来,做更稳健的决策。
放到 Bayesian-Agent 里,就是:
Agent 每跑一个 case 都很贵:
tokens 贵、latency 高、benchmark case 少、真实业务失败更少。

所以我们不能等到某个 failure mode 出现 100 次再统计。
我们需要在 1 次、2 次、3 次失败后,就判断:
要不要 patch?
要不要继续观察?
要不要压缩?
要不要 retire?
这正是贝叶斯适合的地方。
频率学派式做法 如果某个 Skill 跑了 1 次成功:
p_success = 1 / 1 = 100%
如果跑了 1 次失败:
p_success = 0 / 1 = 0%
这在小样本下太极端。
贝叶斯式做法 假设先验是:
p_h ~ Beta(1, 1)
跑 1 次成功后:
p_h | D ~ Beta(2, 1)
E[p_h | D] = 2 / 3 = 66.7%
跑 1 次失败后:
p_h | D ~ Beta(1, 2)
E[p_h | D] = 1 / 3 = 33.3%
它不会因为一次成功就过度相信,也不会因为一次失败就立刻判死刑。这对 Skill evolution 很重要,因为 LLM agent 的失败经常有随机性、环境性和任务偶然性。
在我们的方法里,更适合的场景主要是这些:
| 场景 | 为什么 Bayesian-Agent 更合适 |
|---|---|
| 小样本 benchmark / 真实业务 case 少 | 不能靠大样本频率统计,posterior 可以用少量 evidence 做稳健更新 |
| 每次执行成本高 | 每条 trajectory 都要花 token、时间、API 成本,需要最大化 evidence 利用率 |
| 失败模式可复用 | 比如 left_expected_output_blank、invented_unrequested_column,一次失败可以转化为后续 Skill patch |
| 需要在线学习 | 不重新训练模型参数,只根据新轨迹更新 Skill belief 和 SOP |
| 需要增量修复已有 Agent | GA/Claude Code/其他 harness 跑错的 case,可以作为 Bayesian evidence 输入,只修失败部分 |
| 任务分布会变化 | posterior 可以持续更新,而不是固定一版 prompt/SOP |
| 不仅关心准确率,也关心 token/turn/latency | 当前 categorical likelihood 已经把 token bucket、turn bucket、latency bucket 纳入 evidence |
所以我们的核心 claim 可以是:
Bayesian-Agent is especially useful for sample-scarce, cost-sensitive, online Skill/SOP evolution.
中文就是:
Bayesian-Agent 特别适合小样本、高成本、可验证、可持续积累经验的 Agent Skill/SOP 进化场景。
相对的,下面这些场景我们优势没那么大:
| 场景 | 原因 |
|---|---|
| 样本极多,分布稳定 | 频率估计已经足够好 |
| 没有 verifier,无法判断成功失败 | posterior 没有可靠 evidence |
| failure 完全随机,不可复用 | 改 Skill 没意义 |
| 问题本质需要参数训练 | 那应该 fine-tune / RL / pretrain,而不是只改 Skill |
| 一次性任务,不会重复出现类似 case | Skill evolution 的收益有限 |
所以Bayesian-Agent最适用的情况是:
在 Agent 工程里,我们面对的不是大样本离线统计,而是小样本、高成本、连续到来的 verified trajectories。贝叶斯方法天然适合把这些稀疏经验转化为可更新、可审计、可迁移的 Skill belief。
这也是为什么它比“错了就 patch”更有价值:它不是只记录错误,而是持续维护“某个 Skill 在什么条件下可信”的 posterior。
三、总结
普通 self-evolving agent 的逻辑是:错了就改。
Bayesian-Agent 想做的是:知道为什么错, 知道在什么条件下错, 知道证据够不够支持改, 知道改完以后 belief 有没有真的变好。
频率式 repair 关注的是“出现了几次”。Bayesian-Agent 关注的是:在当前证据条件下,这条 Skill 还值得相信吗?
这就是贝叶斯在 Bayesian-Agent 框架里的核心价值。