
系列文章更新中。。。
- wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀
- wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践
- 20251203难产的第三篇虽迟但到orz: 强化学习小白理解GRPO(三):适配自定义任务,以Finance-R1为例
- 强化学习小白理解GRPO(四):从 Advantage 加权到分布重塑,SFT、RL 和OPD原来是一家人
Open-R1代码链接:GitHub - huggingface/open-r1: Fully open reproduction of DeepSeek-R1
在上一篇《强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀》中,我们从理论角度深入探讨了GRPO(Group Relative Policy Optimization)的核心思想,尤其是其通过重要性采样、优势函数和KL散度来优化策略模型的方法。本篇我们将结合Huggingface开源的Open-R1项目(按照他的readme亲测可运行正常),通过代码实践来进一步理解GRPO的实现细节,并将代码与第一篇的理论内容一一对应。
1. 奖励函数的实现
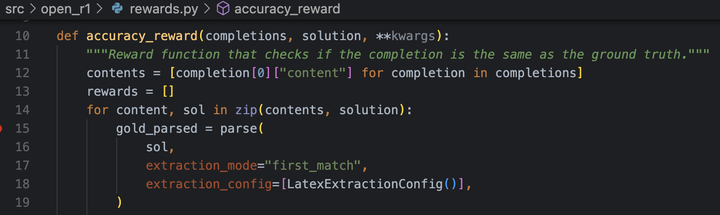
在 GRPO 中,奖励函数的设计至关重要。首先我们就来看看这个奖励函数是啥,代码中提供了一个简单的奖励函数 accuracy_reward,用于判断生成的输出是否正确。
代码链接:https://github.com/huggingface/open-r1/blob/main/src/open_r1/rewards.py
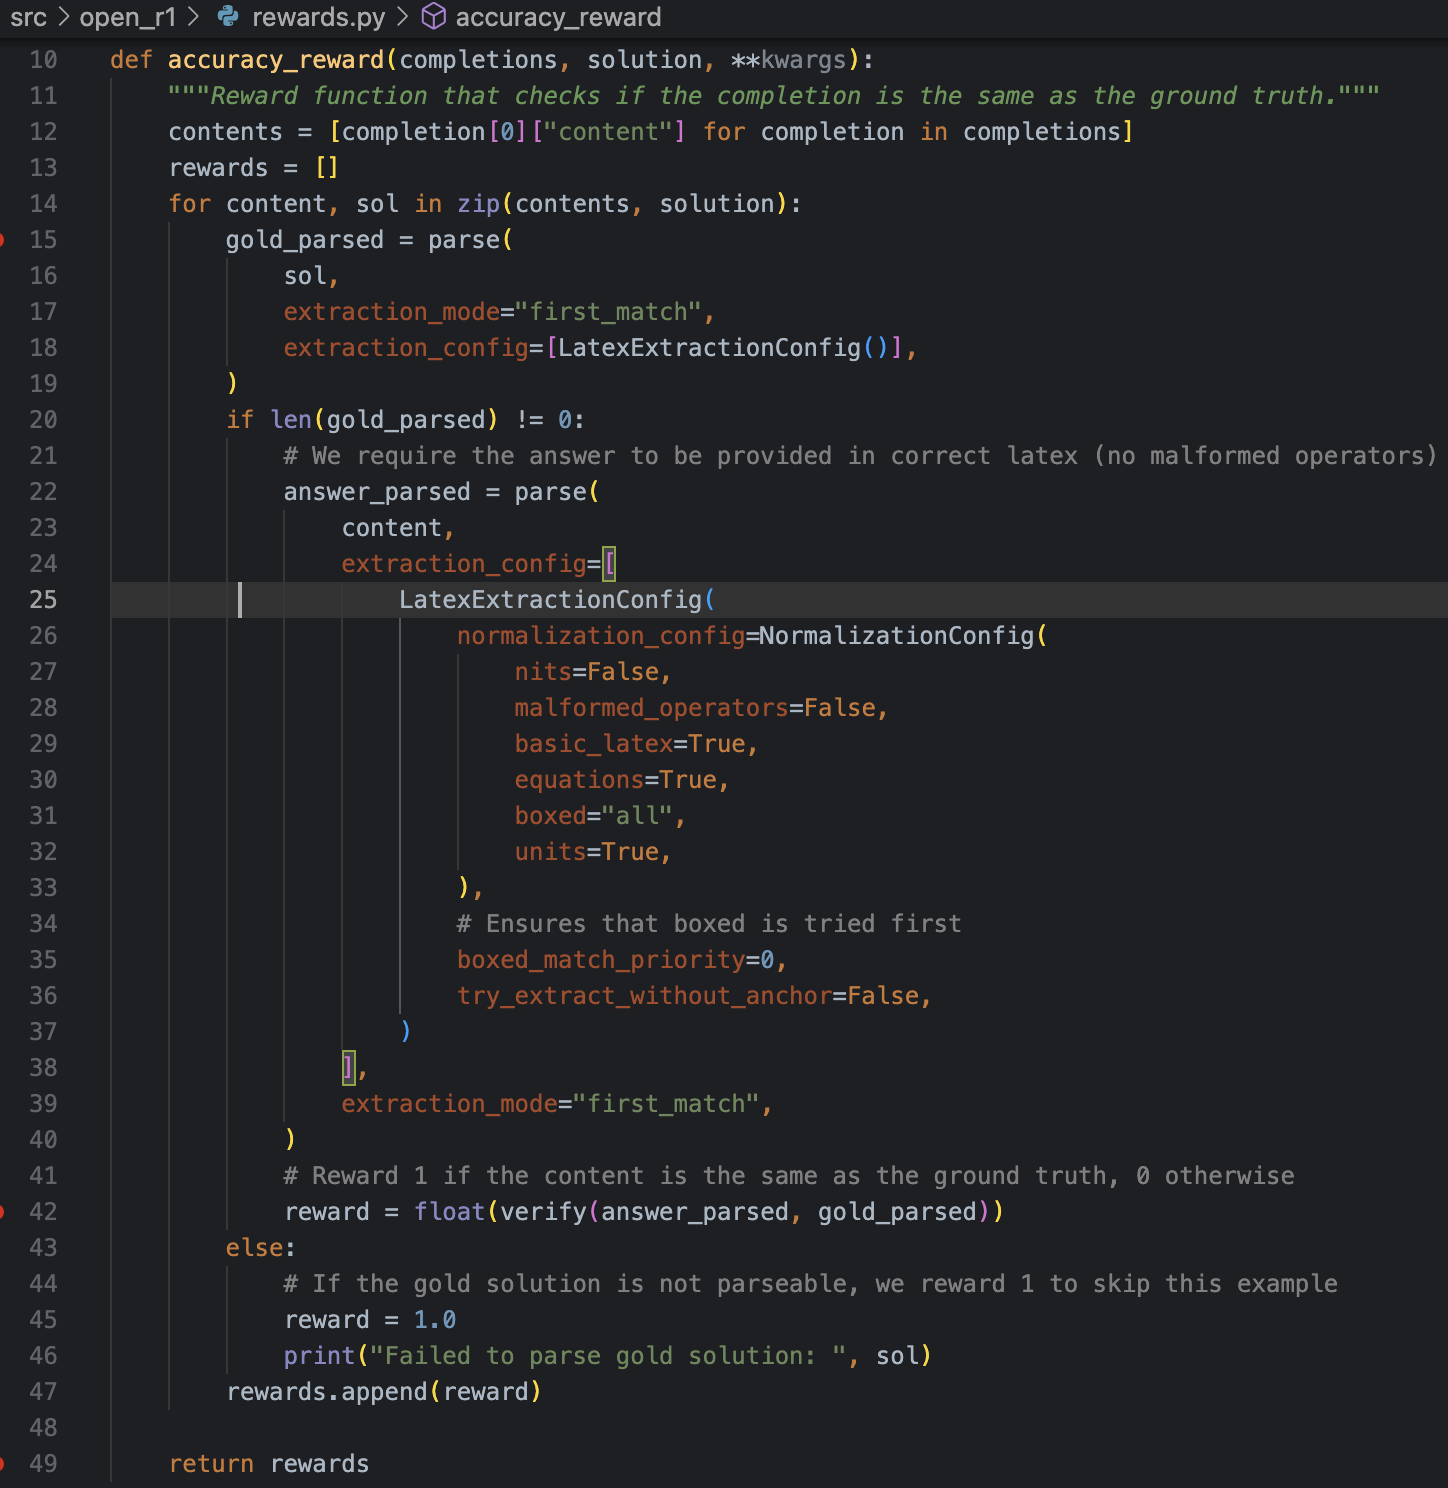
这里举一个原仓库中采用的MATH-lighteval数据的一个例子,我们试验的模型是基于Qwen-2.5-7B:
首先是将问题构造为chatml的格式输入给Qwen:
'<|im_start|>system\nA conversation between User and Assistant. The user asks a question, and the Assistant solves it. The assistant first thinks about the reasoning process in the mind and then provides the user with the answer. The reasoning process and answer are enclosed within <think> </think> and <answer> </answer> tags, respectively, i.e., <think> reasoning process here </think><answer> answer here </answer><|im_end|>\n<|im_start|>user\nThe probability that Kim has a math test today is $\\frac{4}{7}$. What is the probability that Kim does not have a math test today? Express your answer as a common fraction.<|im_end|>\n
<|im_start|>assistant\n'
然后模型的输出如下,也就是上图中14行的content:
"<think>The problem gives us the probability that Kim has a math test today, which is \\(\\frac{4}{7}\\). The probability of an event not occurring is 1 minus the probability of the event occurring. Therefore, we need to subtract \\(\\frac{4}{7}\\) from 1 to find the probability that Kim does not have a math test today.\n\nTo perform this subtraction, we can express 1 as a fraction with the same denominator as \\(\\frac{4}{7}\\). This gives us \\(1 = \\frac{7}{7}\\).\n\nSo, the probability that Kim does not have a math test today is \\(\\frac{7}{7} - \\frac{4}{7}\\).\n\nLet's perform the subtraction to find the final answer.\n</think>\n
<answer>The probability that Kim does not have a math test today is \\(\\frac{3}{7}\\).</answer><|im_end|>"
接下里使用latex的解析器解析出<answer>xxx</answer>里的答案,和真正的答案比较,使用专业的数学verifier判断两个答案是否对,对的话reward就是1,否则就是0,就是这么简单!(这里latex parse和verifier都是现成的python库,工作原理留给读者自己去深究)
这种设计非常适用于数学题等任务,因为答案的正确性可以直接通过对比来判断。
Open-R1其实也实现了Deepseek-R1提到的format_reward,还加上了根据生成答案的长度和正确性使用余弦函数动态调整奖励值和N-gram 的重复率惩罚,最终的reward如下:
REWARD_FUNCS_REGISTRY = {
        "accuracy": accuracy_reward,
        "format": format_reward,
        "reasoning_steps": reasoning_steps_reward,
        "cosine": get_cosine_scaled_reward(
            min_value_wrong=script_args.cosine_min_value_wrong,
            max_value_wrong=script_args.cosine_max_value_wrong,
            min_value_correct=script_args.cosine_min_value_correct,
            max_value_correct=script_args.cosine_max_value_correct,
            max_len=script_args.cosine_max_len,
        ),
        "repetition_penalty": get_repetition_penalty_reward(
            ngram_size=script_args.repetition_n_grams,
            max_penalty=script_args.repetition_max_penalty,
        ),
    }
2. GRPO Trainer的核心代码解析
其实核心代码并不在Open-R1这个项目上,而是huggingface更之前开源的TRL这个库的GRPOTrainer这里,
https://github.com/huggingface/trl/blob/main/trl/trainer/grpo_trainer.py
通过debug,我们发现在GRPOTrainer中,最核心的又是_prepare_inputs()这个函数:
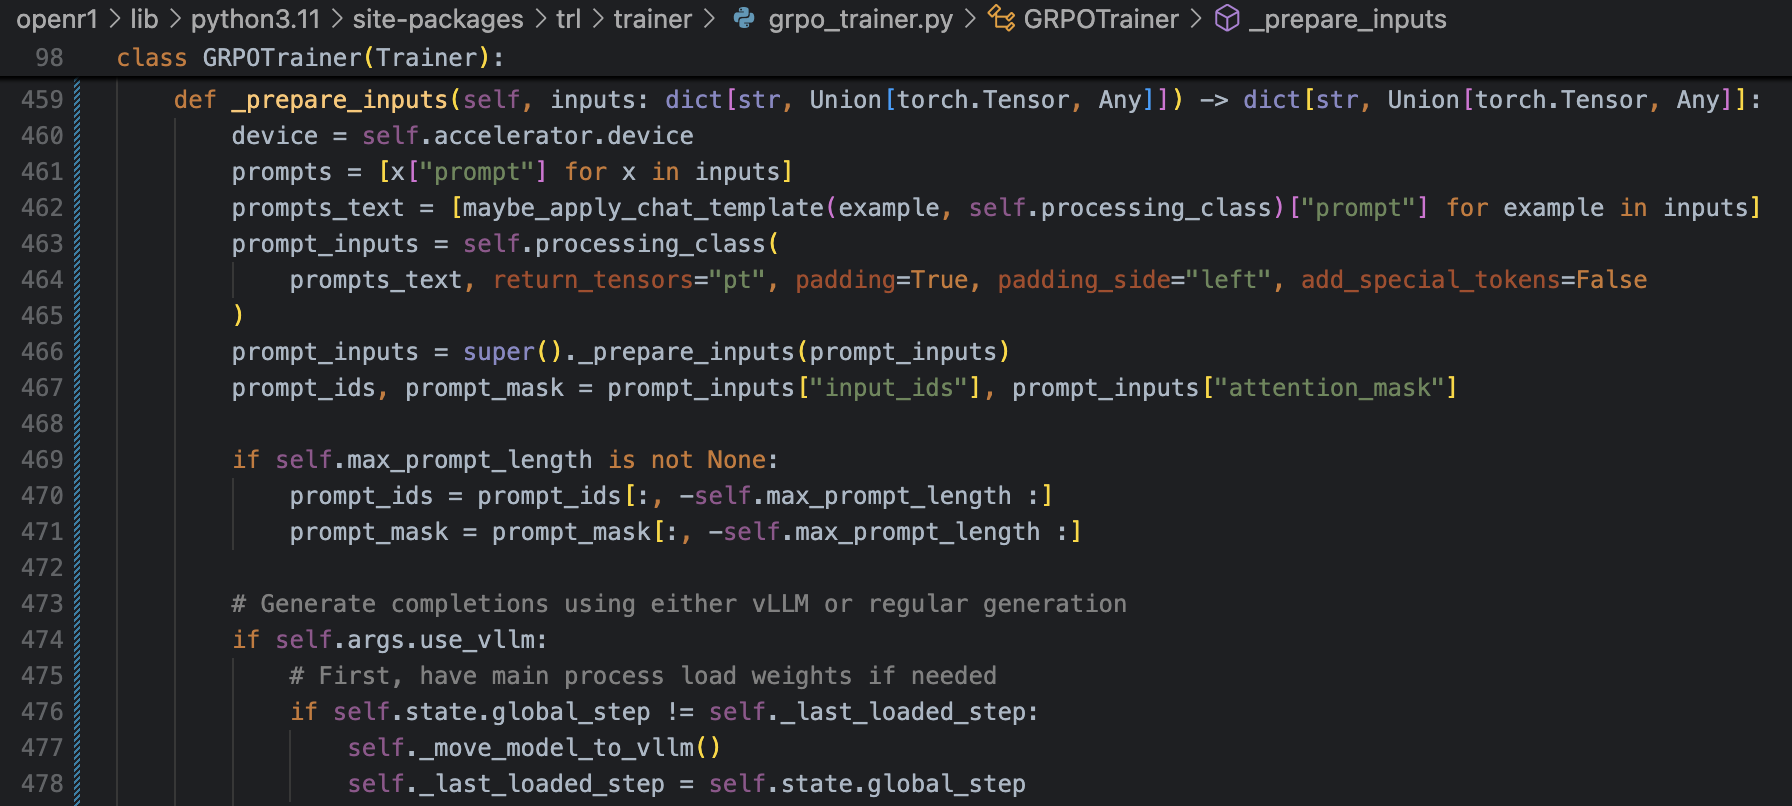
非常棒!,我们来拆解下GRPO Trainer的核心代码,这部分代码主要负责准备输入数据、生成模型输出、计算奖励和优势函数,最终返回优化所需的各项指标。
2.1 生成模型输出
在代码中,模型通过vllm推理引擎生成 completion_ids 来生成输出。具体来说:
# Generate completions using either vLLM or regular generation
if self.args.use_vllm:
    outputs = self.llm.generate(all_prompts_text, sampling_params=self.sampling_params, use_tqdm=False)
    completion_ids = [out.token_ids for completions in outputs for out in completions.outputs]
else:
    with unwrap_model_for_generation(self.model, self.accelerator) as unwrapped_model:
        prompt_completion_ids = unwrapped_model.generate(
            prompt_ids, attention_mask=prompt_mask, generation_config=self.generation_config
        )
这里,模型生成输出 completion_ids 的过程,实际上是从旧策略(当前模型)中采样一组输出。这些输出将被用于计算新策略的优化目标。
2.2 计算奖励与优势函数
接下来,代码中通过计算奖励和优势函数来优化策略模型。这部分对应了理论中的 优势函数 和 奖励标准化。
rewards_per_func = torch.zeros(len(prompts), len(self.reward_funcs), device=device)
        for i, (reward_func, reward_processing_class) in enumerate(
            zip(self.reward_funcs, self.reward_processing_classes)
        ):
            if isinstance(reward_func, nn.Module):  # Module instead of PretrainedModel for compat with compiled models
                if is_conversational(inputs[0]):
                    messages = [{"messages": p + c} for p, c in zip(prompts, completions)]
                    texts = [apply_chat_template(x, reward_processing_class)["text"] for x in messages]
                else:
                    texts = [p + c for p, c in zip(prompts, completions)]
                reward_inputs = reward_processing_class(
                    texts, return_tensors="pt", padding=True, padding_side="right", add_special_tokens=False
                )
                reward_inputs = super()._prepare_inputs(reward_inputs)
                with torch.inference_mode():
                    rewards_per_func[:, i] = reward_func(**reward_inputs).logits[:, 0]  # Shape (B*G,)
            else:
                # Repeat all input columns (but "prompt" and "completion") to match the number of generations
                keys = [key for key in inputs[0] if key not in ["prompt", "completion"]]
                reward_kwargs = {key: [example[key] for example in inputs] for key in keys}
                output_reward_func = reward_func(prompts=prompts, completions=completions, **reward_kwargs)
                rewards_per_func[:, i] = torch.tensor(output_reward_func, dtype=torch.float32, device=device)
# Gather the reward per function: this part is crucial, because the rewards are normalized per group and the
# completions may be distributed across processes
rewards_per_func = gather(rewards_per_func)

# Sum the rewards from all reward functions
rewards = rewards_per_func.sum(dim=1)

# Compute grouped-wise rewards
mean_grouped_rewards = rewards.view(-1, self.num_generations).mean(dim=1)
std_grouped_rewards = rewards.view(-1, self.num_generations).std(dim=1)

# Normalize the rewards to compute the advantages
mean_grouped_rewards = mean_grouped_rewards.repeat_interleave(self.num_generations, dim=0)
std_grouped_rewards = std_grouped_rewards.repeat_interleave(self.num_generations, dim=0)
advantages = (rewards - mean_grouped_rewards) / (std_grouped_rewards + 1e-4)
这里,rewards 是模型生成的每个输出的奖励值,通过计算组内均值和标准差,将其标准化为 advantages。优势函数的作用是衡量某个输出相对于平均输出的优劣,从而引导模型优先提升高奖励输出的概率。
2.3 KL散度
在_prepare_inputs()中我们先获得ref模型每个token的概率分布 ref_per_token_logps
with torch.inference_mode():
    if self.ref_model is not None:
        ref_per_token_logps = self._get_per_token_logps(
            self.ref_model, prompt_completion_ids, attention_mask, logits_to_keep
        )
    else:
        with self.accelerator.unwrap_model(self.model).disable_adapter():
            ref_per_token_logps = self._get_per_token_logps(
                self.model, prompt_completion_ids, attention_mask, logits_to_keep
            )
ref_per_token_logps 是参考策略(通常是 SFT 模型)的 log 概率值,用于衡量新策略与参考策略之间的差异。
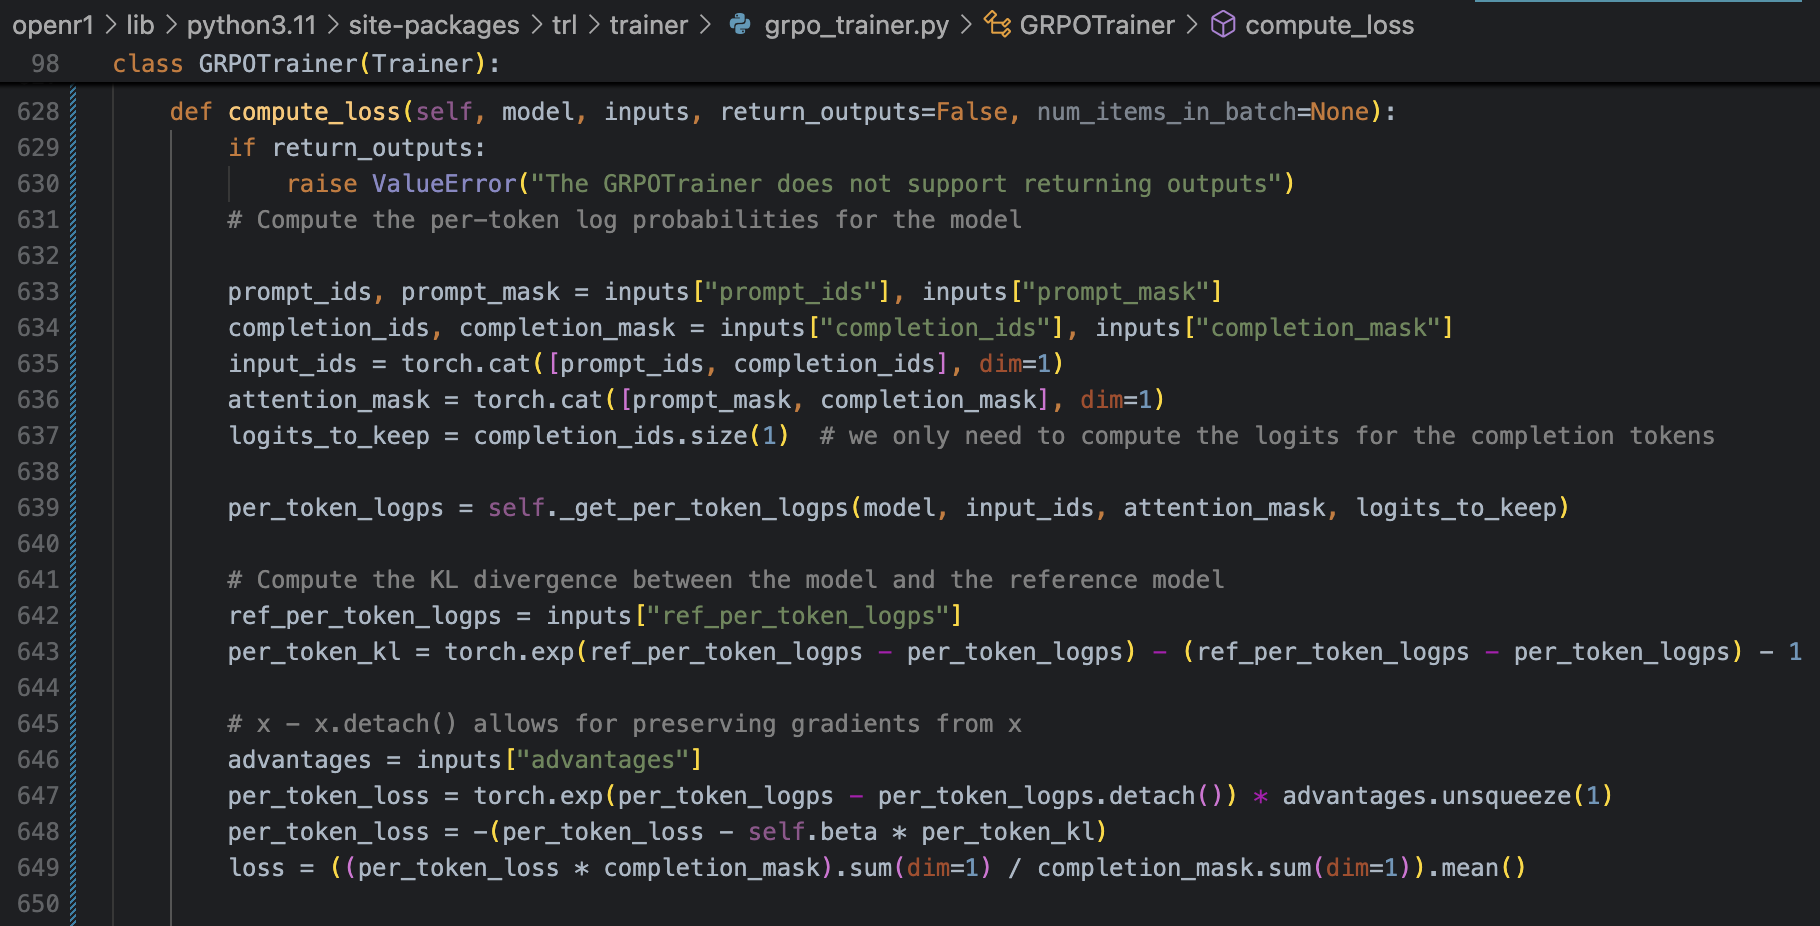
在 compute_loss 函数中,KL 散度的计算是通过以下代码实现的:
per_token_kl = torch.exp(ref_per_token_logps - per_token_logps) - (ref_per_token_logps - per_token_logps) - 1
这里,ref_per_token_logps 是参考策略(通常是 SFT 模型)的 log 概率值,而 per_token_logps 是新策略的 log 概率值。KL 散度的公式为:
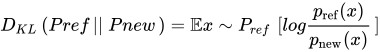
在代码中,KL 散度通过以下近似公式计算:
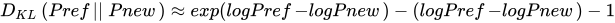
这种计算方式避免了直接计算对数概率的比值,提高了数值稳定性。
要理解为什么代码中的公式是 KL 散度的近似计算方式,我们需要从 KL 散度的定义出发,并推导出其等价形式。
这里其实采用了泰勒展开的近似计算
在语言模型中,通常使用对数概率(log probabilities)来表示分布,对数除法可以转换为减法因此DKL可以改写为:
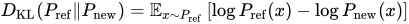
我们可以通过泰勒展开的方式,将 KL 散度进一步简化为一个更稳定的近似公式。
(1) 定义差值
令 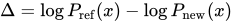 ,即对数概率的差值。
KL 散度可以重写为:
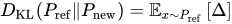
(2) 泰勒展开
为了提高数值稳定性,我们可以对指数函数  进行泰勒展开。指数函数的泰勒展开为:
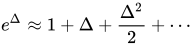
因此,  的近似形式为:
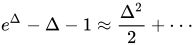
当 \( \Delta \) 较小时,高阶项可以忽略,因此:
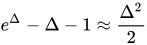
(3) 替换回 KL 散度
将 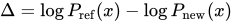 代入,得到:
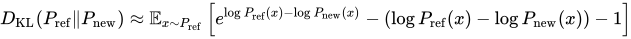
这正是compute_loss代码中实现的公式
2.4 重要性采样
重要性采样是 GRPO 的核心机制之一,它通过复用旧策略的样本来估计新策略的优化方向。在代码中,重要性采样体现在 per_token_logps 计算中。
per_token_logps = self._get_per_token_logps(model, input_ids, attention_mask, logits_to_keep)
这里,per_token_logps 是新策略的 log 概率值。重要性采样的核心思想是通过调整样本权重,用旧策略的样本来估计新策略的期望值。具体来说,重要性权重为:

在代码中,重要性采样权重通过以下方式体现:
per_token_loss = torch.exp(per_token_logps - per_token_logps.detach()) * advantages.unsqueeze(1)
这里,torch.exp(per_token_logps - per_token_logps.detach()) 实际上就是重要性采样。
- Log 概率的差值:
-
per_token_logps - per_token_logps.detach()计算的是新策略和旧策略的 log 概率差值,即: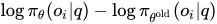
- 根据对数的性质,这个差值可以转化为概率的比值:
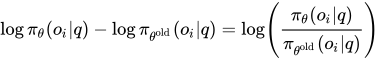
- 指数运算:
- 通过
torch.exp对 log 概率差值进行指数运算,可以得到概率的比值: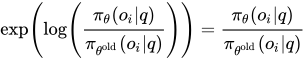
- Detach 的作用:
-
per_token_logps.detach()的作用是将旧策略的 log 概率值从计算图中分离,避免在优化新策略时对旧策略的参数进行更新。 - 这样可以确保重要性采样的权重仅用于调整样本的奖励,而不会影响旧策略的参数。
而*advantages.unsqueeze(1) 就是优势函数啦,用于衡量某个输出相对于平均输出的优劣。通过重要性权重调整优势函数,模型可以优先提升高奖励输出的概率,从而实现策略优化。
2.5 最终loss
最后再回顾第一篇所说的那样,损失函数的构建结合了优势函数和 KL 散度:
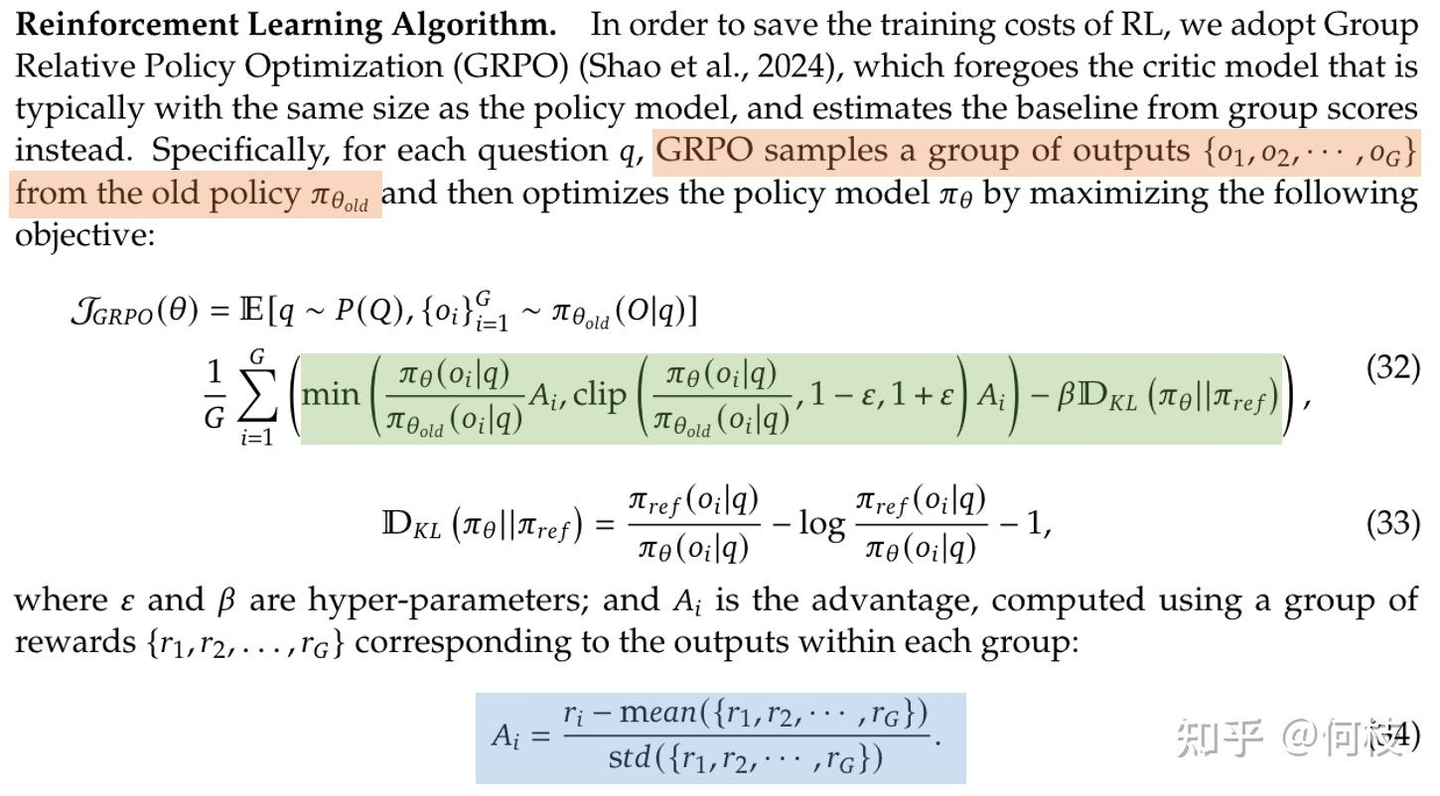
per_token_loss = torch.exp(per_token_logps - per_token_logps.detach()) * advantages.unsqueeze(1)
per_token_loss = -(per_token_loss - self.beta * per_token_kl)
loss = ((per_token_loss * completion_mask).sum(dim=1) / completion_mask.sum(dim=1)).mean()
这里,per_token_loss 由两部分组成:
-
优势函数部分:
torch.exp(per_token_logps - per_token_logps.detach()) * advantages.unsqueeze(1),这部分通过优势函数引导模型优先提升高奖励输出的概率。 -
KL散度部分:
self.beta * per_token_kl,这部分通过 KL 散度限制新策略与参考策略之间的差异,self.beta就是公式中那个 啦。
- (per_token_loss - self.beta * per_token_kl)就是第一篇要最大化的那个
 啦,再加个负号-(per_token_loss - self.beta * per_token_kl)不就是我们要最小化的loss了嘛666。最终,损失函数是每个token的loss的加和然后平均。其中,completion_mask 用于忽略填充部分的损失。
- clip那部分在huggingface这版实现中还没找到,也可能是没实现,因为就像第一篇所说,这一部分其实不是必须的。
最后我们发个预告:第三篇——适配自定义任务
在第三篇中,我们将探讨如何利用 Open-R1 框架适配自定义任务。以 金融股价预测 为例,我们将构建一个 Finance-R1 模型,通过强化学习提升 LLM 在股价预测上的深度推理能力和预测准确性。具体内容包括:
- 任务定义:如何将股价预测任务转化为适合强化学习的格式。
- 奖励函数设计:如何设计适合金融领域的奖励函数,例如基于预测准确性和波动性。
- 模型训练:如何利用 Open-R1 框架进行训练,并调整超参数以优化性能。
- 结果分析:对比传统方法与强化学习方法在股价预测上的表现。
通过第三篇的内容,你将学会如何将 GRPO 应用于实际任务,以金融股价预测为例掌握如何将LLM RL应用到自己的领域。