
上一篇我们从梯度、曲率和参数尺度出发,梳理了 SGD、Adam、AdamW 与 Muon。这一篇换一个视角:金融里的收益与风险。
Adam 的更新大致是:
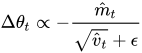
 表示平滑后的梯度方向,
 表示历史梯度的均方根尺度。形式上,它很像“信号除以波动尺度”,因此容易让人联想到 Sharpe ratio。
但这个类比一旦继续追问“哪个参数是资产、哪几个方向组成投资组合”,就会越来越别扭。神经网络训练并没有必要寻找资产的对应物。我们真正需要的只有三个问题:
- 这一步预计能让 loss 下降多少?
- 这一步可能带来多大的不稳定?
- 在风险可控的前提下,应该选择怎样的更新?
所以更准确的说法不是“训练像买一篮子资产”,而是:
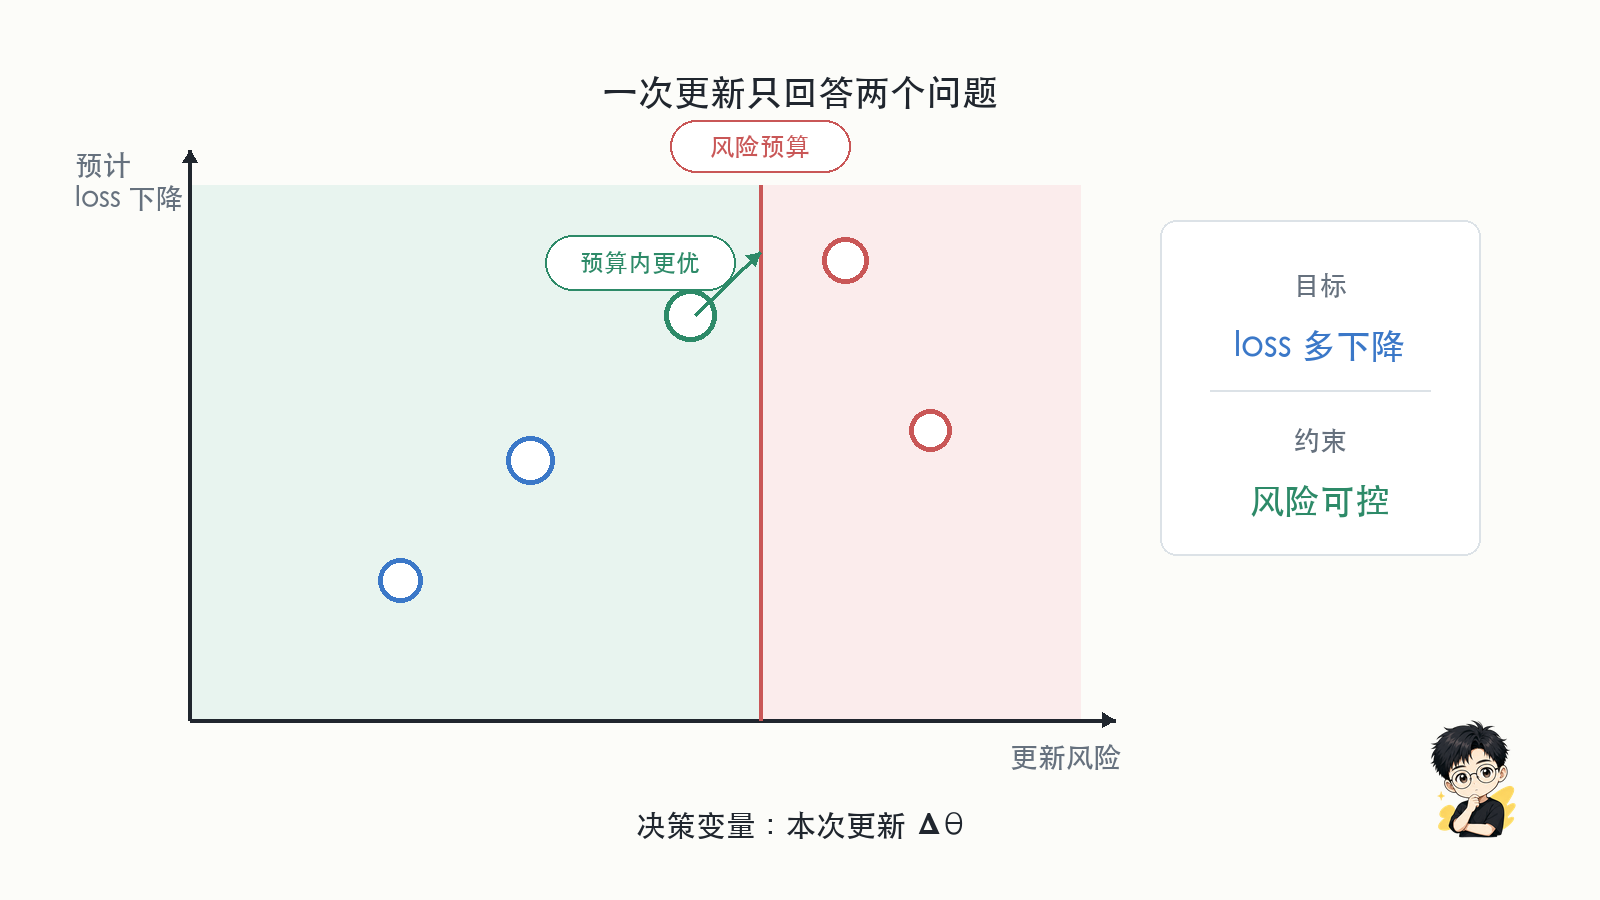
优化器每一步都在选择更新:希望预计 loss 下降尽可能大,同时把更新风险控制在可接受范围内。
这篇的主角仍然是 Adam 与 Muon。我们会依次回答:训练里的收益和风险到底是什么,Adam 如何按参数坐标控制更新尺度,Muon 如何按矩阵整体控制最危险的放大方向,以及为什么不同参数结构会偏好不同的更新约束。
到文章最后,我们再追问一步:既然 Adam 与 Muon 都能放进“风险预算内争取更大 loss 下降”的框架,能不能让优化器自己比较这些候选策略?这个问题会自然引出下一篇的方法,而不是本文预先假定的答案。
1. 收益是什么?就是 loss 下降
模型当前参数是  ,优化器准备执行一次更新:
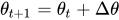
执行以后,真正得到的收益可以直接定义为:
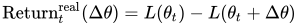
它大于零,说明 loss 下降;它小于零,说明这一步反而让 loss 上升。
问题是,做决定时我们还不知道更新后的 loss,只能利用当前位置的信息进行预测。一阶泰勒近似给出:
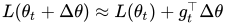
其中 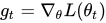 。因此,预计的 loss 下降是:
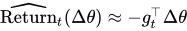
这就是本文所说的“收益”。它不是参数变大,也不是梯度本身,而是一次候选更新预计能换来的 loss 下降。
2. 风险是什么?先区分风险与稳定性约束
训练中的“风险”不是一个天然唯一的数字。
如果严格沿用金融语言,风险首先来自不确定性:同一个更新在不同 mini-batch 上,可能有时让 loss 下降,有时让 loss 上升。我们可以观察 loss 变化的方差、下行波动或最坏尾部。
工程上还会使用一些稳定性代理:更新是否相对权重过大、模型输出是否突然漂移、矩阵是否被少数方向支配。这些量不一定是严格的统计风险,但可以用来限制危险更新。
| 类别 | 可以测什么 | 它在防什么 |
|---|---|---|
| 随机下行风险 | 不同 mini-batch 上的 loss 上升、方差、CVaR | 当前梯度只是噪声,换个 batch 就失效 |
| 参数尺度约束 | update-to-weight ratio、梯度裁剪 | 一步走得过大 |
| 函数稳定性约束 | logits、hidden states、输出分布漂移 | 参数变化不大,模型行为却突然改变 |
| 结构约束 | 坐标尺度、embedding 行漂移、矩阵谱范数 | 用了不适合当前参数结构的更新几何 |
于是一次更新可以写成:
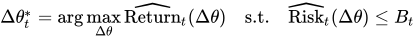
 是允许承担的风险预算。学习率、trust region、梯度裁剪和各种归一化并不完全等价,但都在回答同一类问题:这一步最多允许走多猛。
这个模型已经包含传统优化的三要素:
| 建模要素 | 训练中的含义 |
|---|---|
| 决策变量 | 本次更新 \Delta\theta |
| 目标函数 | 预计 loss 下降 |
| 约束条件 | 风险预算与稳定性约束 |
3. Adam:按坐标调整更新尺度
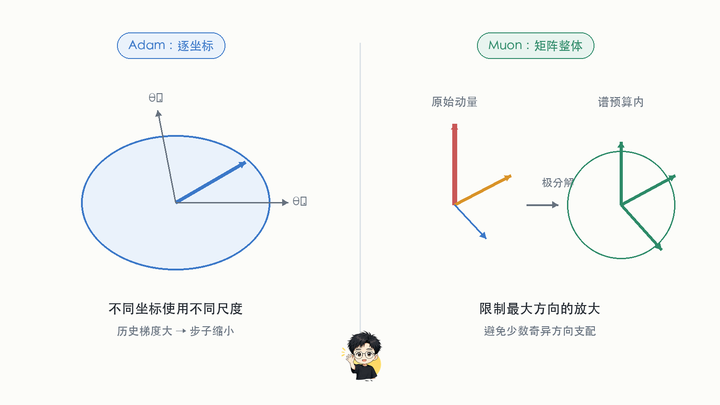
Adam 对第  个参数坐标维护:


更新为:
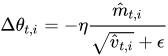
最直观的理解是:
某个坐标的历史梯度尺度大,Adam 就把这个方向的步子缩小;历史尺度小,就允许相对多走一些。
这个思想可以写成一个局部约束优化问题。令
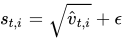
定义逐坐标加权的更新尺度:
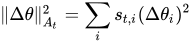
在这个预算内最大化预计下降:
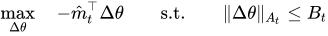
其最优方向满足:
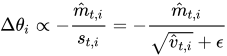
这说明 Adam 可以被理解成:在一个由历史梯度尺度塑造的椭球里,选择预计下降最快的方向。
Adam 是 Sharpe ratio 吗?
只能说直觉相似,不能画等号。
金融里的 Sharpe ratio 通常是超额收益均值除以收益标准差。Adam 的  是梯度平方均值的平方根,并没有减去梯度均值,因此不是严格的标准差;
 也不是严格的 Sharpe ratio。
更稳妥的说法是:
Adam 使用“平滑梯度信号 / 历史梯度尺度”来调节每个坐标的更新,具有收益相对于波动尺度进行归一化的味道。
更关键的区别是:Adam 的比值发生在单个参数坐标上;严格的 Sharpe 问题将在后文发生在多个候选更新方向的预算组合上,还要考虑方向之间的协方差。因此,“像 Sharpe”是帮助入门的局部直觉,不是 Adam 的数学定义。
Adam 在估计曲率吗?
Adam 不是 Hessian 估计器。它没有计算二阶偏导,也没有描述参数之间的耦合曲率。
不过,在深度学习这种非凸、有噪声的训练中,梯度尺度、局部敏感性、梯度噪声与某些曲率现象可能相关。因此 Adam 有时会表现出“敏感方向少走、平缓方向多走”的效果。
所以准确结论是:
Adam 估计的是逐坐标梯度尺度。它可能间接反映部分局部敏感性,但不能等同于牛顿法或对角 Hessian。
4. Muon:按矩阵整体几何选择方向
Adam 把参数看成许多坐标。Muon 针对的则是 MLP、Attention 等 hidden layers 中的二维权重矩阵。
设动量矩阵为  ,奇异值分解是:

原始矩阵中,最大的奇异值方向可能远大于其他方向,于是更新几乎被少数方向支配。Muon 使用 Newton-Schulz 迭代近似矩阵的极分解因子:
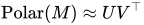
这个变换保留主要奇异方向,但把非零奇异值拉到接近同一尺度。直观上,它不是让矩阵元素一样大,而是不让少数奇异方向独占更新。
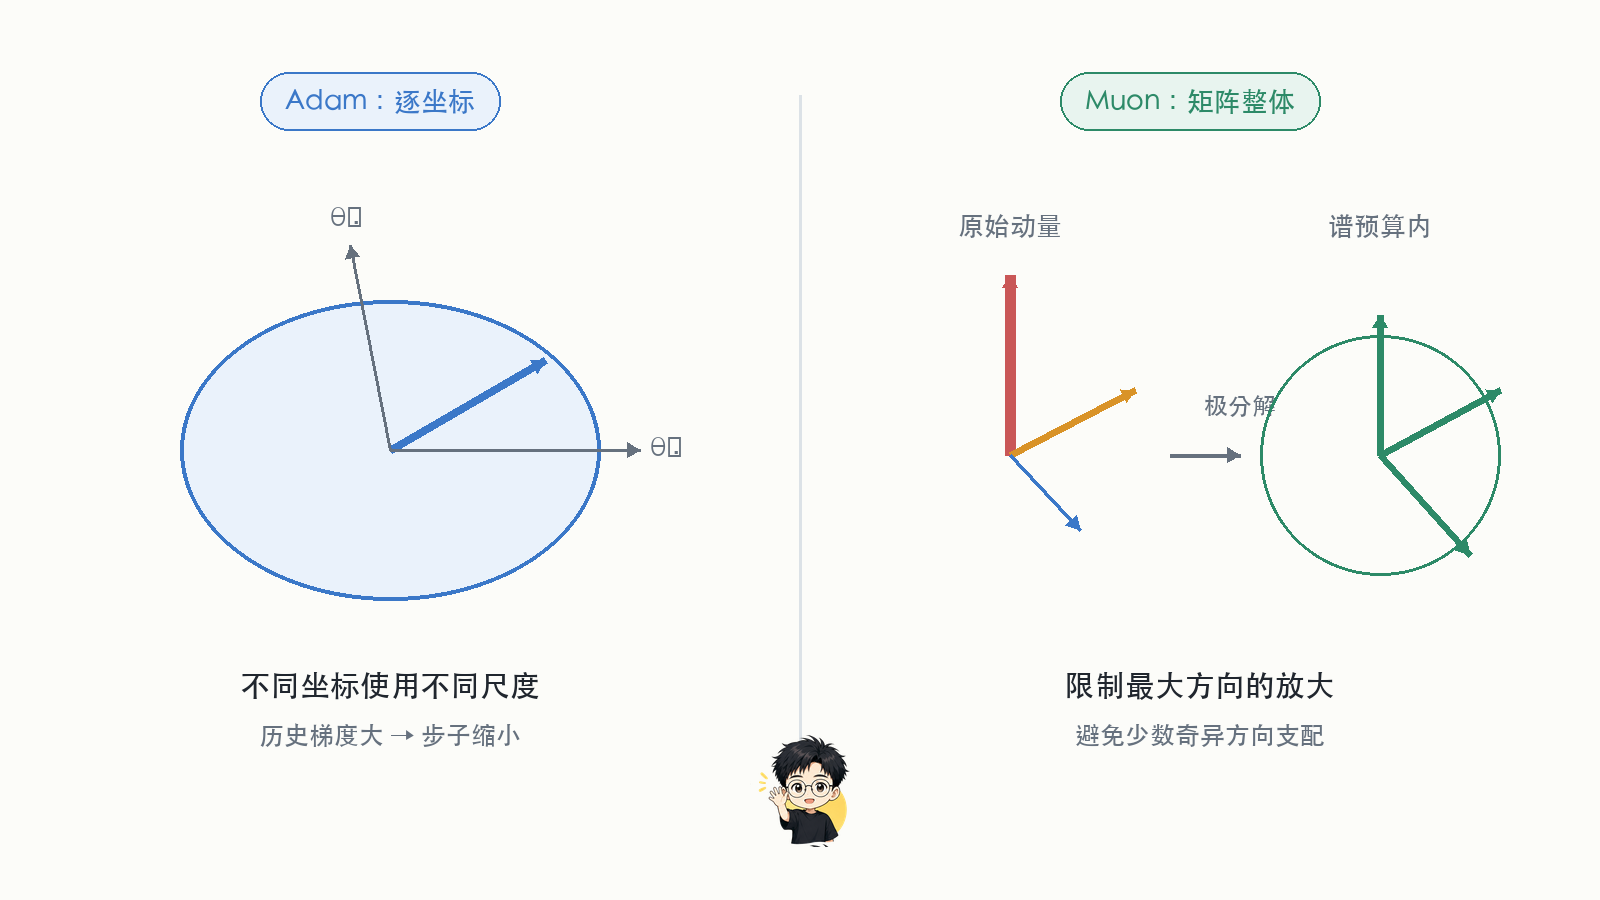
Muon 也可以放进“预算内最大下降”的框架。若把矩阵更新的风险预算写成谱范数约束:
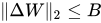
那么:
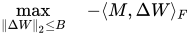
的一个最优方向就是:
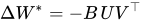
这里  是谱范数,也就是矩阵对任意单位输入方向能够产生的最大放大倍数;
 是矩阵的 Frobenius 内积。
这给出了比“做完正交化所以更均衡”更有因果顺序的解释:
- 先规定最大方向的放大不能超过预算;
- 再在这个约束下寻找预计下降最大的矩阵更新;
- 极分解方向
 因而自然出现;
- Muon 用便宜的迭代近似这个方向。
Muon 不是 Hessian 方法,也不能保证对所有参数都优于 AdamW。它的优势假设来自矩阵结构:当参数本身承担线性映射时,控制整个算子的方向比逐元素缩放更贴近这一层的作用。
5. 为什么不同层适合不同约束?
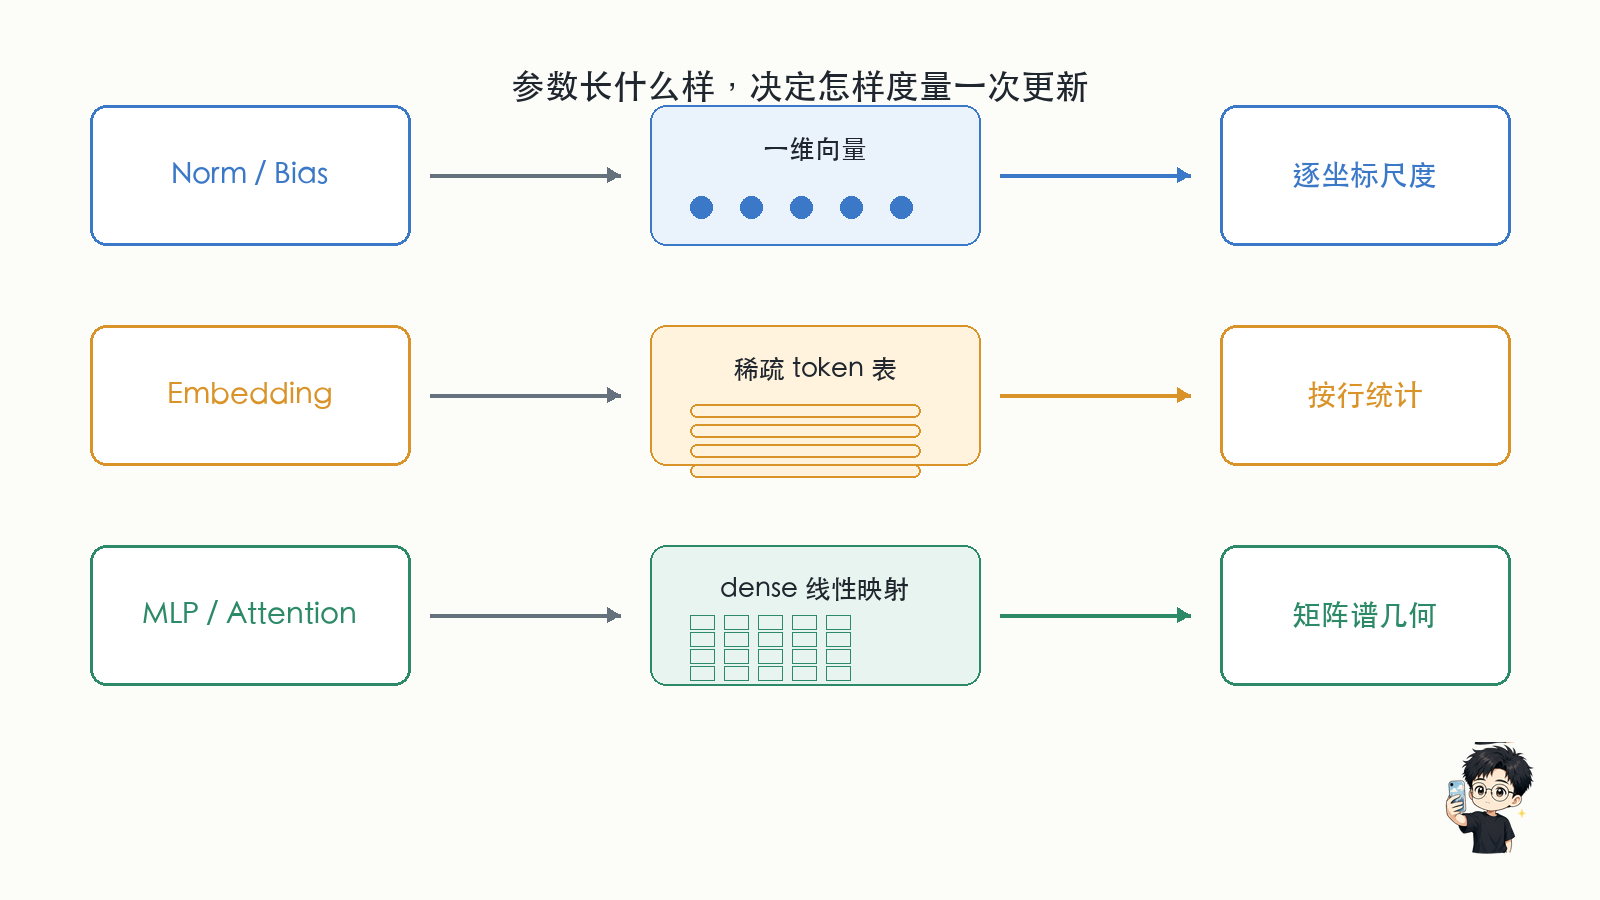
Norm 与 Bias
Norm 的 scale 和 bias 通常是 1D tensor,也就是由很多标量组成的一维向量,并不是“整个层只有一个参数”。
它们没有天然的二维矩阵子空间,也没有 token 行的稀疏访问模式。逐坐标自适应更新与这种结构比较匹配,因此实践中常继续交给 AdamW。
Embedding
Embedding 是一个表:

每一行对应一个 token。一个 batch 通常只访问少数行,而且 token 频率高度长尾。
把它完全当作独立坐标,会忽略一整行共同表示同一个 token;把它当作 dense linear map 做全矩阵正交化,又忽略了稀疏访问模式。因此值得研究的方向是 row-wise 更新:
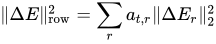
 可以结合行梯度尺度、访问频率、行范数漂移和低频 token 的统计置信度。
这是一条研究假设,不是已经得到证明的结论。
MLP 与 Attention
MLP 和 Attention 的二维权重直接实现表示空间之间的线性映射。这里的关键问题常常不是某个元素过大,而是某个输入方向被整体放大得过猛。
因此,矩阵谱几何和 Muon 的适配理由更充分。
| 参数块 | 主要结构 | 合法候选 geometry | 当前合理起点 |
|---|---|---|---|
| Norm / Bias | 一维向量 | coordinate | AdamW |
| Embedding / LM head | 稀疏 token 表或输出映射 | coordinate、row-column | 不预设 row-column 必胜 |
| MLP / Attention | dense 线性映射 | coordinate、spectral | Muon 类矩阵更新 |
| MoE Expert | 多个独立参数块 | coordinate、spectral、group | 分块自适应方法 |
6. 金融视角怎样统一 Adam 和 Muon?
现在可以把 Adam 与 Muon 放回同一张图里了。
统一它们的不是把参数硬说成资产,也不是在同一个矩阵上做线性混合:
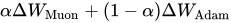
真正统一的是它们在回答同一个问题:
在给定的更新风险预算内,选择预计能让 loss 下降更多的方向。
Adam 使用逐坐标历史梯度尺度来塑造预算,为 coordinate geometry 生成候选方向;Muon 限制矩阵最危险方向的放大,为 spectral geometry 生成候选方向。两者不是谁把谁近似掉了,而是在不同参数结构上采用了不同的风险度量。
Embedding 还可能需要 row-column geometry。它是否优于 coordinate,必须由实验判断,不能只凭“Embedding 是二维矩阵”决定。
不过,只说“收益除以风险”仍然不够。要让这个统一视角变成可计算的准则,必须明确三个对象:
- 收益:某个候选更新预计能让 loss 下降多少;
- 风险:这个候选在不同 micro-batch 上是否稳定,是否存在明显坏尾部;
- 决策:当前参数块选哪种 geometry,以及最终走多远。
更现实的起点,是把模型拆成  个参数块。第
 个块的决策写成:

其中:
-
 是局部 geometry,例如 coordinate、row-column 或 spectral;
-
 是这个块本步的预算倍率。
如果 geometry 生成的单位候选方向是  ,那么局部更新为:
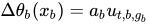
完整更新只是把不同参数块的更新拼回去:
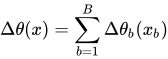
这个求和不是在同一个矩阵上混合 Adam 与 Muon。不同块拥有不同参数支撑:Norm/Bias 可以选 coordinate,Embedding 可以比较 coordinate 与 row-column,MLP/Attention 可以比较 coordinate 与 spectral。
局部收益:这个块的候选方向能降多少 loss?
对 micro-batch  ,第 个块在 geometry 下的一阶收益是:
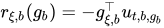
它大于零,表示该候选方向在这个 micro-batch 上预计降低 loss;小于零,则表示可能把 loss 推高。
局部平均收益和波动可以写成:
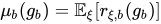
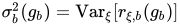
平均收益回答“通常能赚多少”,方差或坏尾部回答“这份收益是否可靠”。这时金融语言有了准确落点,但统计发生在参数块的候选更新上,不发生在单个参数坐标上。
有了这些局部定义,再看整个模型就很清楚了。对平均一阶收益,不必先估计完整跨块统计。利用期望的线性性:
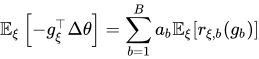
这一步严格成立。真正需要联合统计的是风险。例如组合收益方差包含:
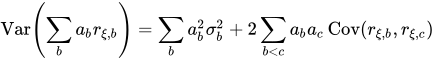
把所有参数块放进一个联合组合问题,可以保留这些跨块协方差与联合 CVaR,但在线训练需要保存和求解大量跨块统计。一个更现实的做法,是先保留严格可加的平均一阶收益,再分别评估局部风险与预算。
局部风险:不追求一个万能数字
这个统一框架可以为每个块同时观察几类便宜信号:
| 局部信号 | 它回答的问题 |
|---|---|
| micro-batch return | 候选方向的一阶 loss 下降是否稳定? |
| downside / CVaR proxy | 最差一小部分 micro-batch 是否明显亏损? |
| update-to-weight ratio | 本次更新相对参数是否过大? |
| activation/output drift | 应用更新后,这个块的行为是否突变? |
| spectral risk | 矩阵更新是否放大了少数危险方向? |
这些量不必全部变成一个精确概率模型。它们可以分别进入局部目标、约束或工程 guard。重要的是不要把 activation drift 硬叫成金融风险,也不要把奇异值集中度冒充收益协方差。
局部预算:收益高不等于可以无限加仓
例如,可以把一个候选更新的局部效用写成:
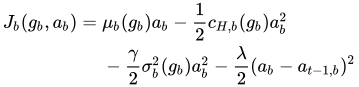
四项依次表示:预计收益、局部大步成本、收益波动和预算换手。局部约束还可以包含:

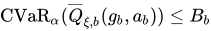

这不是要求优化器每步精确求解上述所有公式。它首先给出一张设计图:每个启发式打分或 guard,都应该能对应到局部收益、下行风险、更新尺度或函数稳定性中的一个对象。
到这里,我们仍然只是在建立一个通用的收益-风险评价框架,还没有要求必须发明一个新的优化器。
7. 由此引出 FARO:让优化器选择更新几何
现在才轮到 FARO 出场。
如果 coordinate、row-column 和 spectral 都只是候选更新几何,那么下一个自然问题就是:能不能不把规则永久写死,而是让优化器根据刚才定义的收益、风险与预算信号,自己决定当前参数块使用哪一种?
这就是 FARO 的出发点:
FARO:Function-space Adaptive Return-to-Risk Optimizer,在结构合法的候选更新之间进行统一的收益-风险审查,再选择 geometry 与预算。
这里的 Function-space 表示除了参数变化,还观察 activation 或 output drift,避免“参数步子不大,模型行为却突然改变”。具体设计留到第三篇展开。
在按参数块做局部决策的 Factorized 版本中,它求解的是:
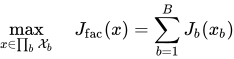
这里“Factorized”不是宣称各层永远独立。平均一阶收益本来就严格按块相加;局部可分离近似针对的是曲率、收益协方差、联合尾部风险、函数漂移和共享预算等剩余部分。
主流 AdamW + Muon 是固定策略的特例
常见大模型训练已经在按参数类型混合优化器:MLP、Attention 的稠密矩阵使用 Muon,Embedding、LM head、Norm 和 Bias 使用 AdamW。用 表示第 个参数块的 geometry,可以写成:
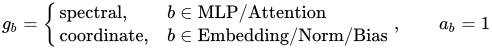
这里的  表示不再额外调整各候选方向自己的基础学习率,并不表示 AdamW 与 Muon 使用相同数值学习率。
因此,固定 AdamW + Muon 可以看成 FARO 的固定路由、固定预算特例。FARO 往前多走一步:让候选 geometry 接受同一套收益-风险评价,再决定是否保留人工规则。
这套主流配方是重要的工程先例,但不是完整理论证明。目前没有定理证明“这些层必须用 Muon、那些层必须用 AdamW”,更没有证明这个固定划分对整个非凸网络全局最优。
层之间相互作用,为什么还能分块评价?
每个参数块的梯度都来自同一个全局 loss:
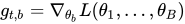
反向传播已经把整张计算图在当前位置的影响传进  。对本次更新,一阶 loss 变化严格满足:
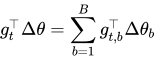
所以,给定当前全局梯度和已经分配的局部预算,平均一阶收益本来就按块相加。Factorized FARO 分解的是这个条件下的更新选择,不是把神经网络拆成彼此无关的层。
需要近似处理的是一阶平均收益之外的部分:跨块曲率、收益协方差、联合 CVaR、函数漂移与共享总预算。第三篇会定义具体方法,第五篇再把严格成立的部分与残差假设完整证明出来。
如果 Attention 的 Q/K、共享权重或相邻层存在明显耦合,就不应该强行逐块决策,而应把相关块合并成 Group FARO,在组内联合评估、组间继续分解。
这就形成三层连续谱:
- 完整联合 FARO 最完整,但统计和求解最贵;
- Group FARO 保留关键耦合,成本居中;
- Factorized FARO 最便宜,适合在线训练和并行执行。
这三层也可以直接理解成 FARO 的三种决策模式:
| FARO 模式 | 一次联合决策覆盖什么 | 适用情况 | 当前状态 |
|---|---|---|---|
| Block / Factorized | 一个参数块 | 一阶方向天然可分,且剩余耦合相对 route margin 可控 | 当前工程实现 |
| Group | 一组强耦合参数块 | Q/K、共享权重、同层 MLP 等局部耦合明显 | 后续升级方向 |
| Global | 全模型所有参数块 | 统计样本和计算资源足够,希望完整考虑跨块关系 | 理论模式,未实现 |
所以 FARO 并不是永远坚持“每层各算各的”。它允许根据耦合强度逐步扩大联合决策范围。只是对当前大模型在线训练而言,Block / Factorized 模式最容易并行、统计量最可靠,也最符合显存和吞吐约束,因此目前采用的是这一种最实际的实现。
第三篇会把这个局部决策写成完整方法;第五篇区分一阶方向的严格分解与完整收益-风险问题的残差条件,并构成整个系列的理论核心;第六篇则回到 GPU 代码,看工程版本如何用局部打分、预算 guard 和 explore→freeze 近似这套设计。
小结
这一篇最重要的结论是:
Adam 与 Muon 都可以理解成“在风险预算内争取更大的预计 loss 下降”,但两者使用的风险度量不同:Adam 按参数坐标控制历史梯度尺度,Muon 按矩阵整体控制最危险的谱方向。
这解释了为什么它们不是简单的竞争关系,也解释了为什么 Norm、Embedding、MLP 和 Attention 未必适合相同的更新几何。
FARO 是这个统一视角自然导出的下一步:让 coordinate、row-column 和 spectral 候选接受同一套收益-风险评价,再自适应选择 geometry 与预算。第三篇从这里开始正式定义方法,第五篇再处理分块决策的严格理论。
参考资料
- Diederik P. Kingma, Jimmy Ba, Adam: A Method for Stochastic Optimization
- Ilya Loshchilov, Frank Hutter, Decoupled Weight Decay Regularization
- Harry Markowitz, Portfolio Selection
- William F. Sharpe, The Sharpe Ratio
- R. Tyrrell Rockafellar, Stanislav Uryasev, Optimization of Conditional Value-at-Risk
- Nicolae Gârleanu, Lasse Heje Pedersen, Dynamic Trading with Predictable Returns and Transaction Costs
- Keller Jordan, Muon: An optimizer for hidden layers in neural networks
- Muon GitHub: KellerJordan/Muon
- SciPy User Guide, Optimization and root finding (scipy.optimize)
- SciPy API Reference, scipy.optimiz