
强化学习小白理解GRPO(四):从 Advantage 加权到分布重塑,SFT、RL 和OPD原来是一家人
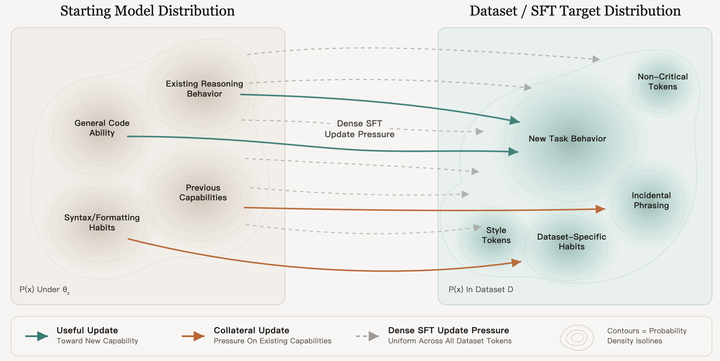
最近一篇文章 SFT, RL, and On-Policy Distillation Through a Distributional Lens 很火。它试图用一个统一的“分布视角”,解释监督微调(Supervised Fine-Tuning,SFT)、强化学习(Reinforcement Learning,RL)和策略内蒸馏(On-Policy Di...
Read article
Column
从直觉、代码和实践出发,记录强化学习与 GRPO 的学习笔记。
最近一篇文章 SFT, RL, and On-Policy Distillation Through a Distributional Lens 很火。它试图用一个统一的“分布视角”,解释监督微调(Supervised Fine-Tuning,SFT)、强化学习(Reinforcement Learning,RL)和策略内蒸馏(On-Policy Di...
Read article
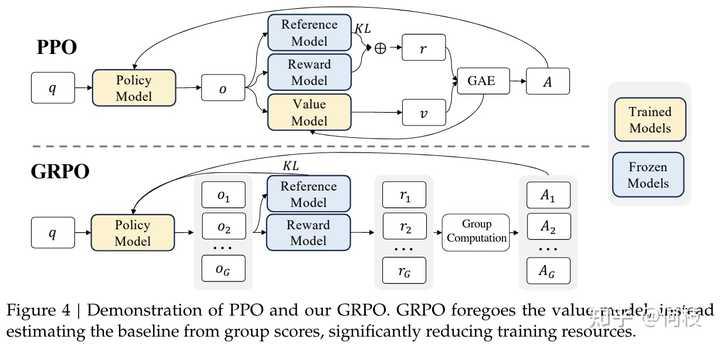
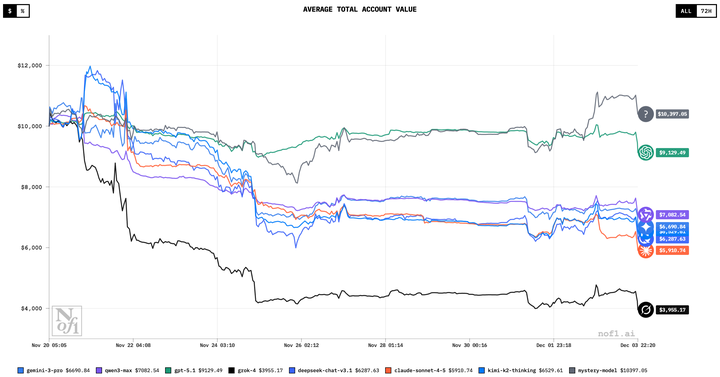
唉。。。因为很多事情鸽了很久的第三篇来了,年初前两篇受到很多同学的赞同和好评,这一年大家对于GRPO和强化学习也基本都是很熟悉,各种变体DAPO/VAPO/GSPO等层出不穷,是今年工业界和学术界的“显学“了。这篇就给出第二篇中提出的任务吧,虽然对于技术人员并不难,但是可以作为技术小白的入门。1.任务说明我们的想法时根据一家公司过去5天的新闻,来判断该...
Read article
系列文章更新中。。。wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践20251203难产的第三篇虽迟但到orz: 强化学习小白理解GRPO(三):适配自定义任务,以Finance-R1为例强化学习小白理解GRPO(四):从 Ad...
Read article
20260817第四篇已更新:wuxiaojun:强化学习小白理解GRPO(一):Deepseek R1和Qwen QwQ的制胜秘诀wuxiaojun:强化学习小白理解GRPO(二):GRPO核心代码实践强化学习小白理解GRPO(四):从 Advantage 加权到分布重塑,SFT、RL 和OPD原来是一家人最近Deepseek-R1-Zero和Dee...
Read article© 2025 Xiaojun Wu. All rights reserved. Powered by Jekyll and Minimal Light theme.