
运筹优化更像是在回答“怎么分配才最优”,微分方程更像是在回答“系统会怎么演化”。
这两条线在数学建模里经常并排出现:一条处理决策,一条处理动态。
这一篇先不碰复杂模型,只做一件事:
假设药物进入身体后会按比例慢慢减少,怎么用 Python 算出接下来 10 小时的浓度曲线?
这个问题足够小,但已经包含了微分方程建模的完整闭环:
建模 - 求解 - 画图 - 解释。
0. 先记一句人话
微分方程先别急着背定义,它最朴素的意思是:现在有多少,下一瞬间会怎么变。
- 药在体内会慢慢少
- 水温会慢慢降
- 人群里感染者会带来新增感染
这些都是“量随时间变化”的问题。微分方程做的事,就是把这种变化写成可以计算的规则。
这一节的 takeaway:微分方程的入口不是定义,而是“我关心的量会怎么随时间变”。
1. 先看问题,再看变化率
写微分方程模型时,先问四个很普通的问题:
- 我盯的是哪个量
- 它是在变大还是变小
- 变化受什么因素影响
- 一开始从哪里出发
常微分方程的英文是 ordinary differential equation,所以很多资料会把它简称为 ODE。
这个名字不用先背,它只是强调一件事:我们只沿着一个自变量变化,最常见的自变量就是时间 t。
一般可以写成:
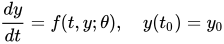
这行公式对应上面的四个问题:
-
y:我盯着的量 -
dy/dt:它此刻变快还是变慢 -
theta:影响变化的参数 -
y(t0)=y0:从哪个初始状态出发
其中 y 不一定只是一个数,更多时候是一个向量。
所以在 Python 里,即使只有一个方程,也建议把状态写成数组,这样后面扩展成方程组会更自然。
这一节的 takeaway:先说清“量、速度、参数、初值”,再写公式。
2. 怎么让电脑一步步往前算
当方程没法直接手算时,就让电脑按时间一点点往前推。solve_ivp 做的就是这件事。
先把函数名拆开:
-
solve:求解 -
ivp:initial value problem,初值问题
所以 solve_ivp 的人话版本就是:
给我起点和变化速度,我帮你把后面的轨迹算出来。
常见的几个参数先记住就够了:
-
t_span:从什么时候算到什么时候 -
y0:一开始的状态 -
t_eval:希望在哪些时间点看到结果,可以先理解成“拍照点” -
method:内部怎么一步步走,默认常用RK45 -
dense_output=True:如果想在任意时间点查询平滑结果,可以打开连续插值
RK45 这个名字第一篇不需要展开太深。
现在只要先记住:它会试着往前走一小步,并估计这一步准不准。
如果系统里有的量变化极快、有的量变化很慢,就可能遇到“刚性”问题。Radau 和 BDF 是这类场景常用的方法名,第一篇只需要知道它们存在,第三篇以后再慢慢拆。
这一节的 takeaway:solve_ivp 的核心输入是“起点”和“变化速度”,t_eval 只是你想看结果的位置。
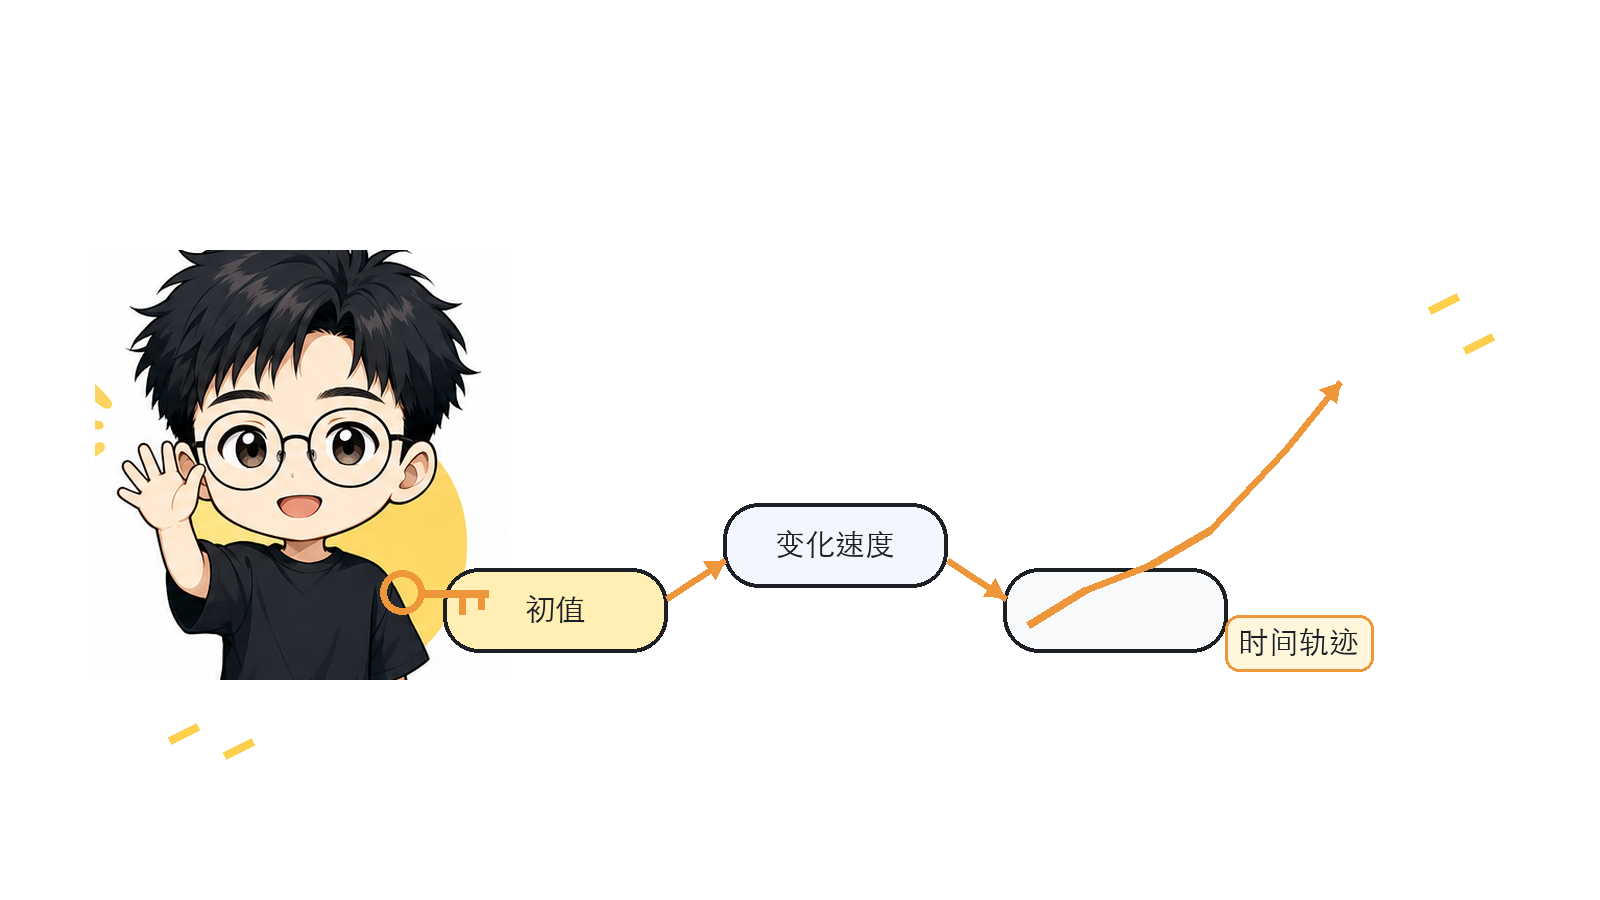
这张解释图对应这一篇的主线:从“初值”出发,沿着“变化速度”一步步得到“时间轨迹”。
3. 例子一:指数衰减
先看最简单的模型:
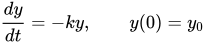
这可以对应药物浓度衰减、放射性衰变,或者某些简化的温差衰减过程。
你可以把它理解成一句话:每一时刻,剩下的量都按当前量的一定比例继续减少。
它的解析解是
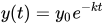
这里我先用 SymPy 验一下公式,再用 solve_ivp 数值求解:
# 对应本节的理论方程:dy/dt = -k y
from sympy import Eq, Function, dsolve, symbols

# t 是自变量,k 是衰减系数,y0 是初值
t, k, y0 = symbols("t k y0", positive=True)
y = Function("y")

# 直接对照理论公式 y(0)=y0
print(dsolve(Eq(y(t).diff(t), -k * y(t)), y(t), ics={y(0): y0}))
数值解写成这样:
import numpy as np
from scipy.integrate import solve_ivp

# 对应理论里的参数 k 和初值 y(0)=y0
k = 0.35
y0 = 100.0
t_eval = np.linspace(0, 10, 200)

# 右端项对应 dy/dt = -k y
def rhs(t, y):
    return [-k * y[0]]

# solve_ivp 对应“初值问题数值求解”
sol = solve_ivp(
    rhs,
    (t_eval[0], t_eval[-1]),
    [y0],
    t_eval=t_eval,
    method="RK45",
)

# 用解析解做误差对照,检查数值解是否合理
y_exact = y0 * np.exp(-k * t_eval)
实际脚本里还会检查 sol.success。
它的人话含义是:求解器自己有没有承认这次求解成功完成。
这类问题很适合做第一篇,因为读者能一眼看出曲线应当往哪儿走。
如果数值解和解析解都对得上,就说明你的建模、编码、求解器调用都没跑偏。
这一节的 takeaway:指数衰减是最小可用例子,因为它既能手算公式,也能检验数值结果。
4. 例子二:Logistic 增长
第二个模型稍微像一点“真实世界”:
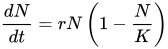
这里 N 是种群规模,r 是增长率,K 是环境容量。
前期增长快,后期会被容量限制压住,最后趋于稳定。
import numpy as np
from scipy.integrate import solve_ivp

# 对应理论里的增长率 r、容量 K、初值 N0
r = 0.8
K = 100.0
N0 = 8.0
t_eval = np.linspace(0, 20, 200)

# 右端项对应 dN/dt = rN(1 - N/K)
def logistic_rhs(t, y):
    return [r * y[0] * (1 - y[0] / K)]

# 同样是初值问题,使用 solve_ivp 数值积分
sol = solve_ivp(
    logistic_rhs,
    (t_eval[0], t_eval[-1]),
    [N0],
    t_eval=t_eval,
    method="RK45",
)
这个例子比指数衰减更像建模,因为它开始涉及“增长”和“约束”之间的平衡。
后面写传染病模型、资源竞争模型、舆情传播模型时,思路基本都能沿着这条线展开。
如果只记一个判断,Logistic 的直觉就是:前面长得快,后面被环境压住。
这一节的 takeaway:Logistic 把“自然增长”和“资源限制”放进同一个变化率里。
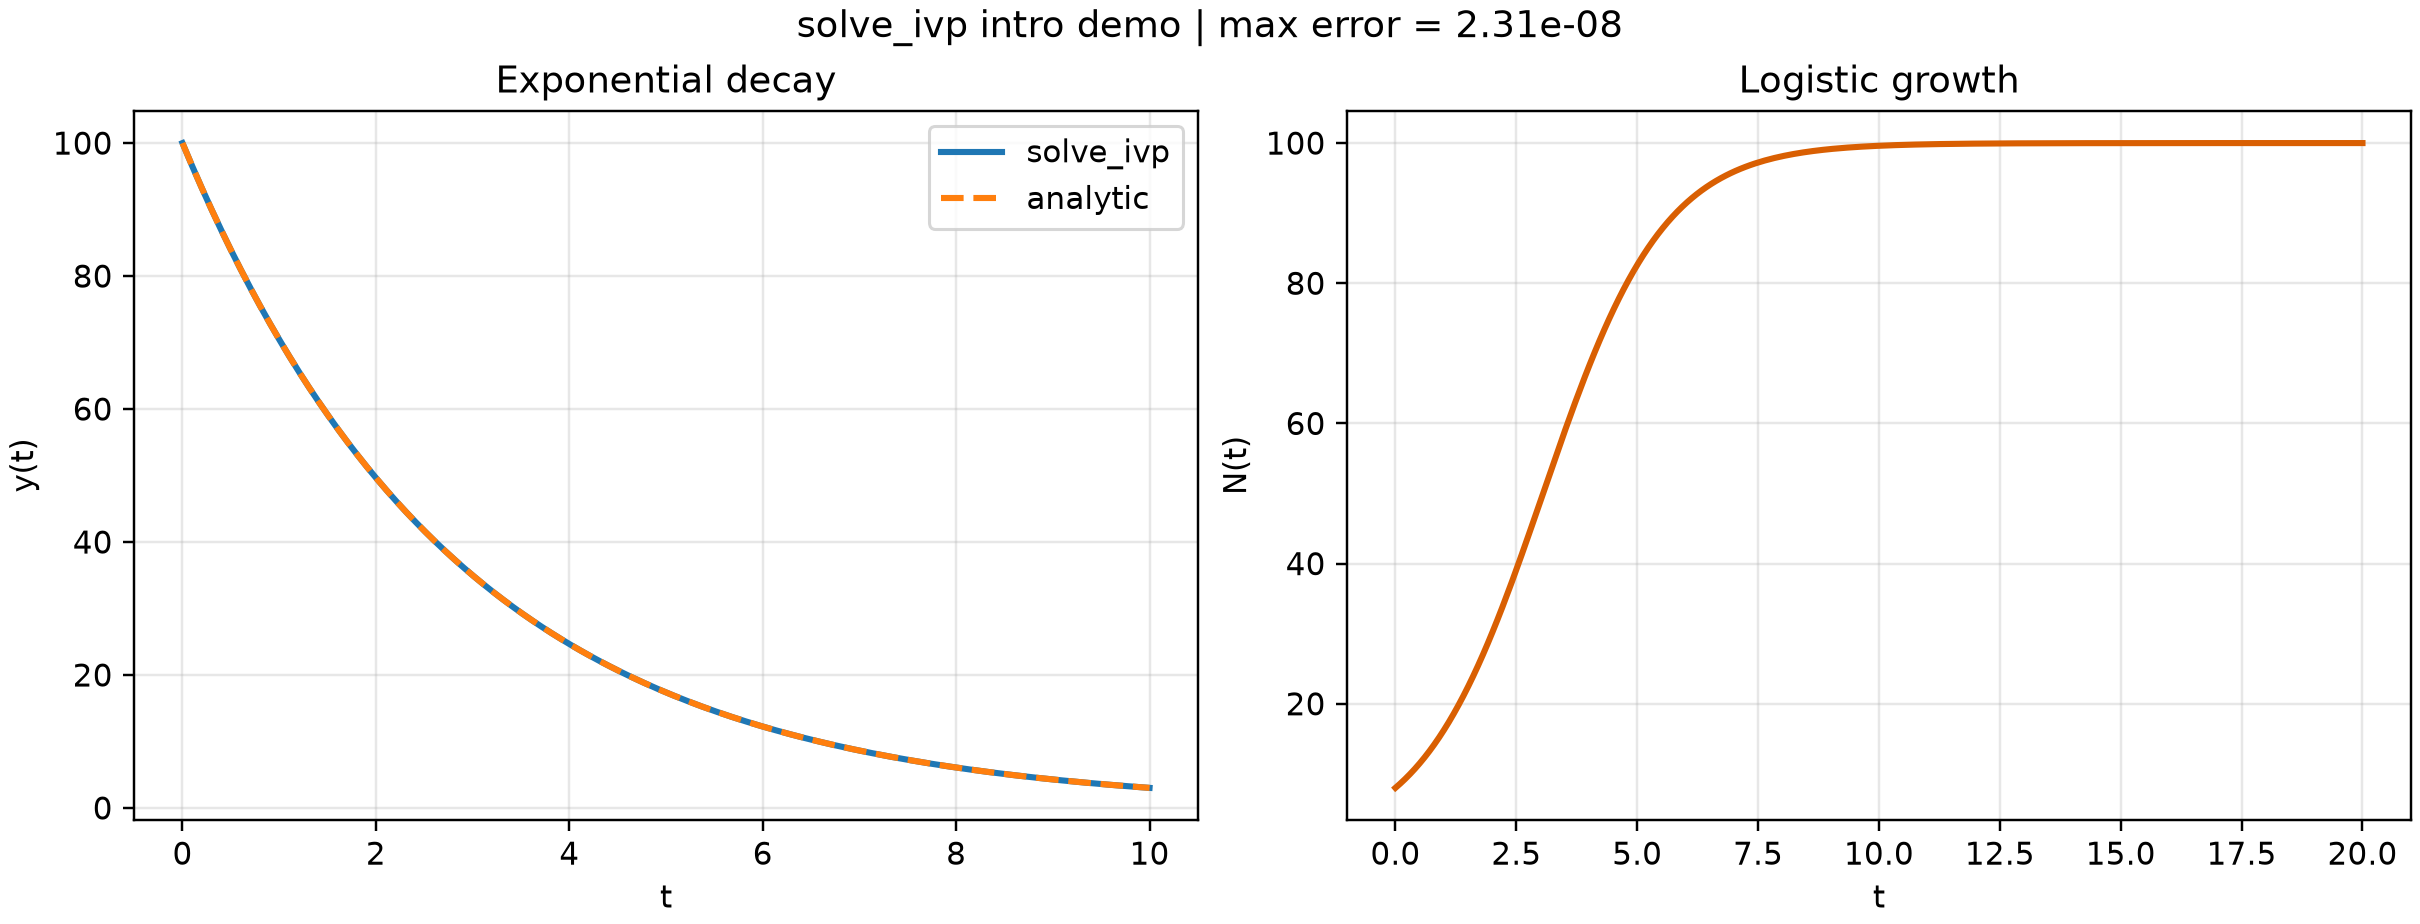
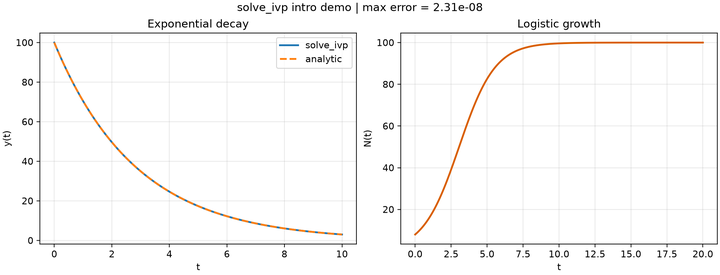
图里左边是指数衰减的数值解和解析解对照,右边是 Logistic 增长曲线。
这张图的作用很朴素:一眼看出 solve_ivp 的结果有没有跑偏。
5. 一个可复用的模板
以后写 ODE 题,基本都可以按这个骨架走:
# 通用导入:数值积分 + 时间网格 + 画图
from scipy.integrate import solve_ivp
import numpy as np
import matplotlib.pyplot as plt

# model_rhs 对应正文中的 f(t, y; theta)
def model_rhs(t, y, params):
    ...

# t_eval 对应我们要输出结果的离散时间点
t_eval = np.linspace(t0, t1, 200)

# y0 对应初值;solve_ivp 对应数值求解器
sol = solve_ivp(
    lambda t, y: model_rhs(t, y, params),
    (t0, t1),
    y0,
    t_eval=t_eval,
    method="RK45",
)

plt.plot(sol.t, sol.y[0])
plt.show()
要记住的一点是:solve_ivp 给你的不是“公式”,而是“沿时间点的状态序列”。
这正是建模里最常见的输出形式。
这一节的 takeaway:以后换模型,通常只需要换右端函数、参数和初值。
6. 三个小习惯
- 先写清变量单位和初始条件
- 先说明为什么选这个求解器
- 尽量和解析解、极限情形或直觉做一次对照
- 记得看
sol.success,不要默认求解器一定成功
这一节的 takeaway:教程先给读者一个能站稳的例子,再逐步加术语。
7. 小结
这一篇的目标很单纯:把 solve_ivp 跑通,并把常微分方程,也就是 ODE,建模的基本流程立住。
下一篇我会接着写经典的 SIR 传染病模型,把“单方程”升级成“方程组”,也顺手把参数含义、峰值解释和疫情曲线一起讲清楚。